
群机器人让所有人都看到告警,却不指定由谁处理。自查方法很简单。抽查最近 10 条关键告警,看能否查到负责人、认领时间和关闭记录。完整的自查清单在文末。
很多团队的告警治理从一个群机器人开始。接入成本低,几分钟即可完成。Prometheus、Zabbix、Nightingale、云监控和自研脚本的告警,都能推到企业微信、飞书或钉钉群。对刚开始补监控的团队,这一步有价值:告警不再停留在无人登录的控制台里。
问题随之出现。群消息一多,所有人都看到了,却没人确定自己是否应该处理。值班人员以为业务负责人会看,业务负责人以为运维组已在排查,运维组以为这是应用问题。十几分钟后,有人在群里问“这个谁在处理”,大家才开始补认领、补截图、补上下文。
这时通知已经送达,失败的是响应。
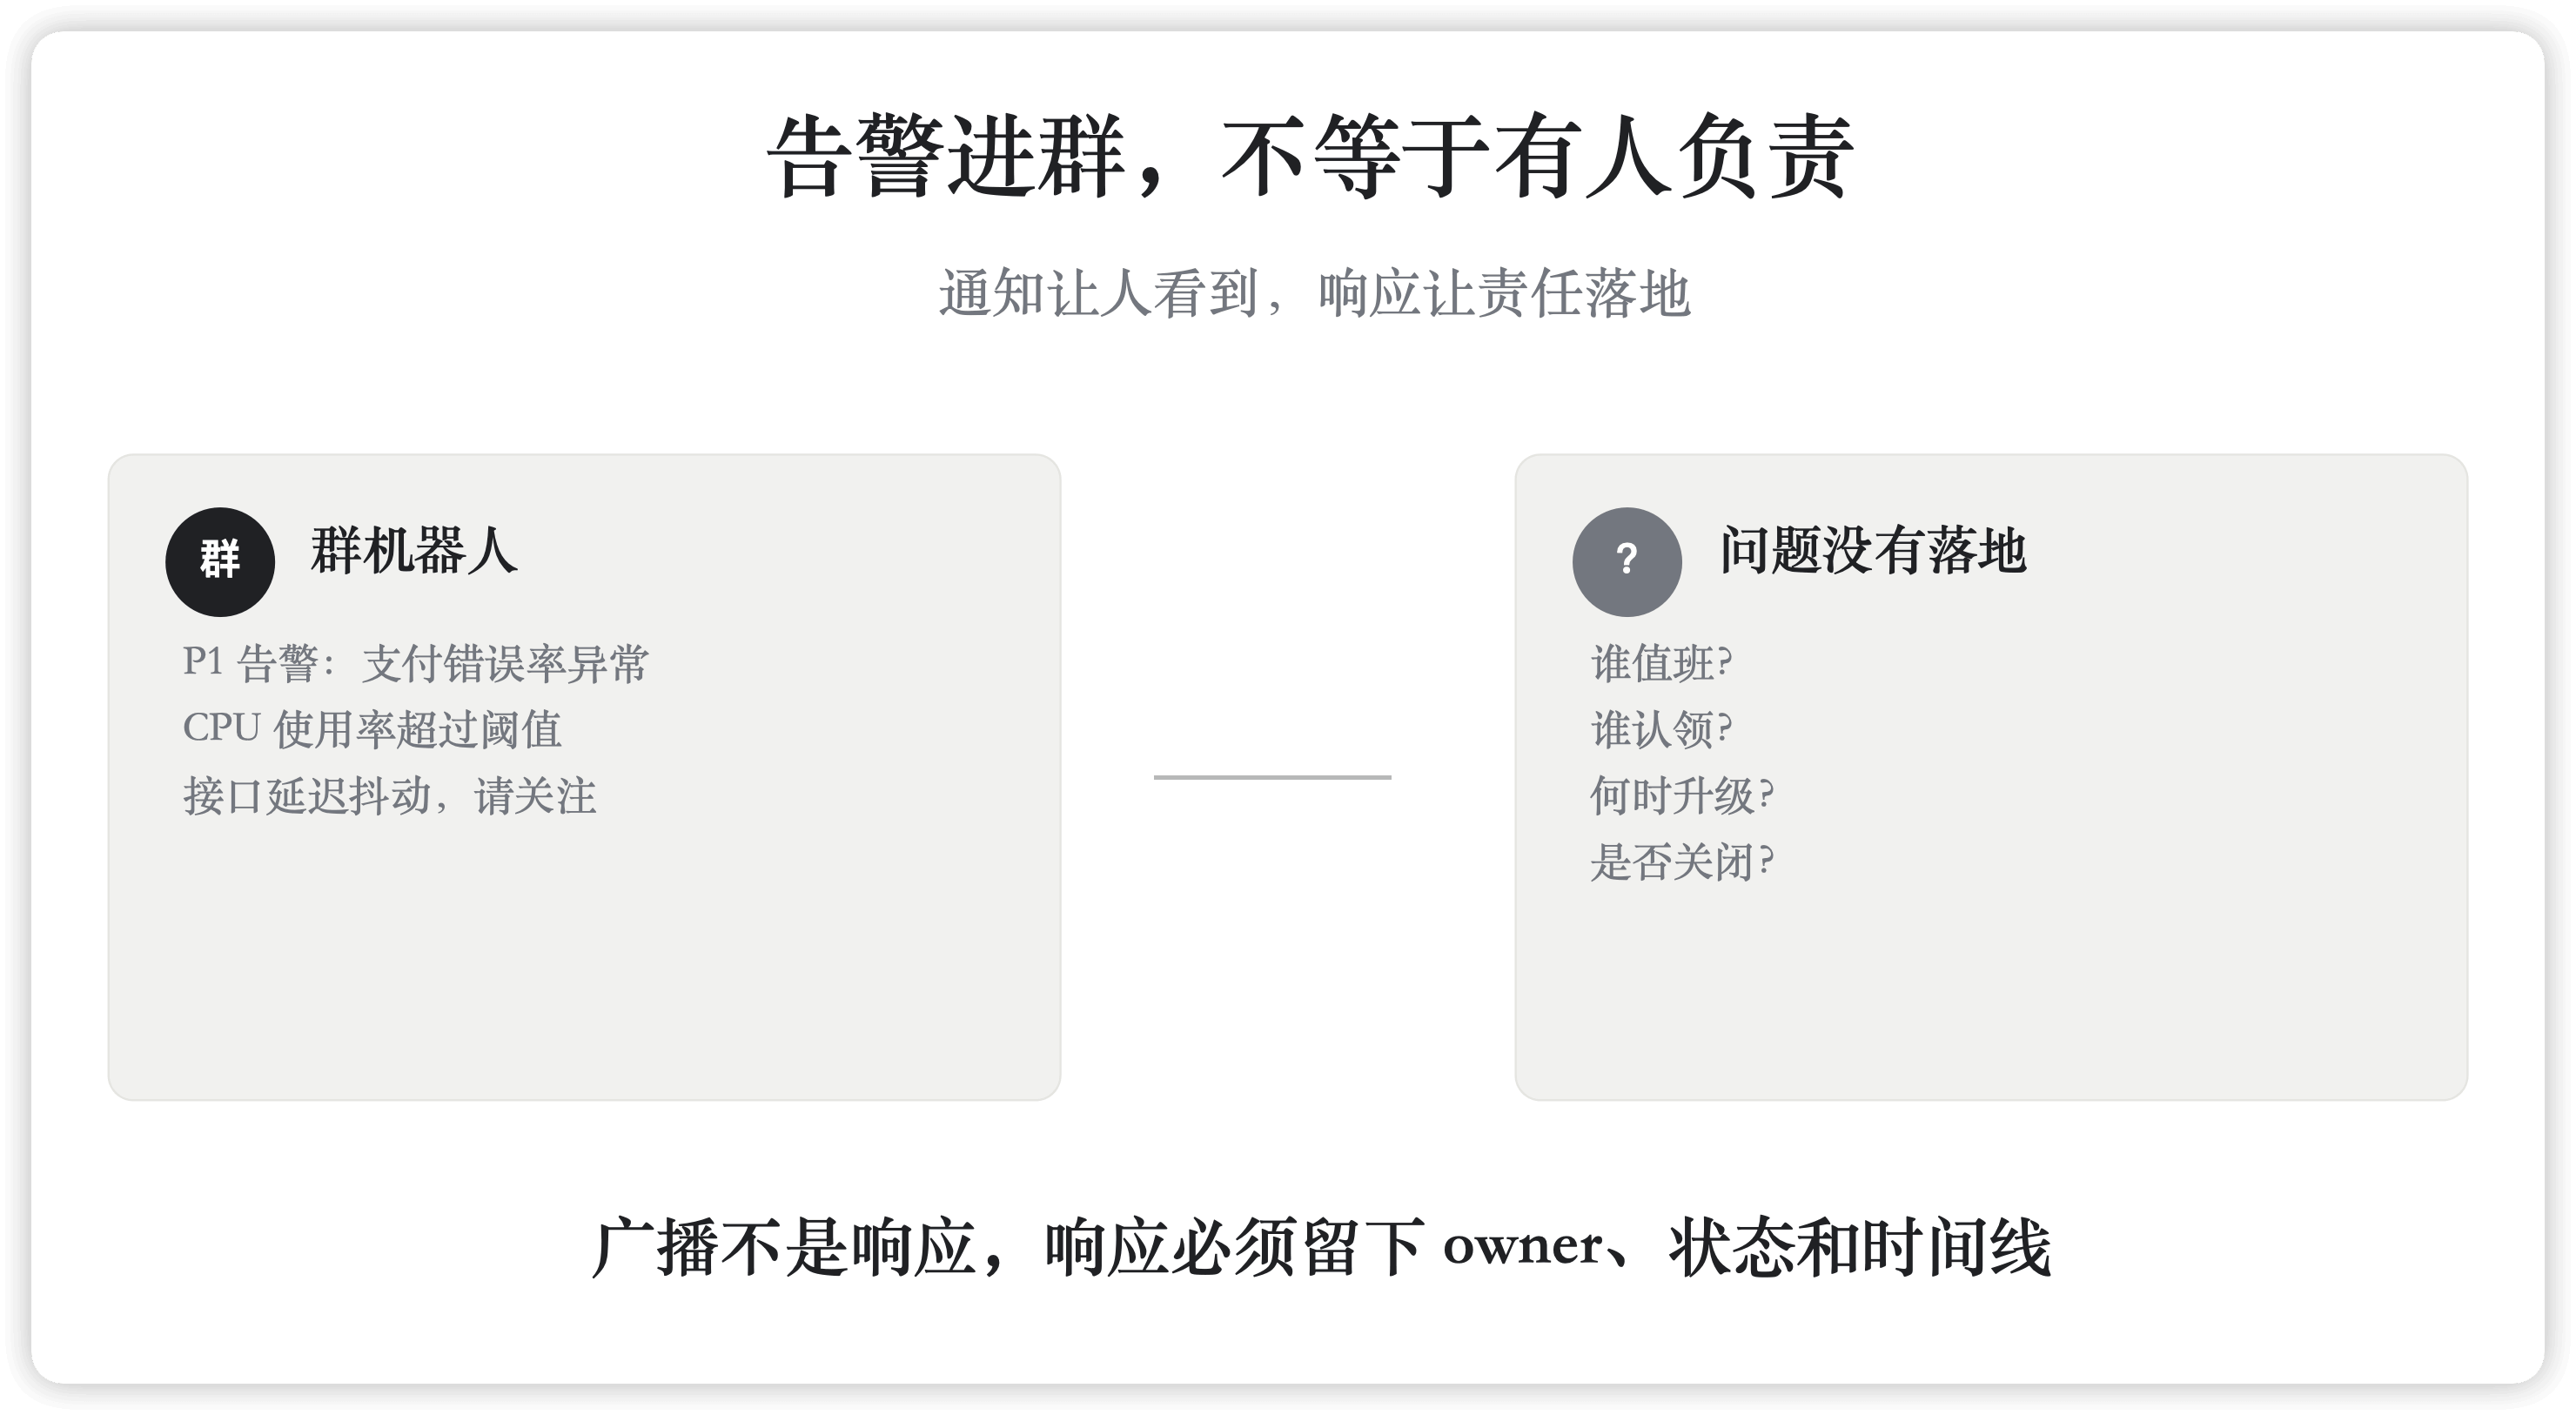
群消息带来可见性,但不分配责任
IM 群机器人把告警从监控系统搬到团队每天查看的地方。它降低了接入门槛,也让信息更透明。但它回答不了几个关键问题:
- 现在谁值班?
- 这条告警归谁?
- 有没有人认领?
- 多久无人响应就升级?
- 处理完由谁关闭?
- 事后是否复盘?同类问题下次能否少响?
这些问题没有答案时,群里越热闹,现场越混乱。
Google SRE 在监控章节中说明了告警打扰人的理由。系统出了问题,需要有人立即调查、缓解并查明原因。频繁的低质量告警会让人开始略读,甚至忽略重要的页面。IBM 对告警疲劳(alert fatigue)的定义指向同样的结果。大量低优先级、误报或无法处理的通知,会造成精神和操作上的疲劳。疲劳最终拖慢响应。
因此,告警治理的第一条标准是:这条告警能否推动一个明确的人采取行动。也就是说,告警必须可处理(actionable),并且有明确的负责人。如果 P1 告警和低价值提醒在群里外观相近,轻重只能凭感觉判断。这时系统只是在广播,没有在响应。
一次响应要经过五个环节
关键告警进入团队视野后,至少还要经过以下环节:
| 环节 | 要做的事 | 要留下的记录 |
|---|---|---|
| 降噪 | 合并重复告警、派生告警和同一故障的多源告警 | 原始告警与故障的关联 |
| 分派 | 把告警送到对应的服务、团队或协作空间,而非默认的大群 | 负责团队 |
| 触达与升级 | 找到此刻应响应的人;超时未认领时,升级到二线、负责人或相关团队 | 通知与升级记录 |
| 认领、处理、关闭 | 在系统中记录状态,而非在群里回复“我看下”或“好了” | 处理人、时间、关闭原因 |
| 复盘与治理 | 整理时间线、聊天记录、工单和后续动作 | 复盘结论与改进项 |
触达环节最容易出问题。值班人员可能在上班,也可能在夜间或假期中。渠道可能是 IM,也可能需要电话或短信。
复盘环节依赖前面留下的记录。Atlassian 的复盘资料提到,好的事后复盘(postmortem)需要一致的问题框架和足够细的数据。时间线、聊天记录、工单和后续动作也必须齐备。这些材料很难在故障结束后凭记忆补齐,应在响应过程中自然留下。
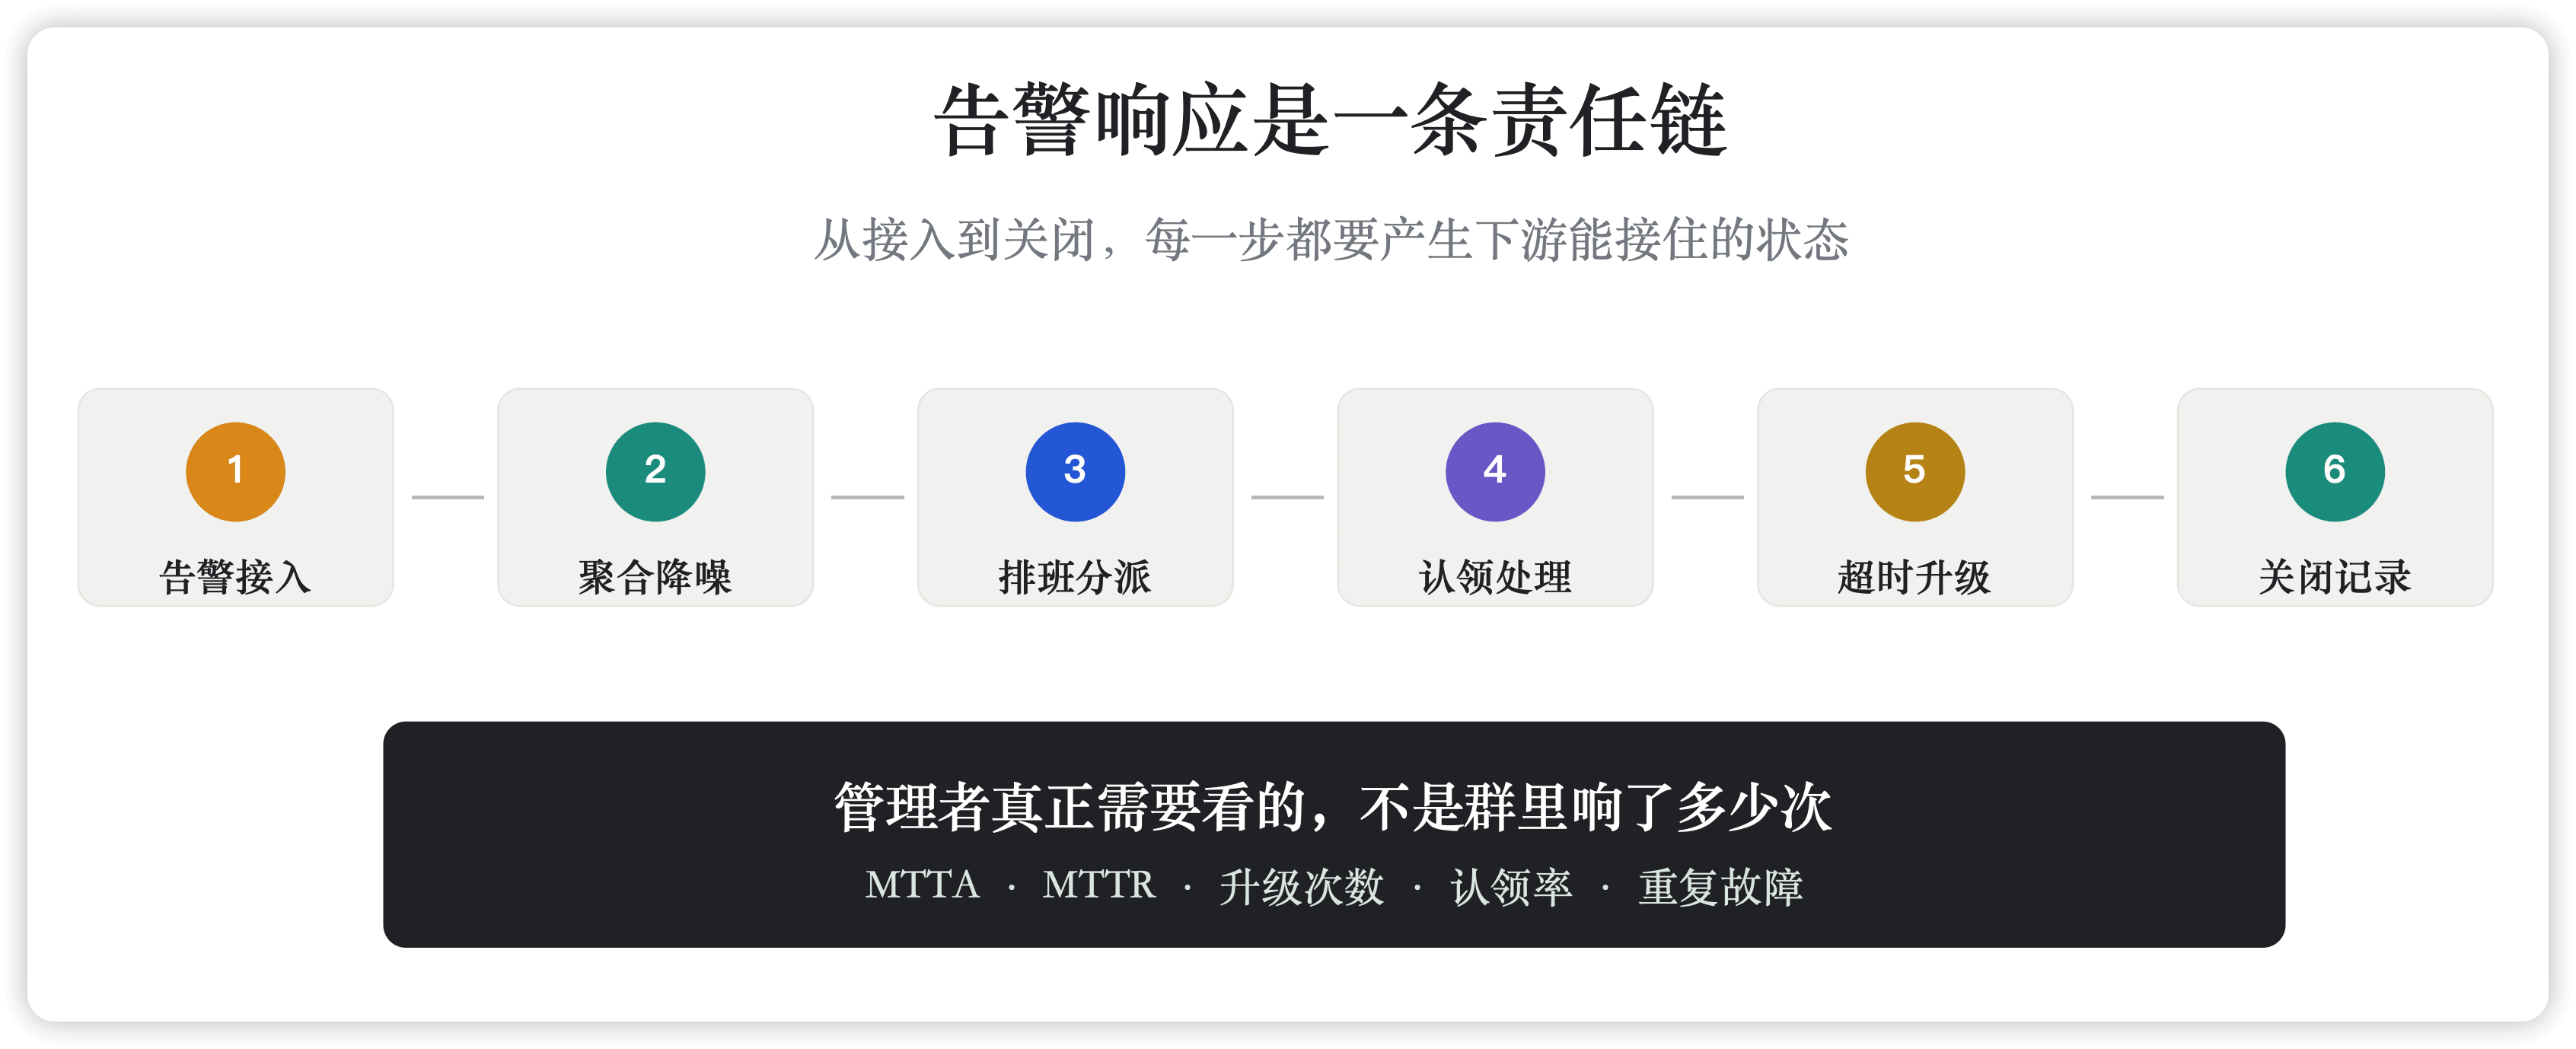
负责人应衡量响应过程是否在改进
运维、SRE 和平台负责人衡量告警,不应只看群里今天响了多少次。响铃次数只说明监控系统很忙,不说明团队响应得更好。
更有价值的问题包括:
- 关键告警平均多久被认领?
- 哪些团队经常超时?
- 哪些服务反复触发同类告警?
- 哪些告警最终被判定为无效?
- 哪些故障发生过升级,原因是什么?
- 复盘之后,阈值、配置、Runbook 或架构有没有变化?
前两项是平均认领时间(MTTA)和平均恢复时间(MTTR)。其余是升级路径、重复故障、无效告警比例和复盘完成情况。这些指标并不完美,但能改变讨论的问题。讨论不再是“大家有没有看到”,而是“团队是否更快、更稳、更可追踪”。
仅靠群机器人,很难回答这些问题。群聊适合讨论,不适合保存结构化状态。消息会被表情、闲聊、截图和转发淹没。值班表放在别处,升级规则靠人记忆,关闭状态靠口头同步。管理层问起上周的故障卡在哪里,团队只能翻聊天记录。
所以很多团队会从 IM 群走向 On-call 体系。群仍然有用,但它只能做协作界面,不能做责任系统。
On-call 平台把“看到”变成“负责”
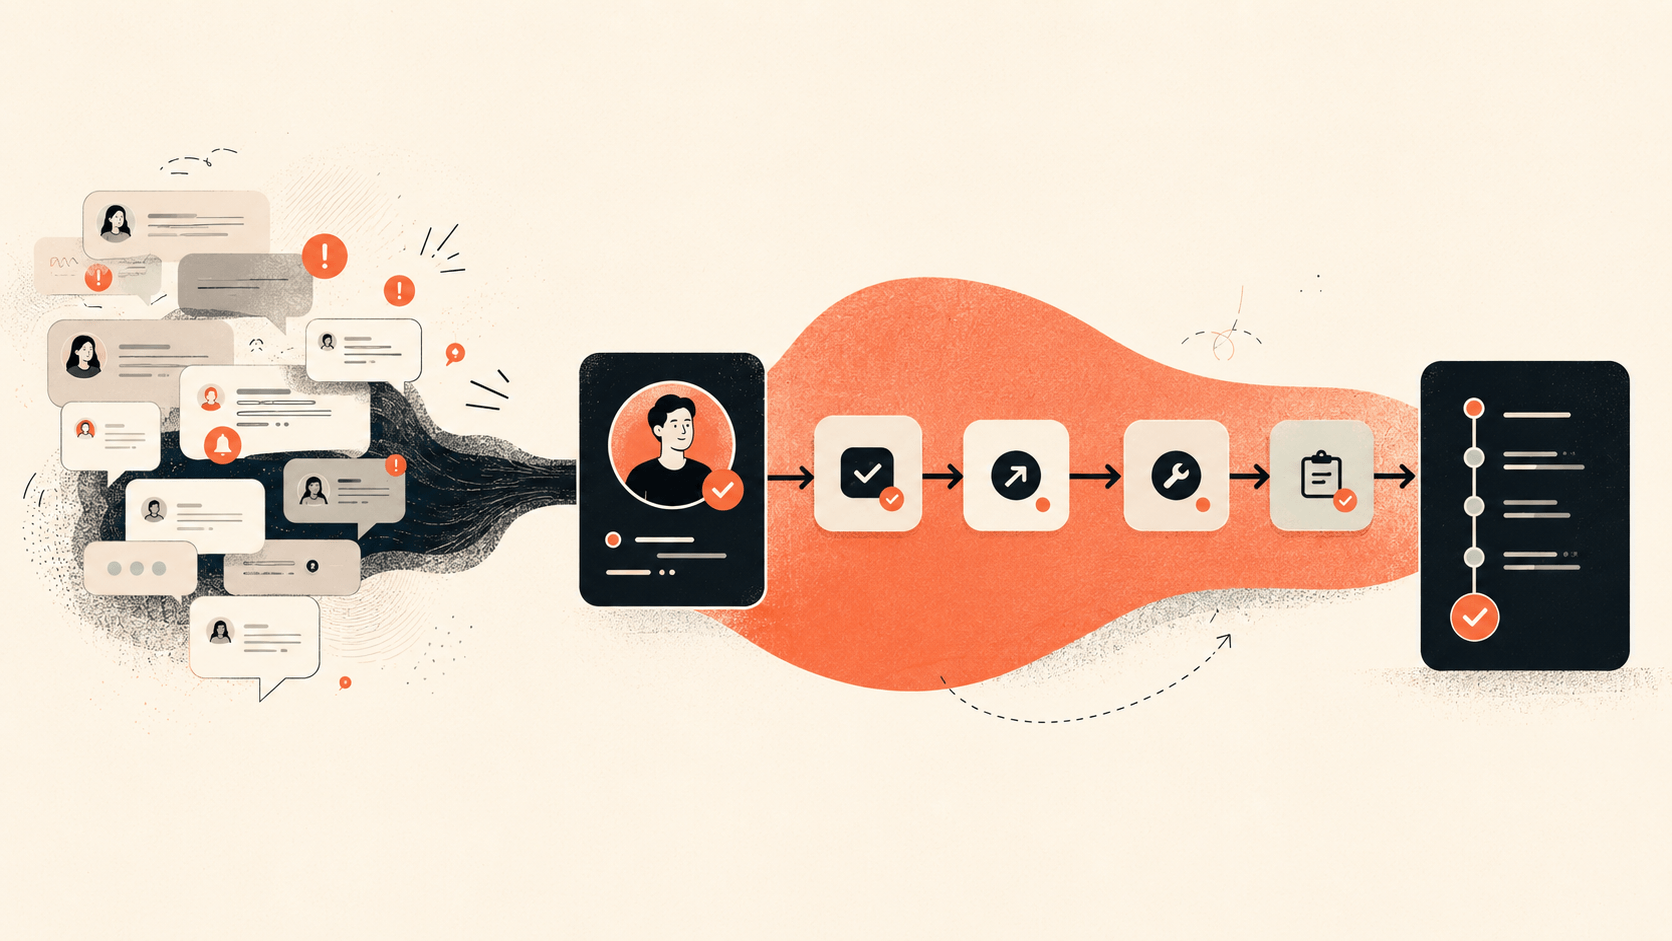
成熟的告警响应体系把九个环节串成一条链路。这九个环节是接入、降噪、路由、排班、升级、触达、认领、关闭和分析。Flashduty 的 On-call 也围绕这些动作设计。它提供多源集成、告警聚合与抑制、灵活分派和多渠道通知,也提供值班计划和升级路径。值班人员在平台中认领、处理和关闭故障。
变化在于责任的对象。过去,一条消息进群,大家一起“看到”。现在,一个事件进入响应流程:
- 分派给对应团队和值班人员。
- 无人响应时,按规则升级。
- 处理完成后,状态关闭。
- 反复发生时,留下数据用于分析和治理。
IM 群仍然承载沟通、同步和作战室协作,但它不再是唯一的事实来源。
对平台负责人,这个区别影响如何解释一次主要业务故障。“群里应该有人看到了”不是解释,“大家在群里很积极”也不能证明稳定性在改进。团队需要一个可审计、可追踪、可复盘的过程。
工具也有边界。On-call 平台无法替团队定义服务边界、团队职责和告警质量。服务归属混乱、告警规则随意配置、升级路径无人维护时,任何系统都会沦为消息中转站。工具能做的,是把这些组织问题暴露出来,让它们不再藏在群聊记录里。
从最近 10 条关键告警开始自查
自查无须立项。抽出最近 10 条关键告警,逐条回答以下问题:
- 有没有明确的负责人?
- 有没有认领时间?
- 有没有升级路径?
- 有没有关闭记录?
- 有没有复盘结论或后续动作?
如果多数答案都要翻群、问人、猜上下文,团队拥有的就只是告警通知,还没有故障响应。
告警进群是起点。下一步,要让每条关键告警都能找到负责人、推动处理、留下记录。如需搭建完整的 On-call 故障响应体系,可以了解 Flashduty On-call。