
动态
精选文章
精选文章
DeepSeek 为什么把状态页从 Atlassian 迁到 Flashduty
DeepSeek 把公开状态页从 Atlassian Statuspage 迁到了 Flashduty Statuspage。影响选型的因素包括中文支持、成本、页面体验、自建的可信度和订阅者迁移。迁移通过两条 CLI 命令完成。
Flashduty 支持团队
每个会话一个锁:用 Redis 为 AI Agent 实现会话运行时
Flashduty AI SRE 技术揭秘第 1 篇:使用 Redis 锁、列表和 Pub/Sub 保证会话串行处理和崩溃后恢复,并使空闲会话不占用 Redis 连接。
Flashduty 工程团队
Opsgenie 替代方案 2026:在 2027 年 4 月停服前确定迁移路径
Opsgenie 将于 2027 年 4 月 5 日停止支持,未迁出的数据会被删除。本文对比 Jira Service Management 与独立 On-call 平台,提供截至 2026 年 10 月的定价出处,以及四周迁移计划。
Flashcat Technical Team
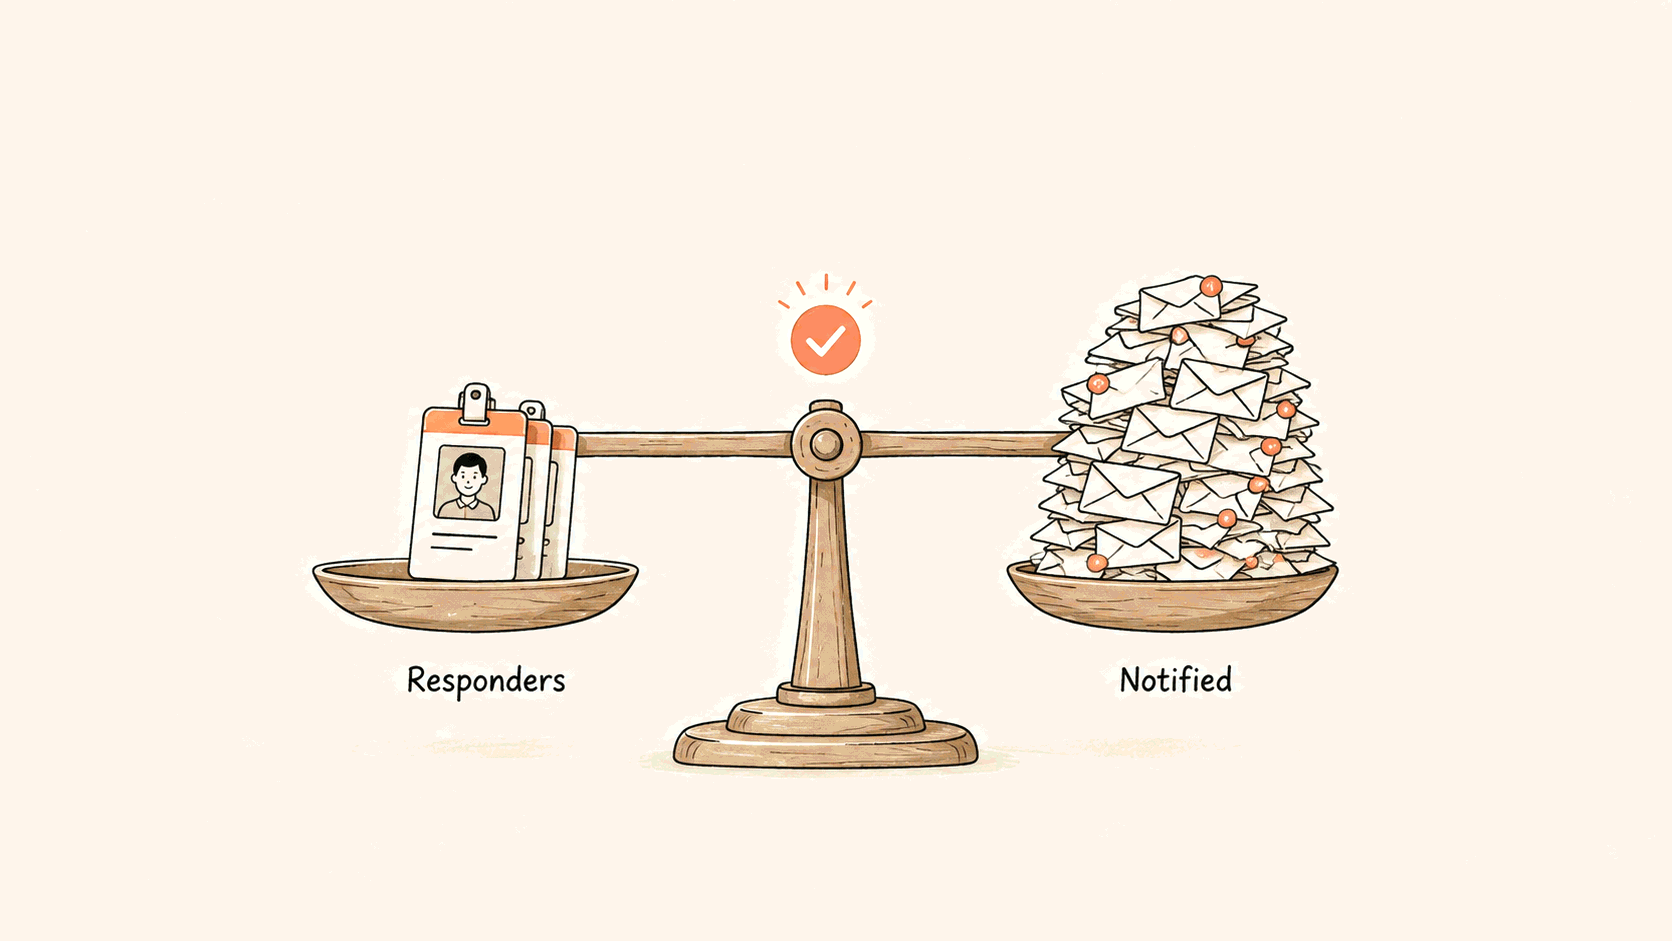
PagerDuty 替代方案 2026:按计费对象比较,而非按席位单价比较
截至 2026 年 10 月,对比六个 PagerDuty 替代方案:Flashduty、incident.io、Grafana Cloud IRM、Better Stack、FireHydrant 和 Jira Service Management。重点比较只接收通知的成员如何计费,以及 AI、状态页和迁移成本。
Flashcat Technical Team
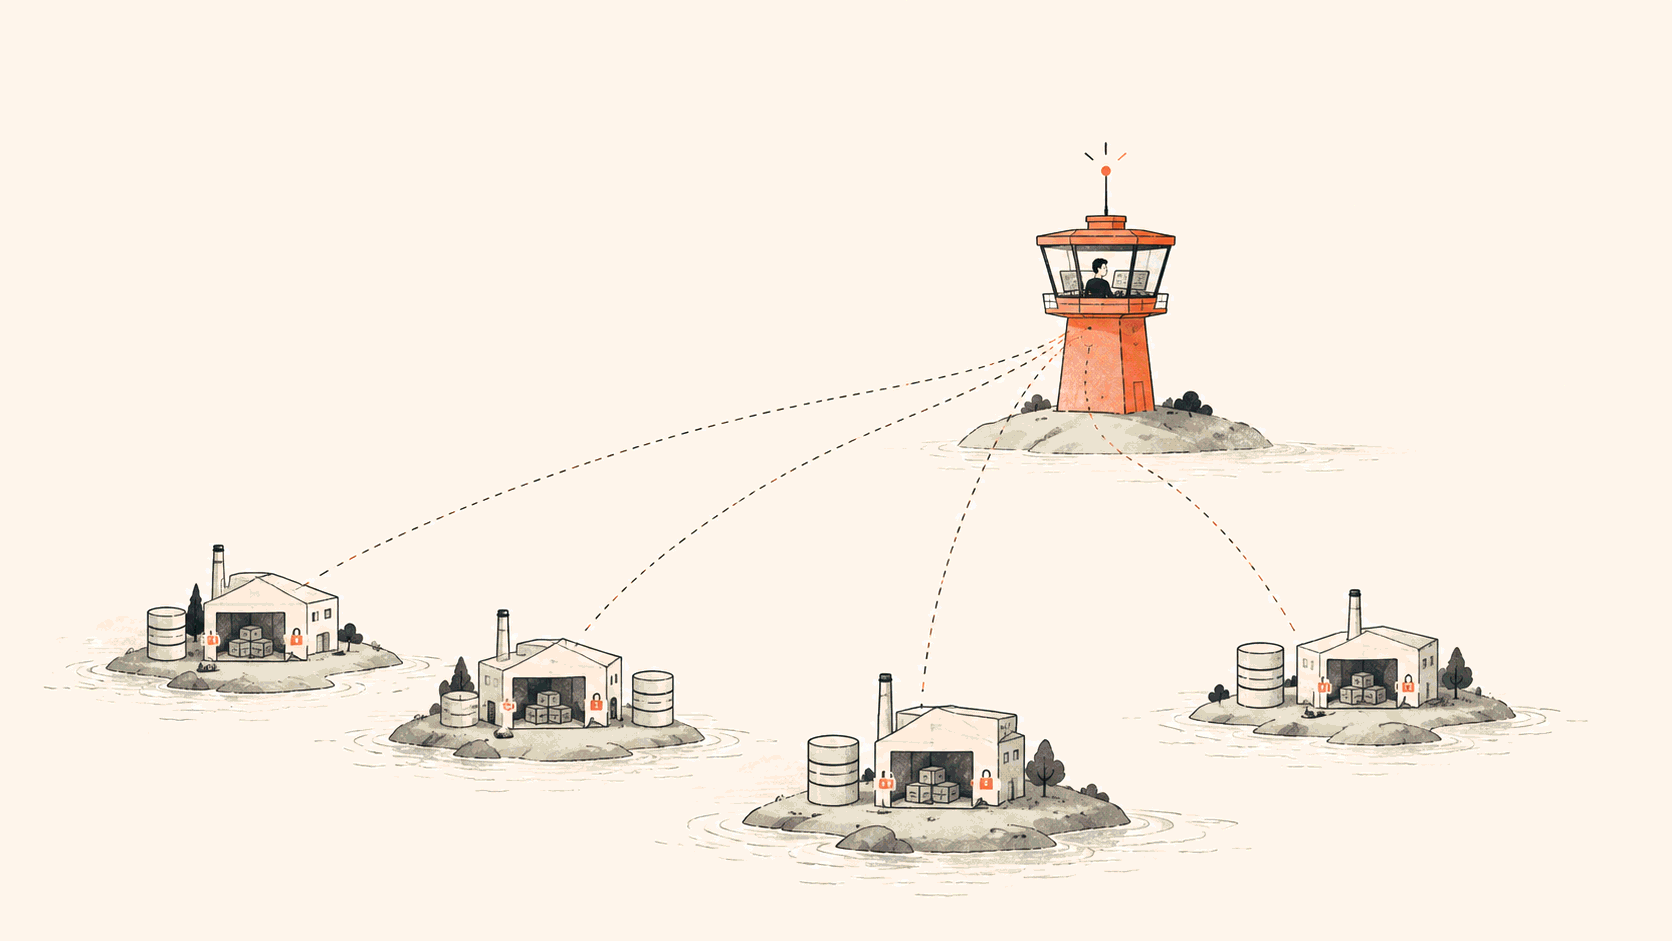
数据保留在各个环境,告警集中管理
数据源分散有其合理原因,但告警规则、运行状态和排障入口不应随之分散。Flashduty Monitors 让数据保留在私网中,将告警和分析能力集中到一个控制面。
快猫技术
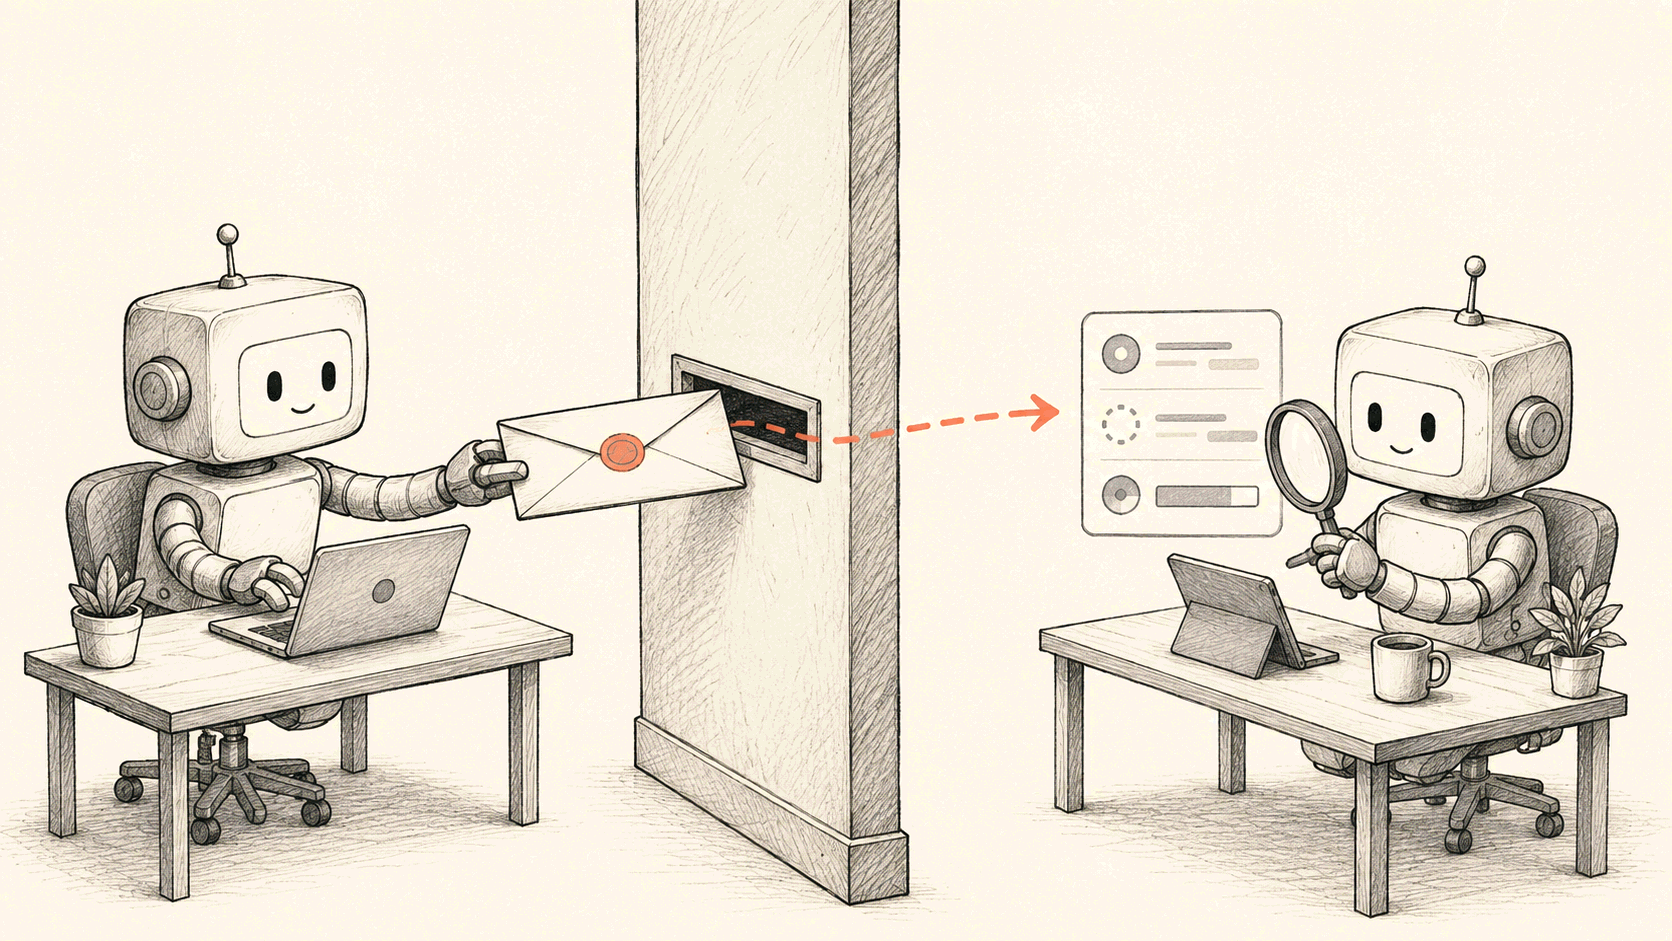
AI SRE 与外部 Agent 通过 A2A 互相委派任务
在控制台登记外部 Agent 后,AI SRE 可以将完整任务委派给该 Agent,进度以流式方式返回对话;AI SRE 也提供标准 A2A 接口,接受其他 Agent 委派的任务。
Flashduty 工程团队
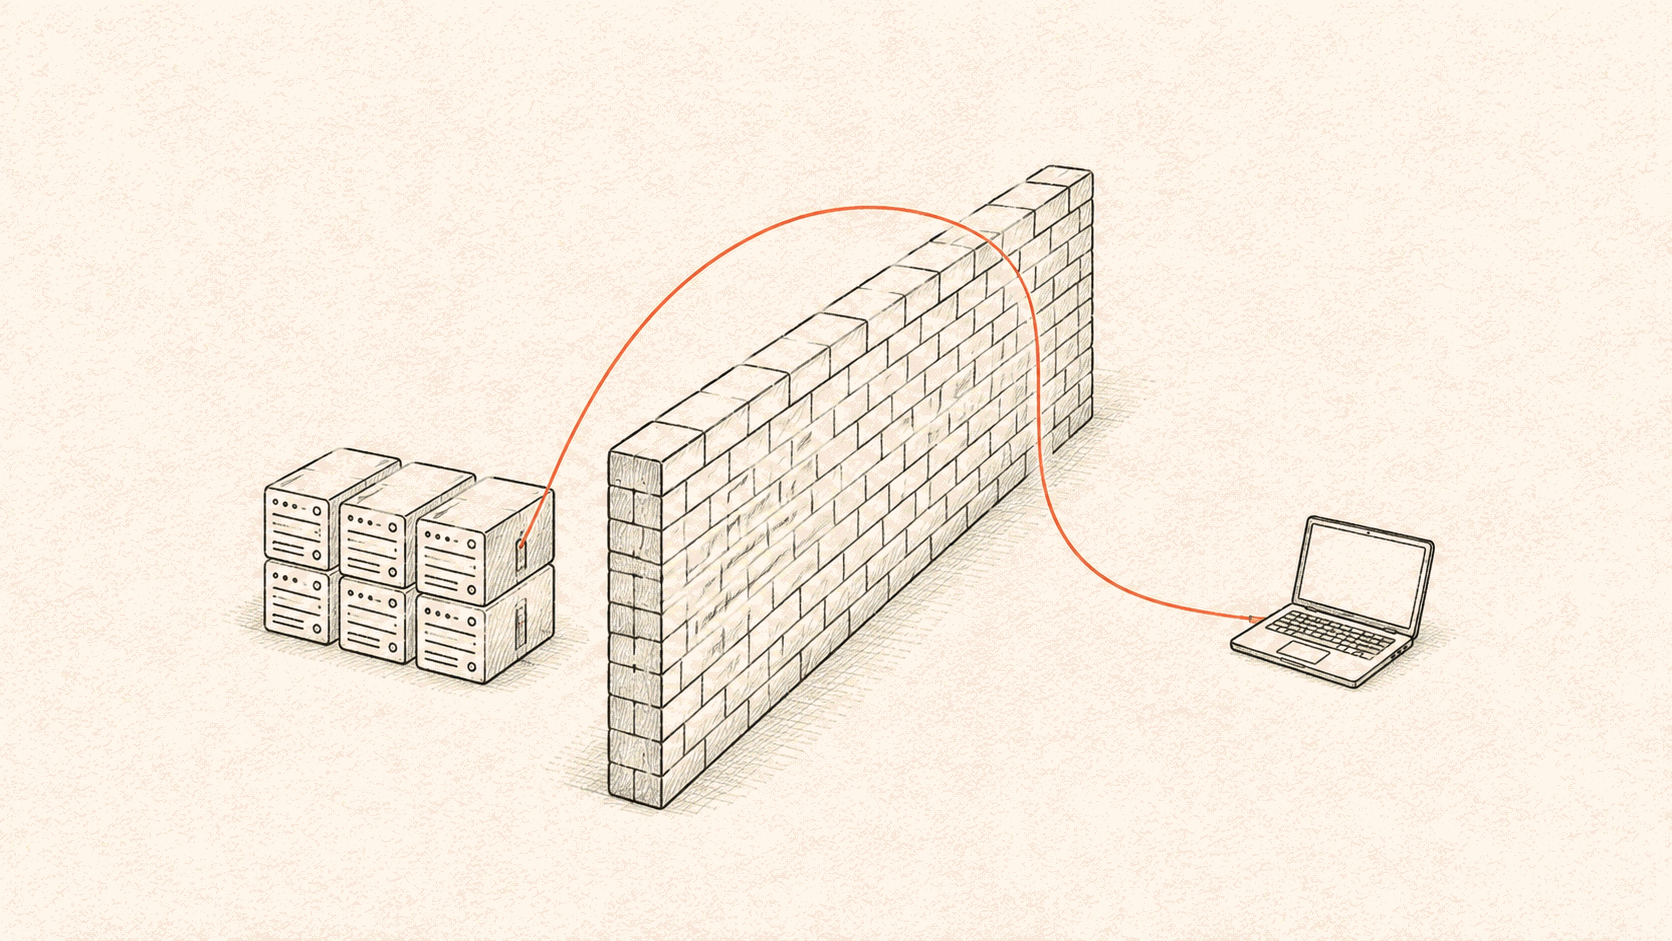
AI SRE 安全访问 Kubernetes 集群:无须开放公网,无须提供 kubeconfig
将集群接入 AI SRE 需要同时满足四个条件:kubectl 的全部能力、不开放入站端口、凭据不离开集群、权限严格受控且不依赖能力清单。我们的方案是让 Agent 运行原生 kubectl,由集群主动建立出站连接,权限完全由 Kubernetes RBAC 判定。
Flashduty 工程团队
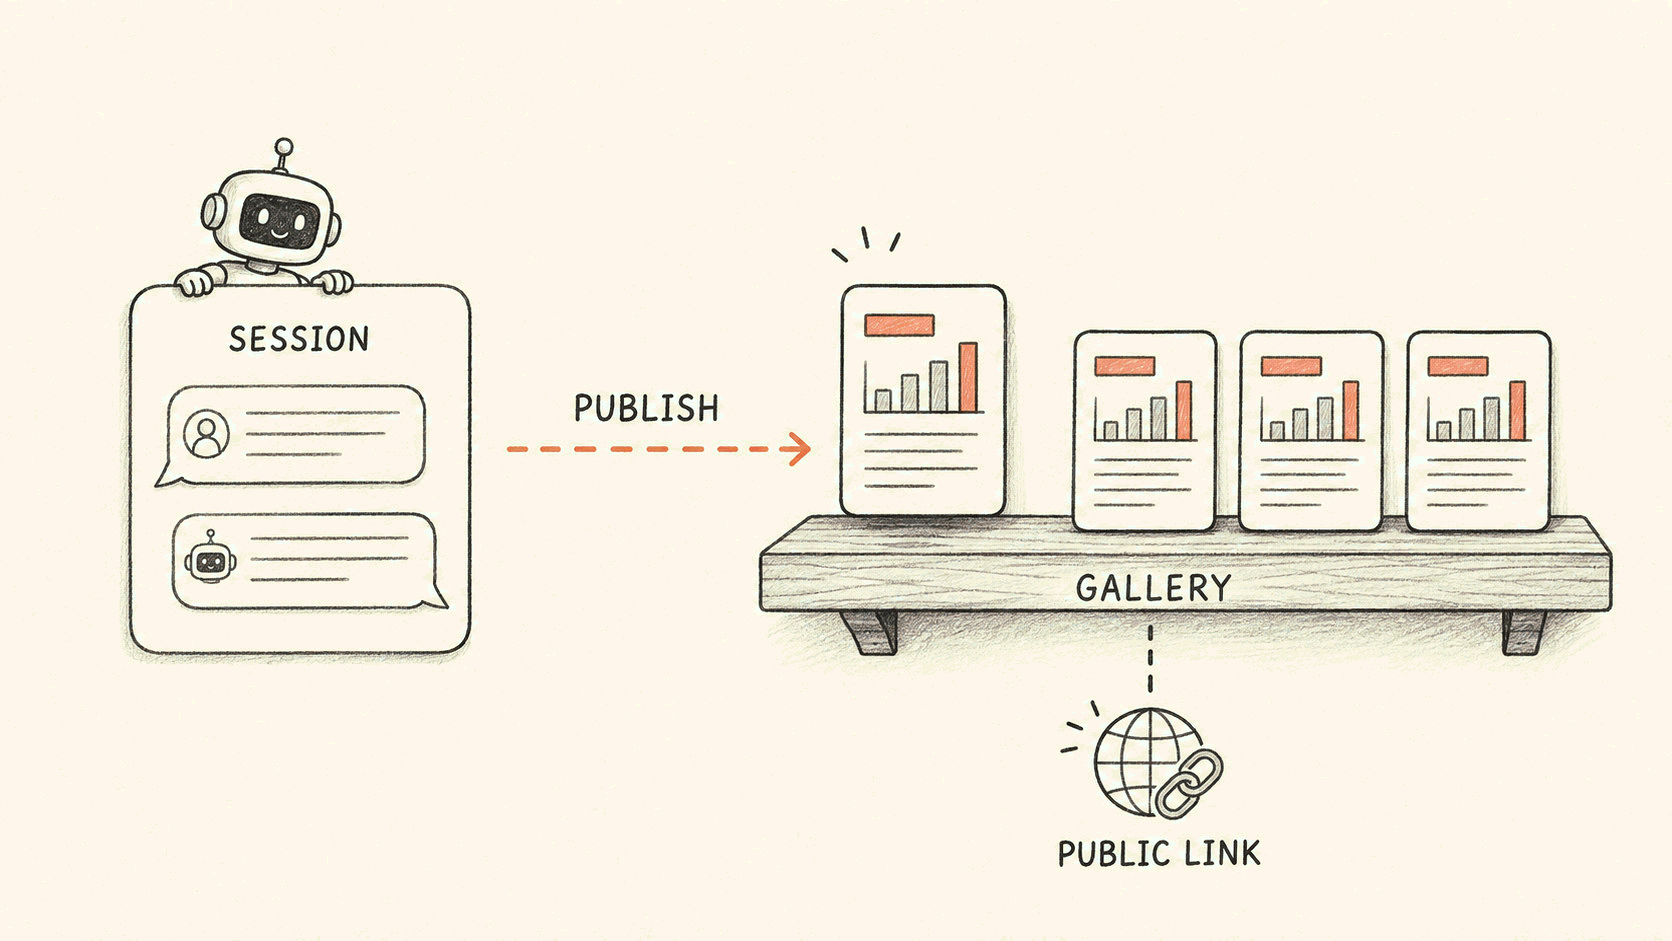
AI SRE 产物:每份报告都有可长期保存、可分享的链接
AI SRE 会话中生成的报告、设计文档和页面现在可以发布为产物。产物有两项作用:长期保存,每个产物在产物库中拥有独立地址,团队成员随时可以打开;对外分享,需要时可生成免登录的公开链接,并可随时撤销。
Flashduty 产品团队
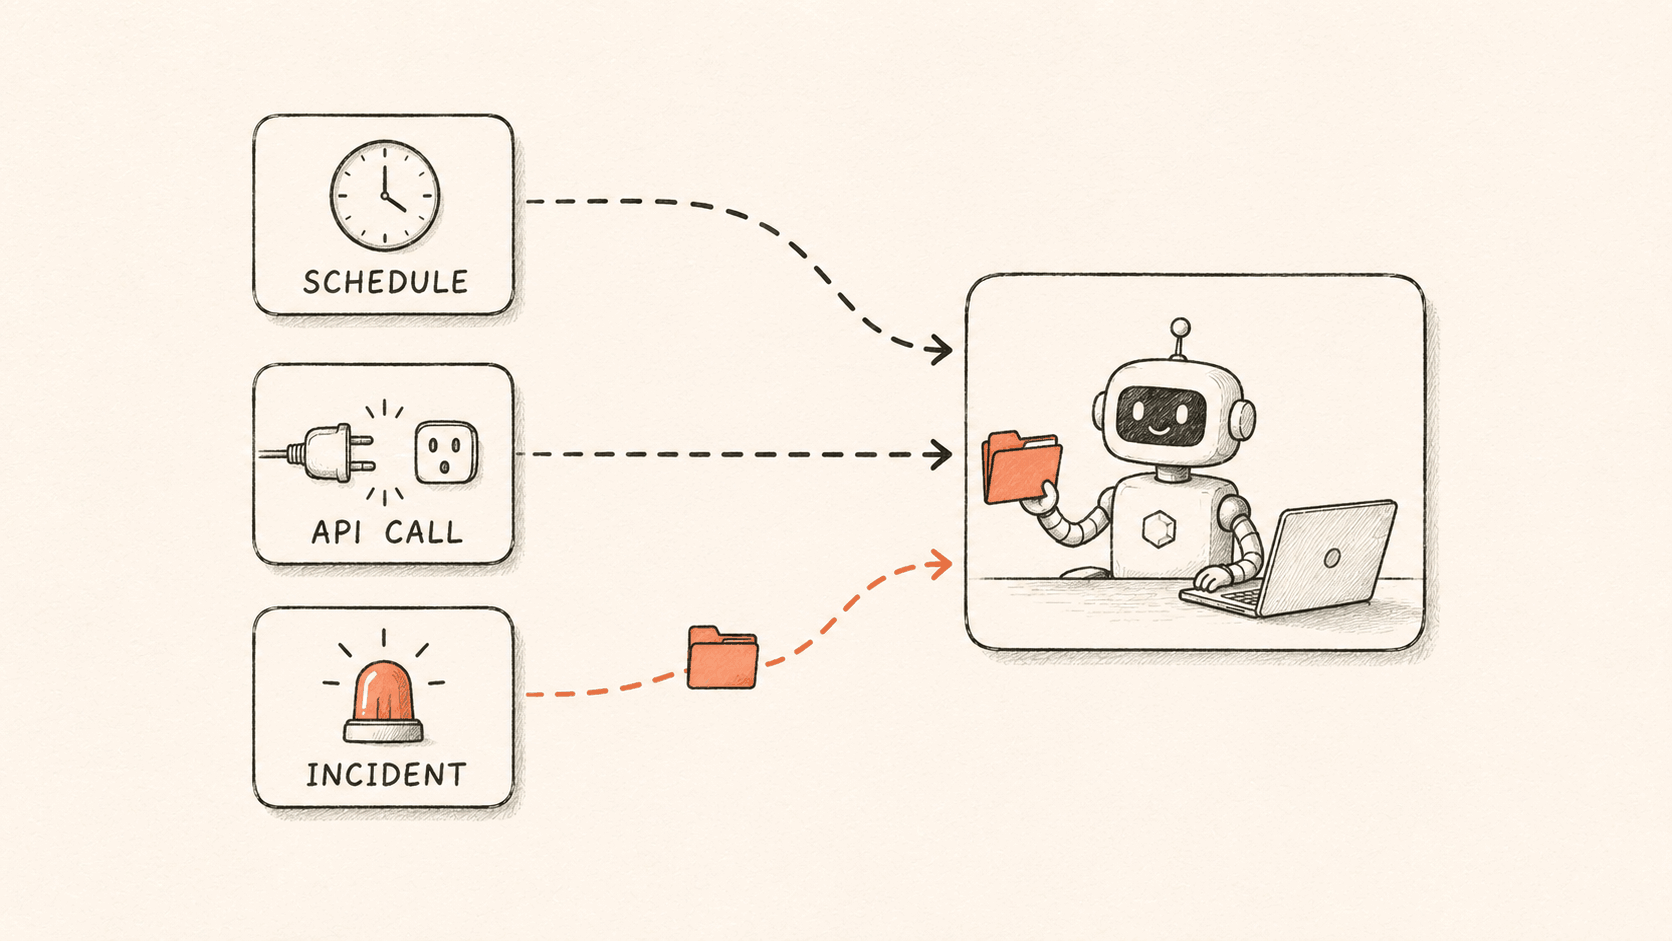
凌晨三点自动开始调查:AI SRE 自动化的五种用法
每周洞察、告警治理、故障自动分析、发布后巡检和变更风险预检五种用法,各附完整的任务提示词,并说明运行结果送达相关人员的方式。
Flashduty 产品团队
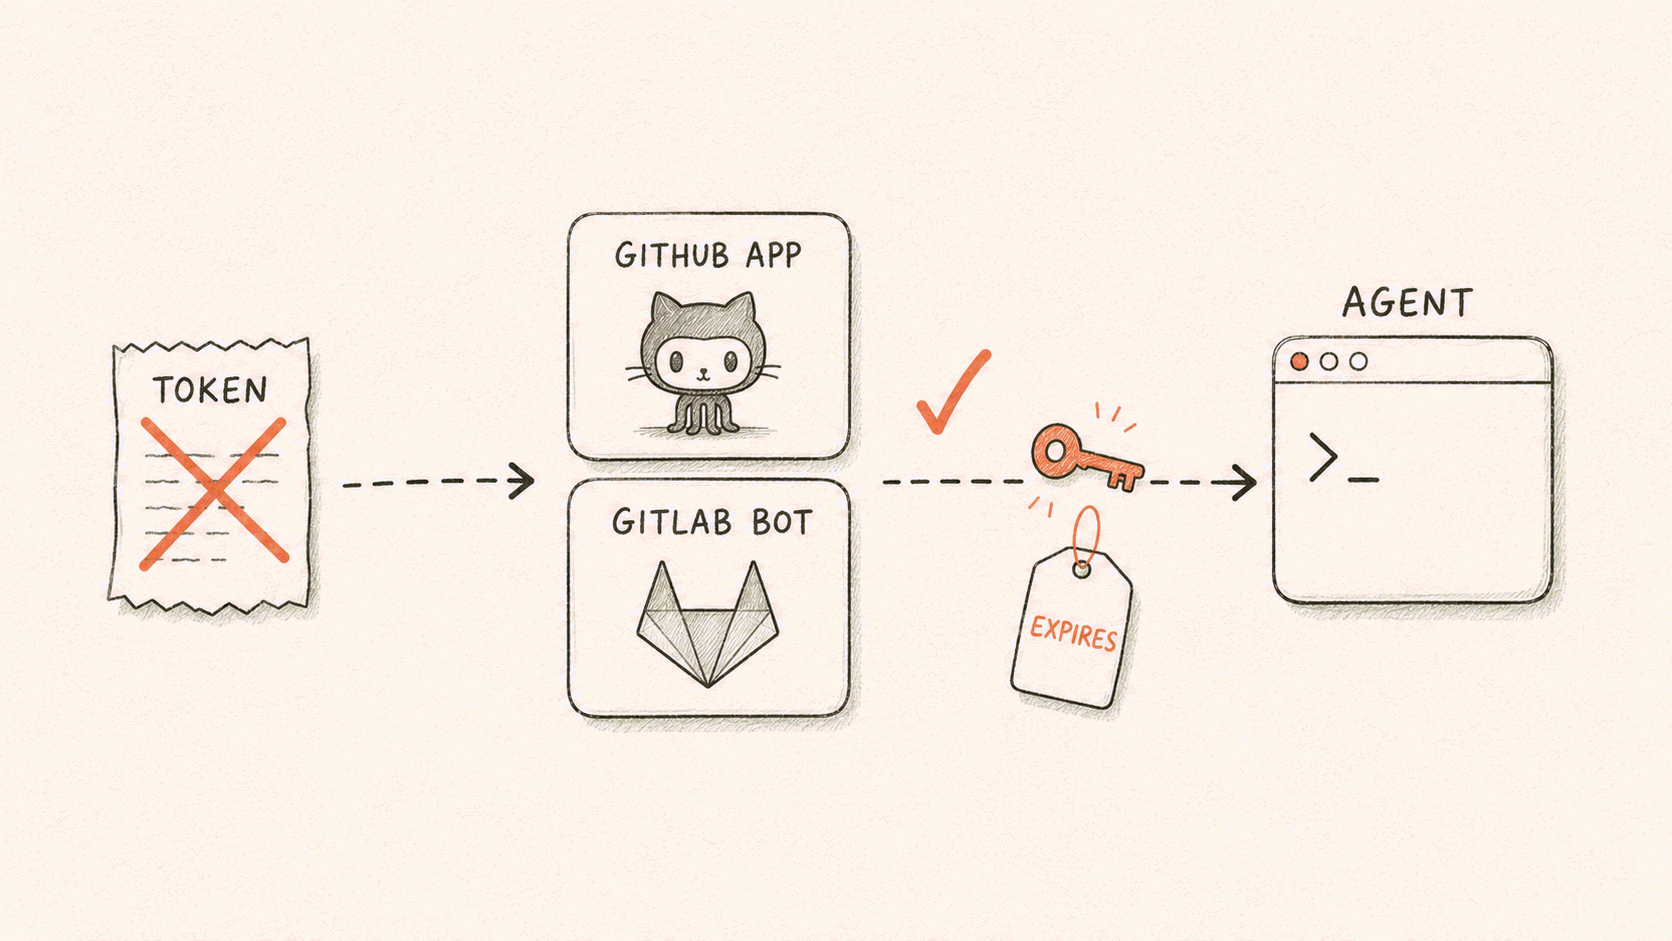
GitHub / GitLab App:AI SRE 读取提交、分析 CI 日志并创建 PR
AI SRE 现已支持连接 GitHub 组织或 GitLab 实例:排查故障时读取最近的提交,CI 失败时分析失败日志,小型修复直接创建 PR 并等待人工评审。整个过程无须粘贴令牌。
Flashduty 产品团队
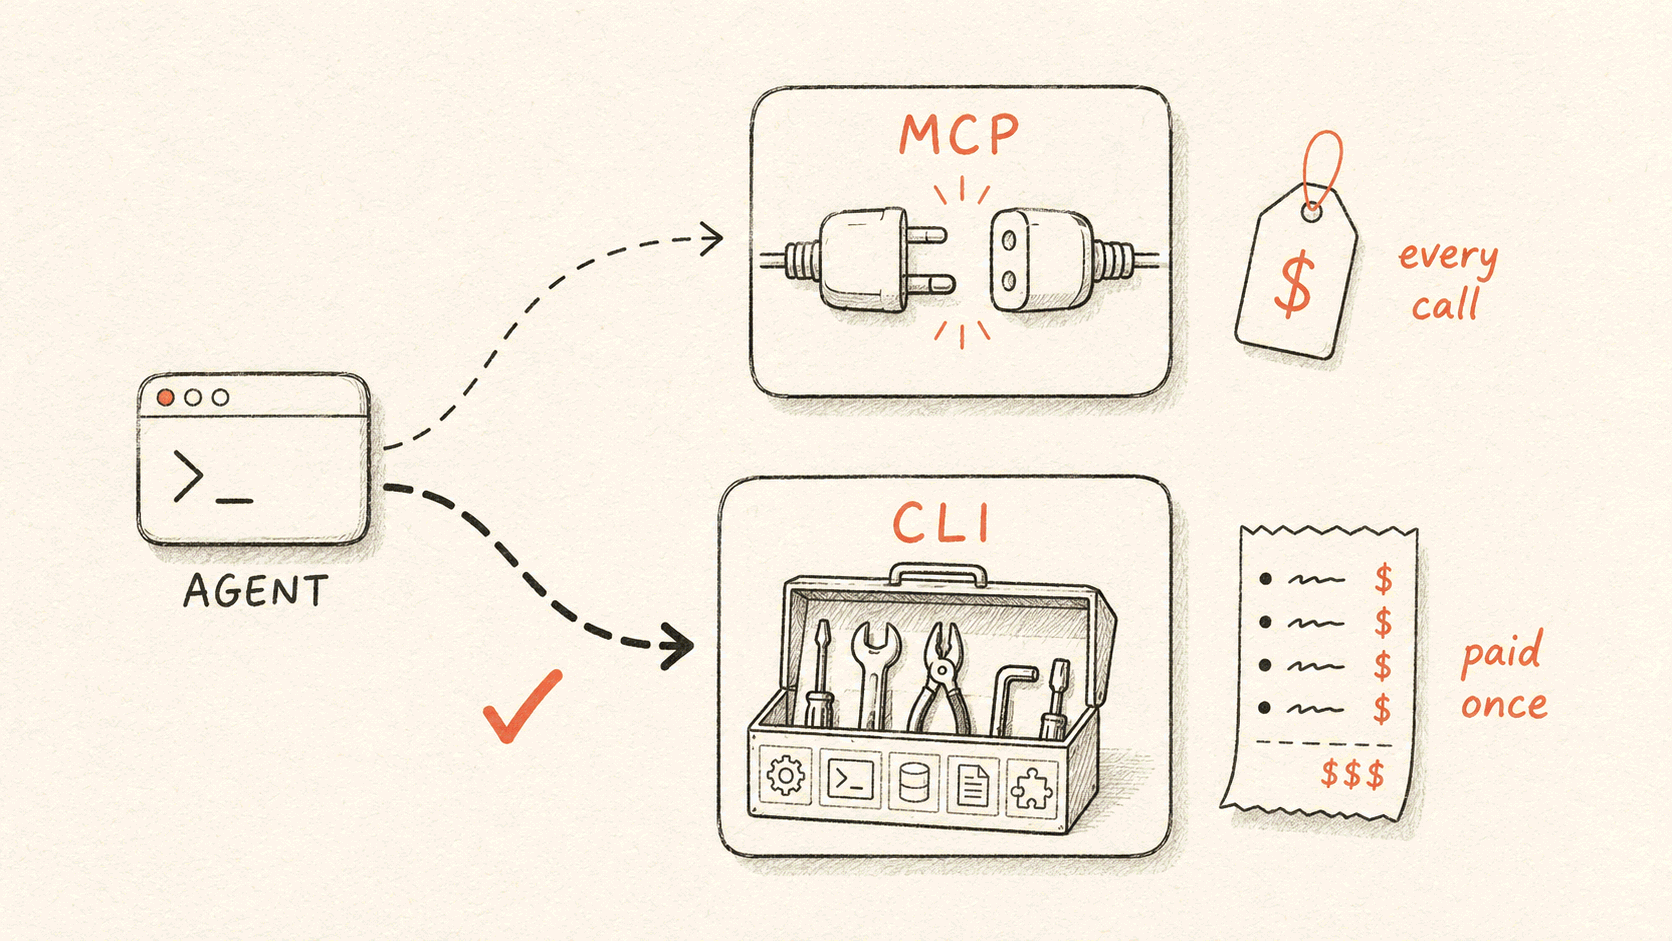
从 MCP 到 CLI:自有平台应为 Agent 提供命令行
今年一月,我们的 AI SRE 通过内置 MCP 操作 Flashduty;五月底,我们改用生成式 CLI。本文说明为什么没有扩充 MCP、为什么放弃搜索式加载,以及切换之后付出的代价。
Flashduty 工程团队
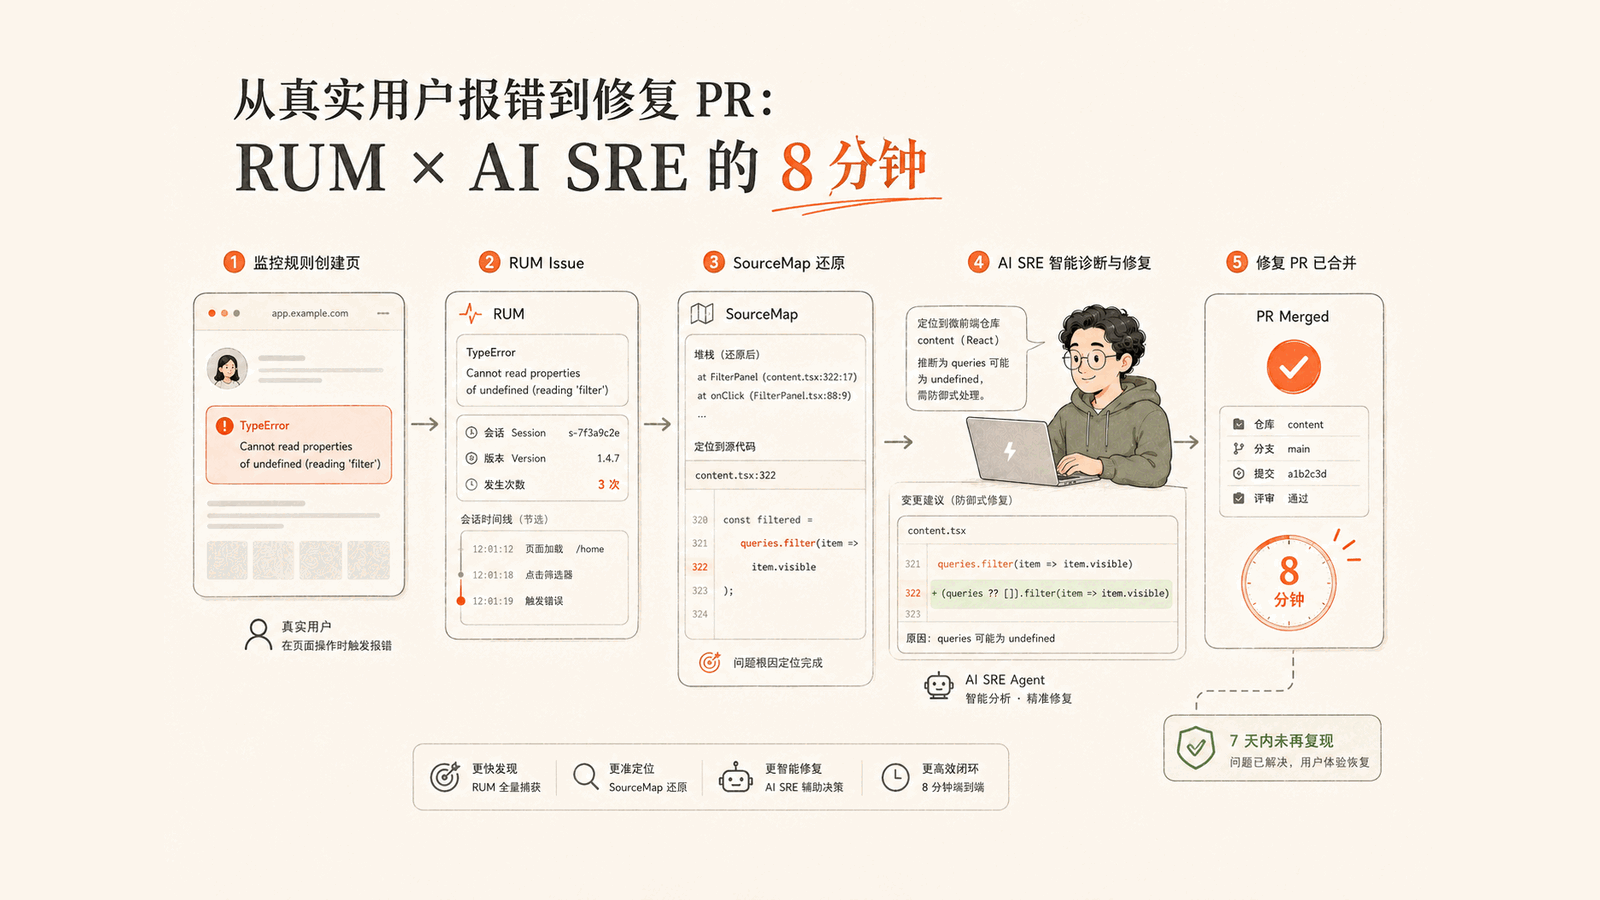
从真实用户报错到修复 PR:RUM × AI SRE 的 8分钟
一名用户在监控规则创建页遇到 3 次前端异常。RUM 留下会话与版本,并通过 SourceMap 还原到具体源码;AI SRE 随后定位仓库、完成一行修复并创建 PR。
Flashduty 工程团队
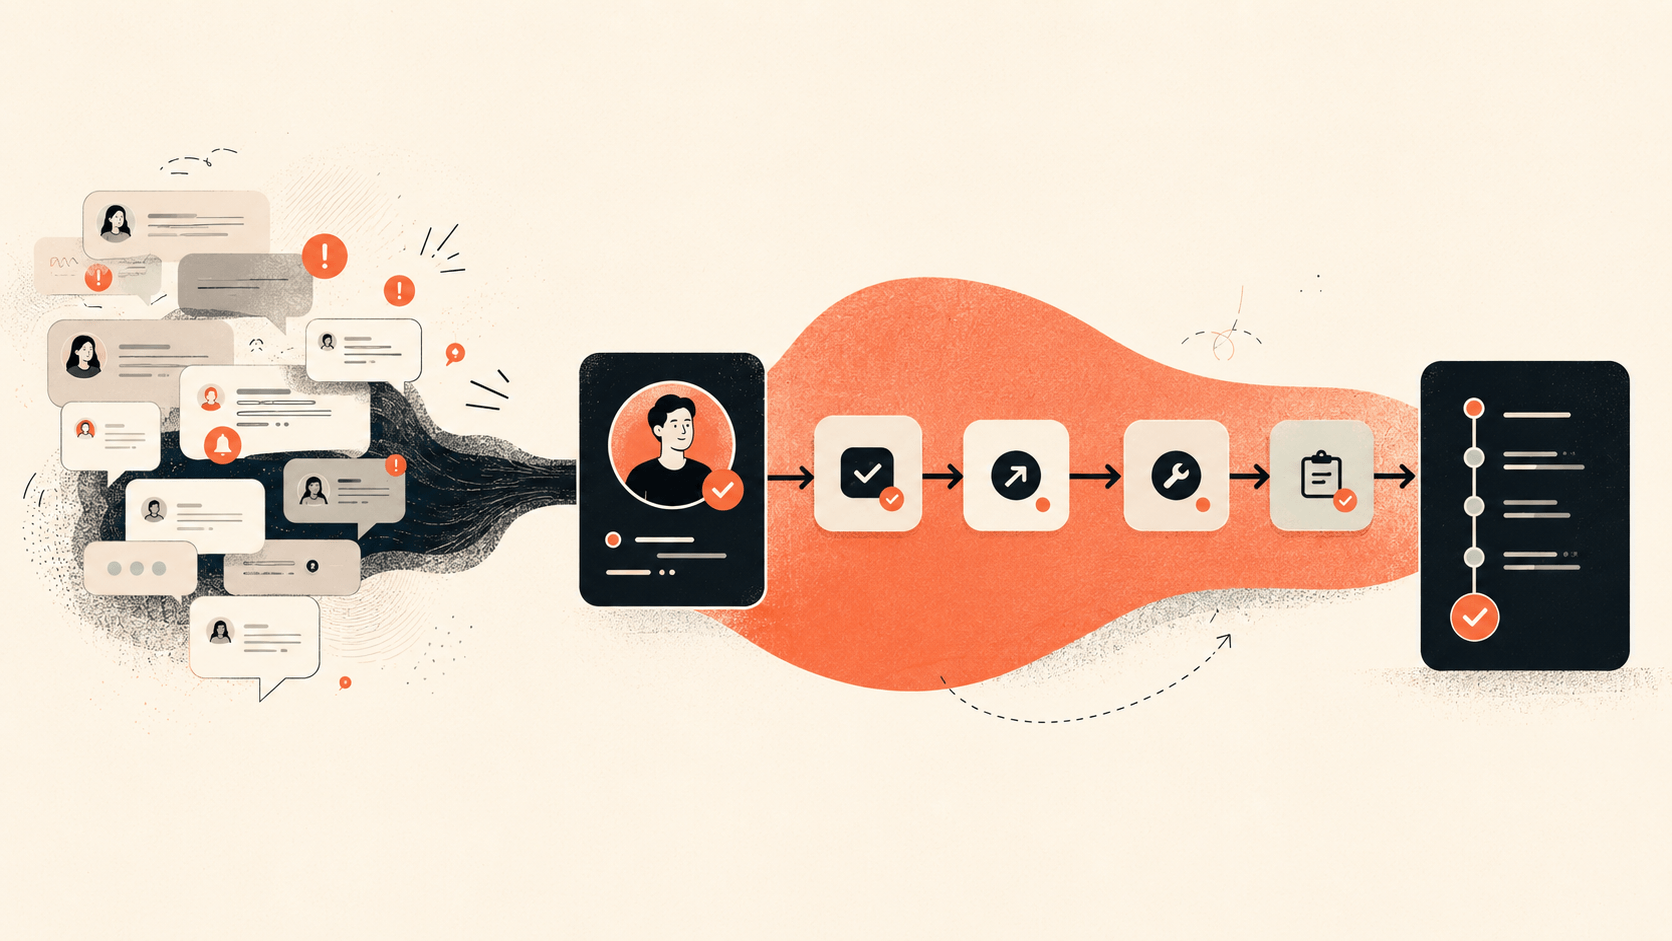
告警发到群里,不等于故障有人负责
群机器人让告警可见,但不会指定负责人。故障响应需要留下负责人、认领、升级、关闭、时间线和复盘记录。本文给出一个自查方法:抽查最近 10 条关键告警。
Flashduty 产品团队
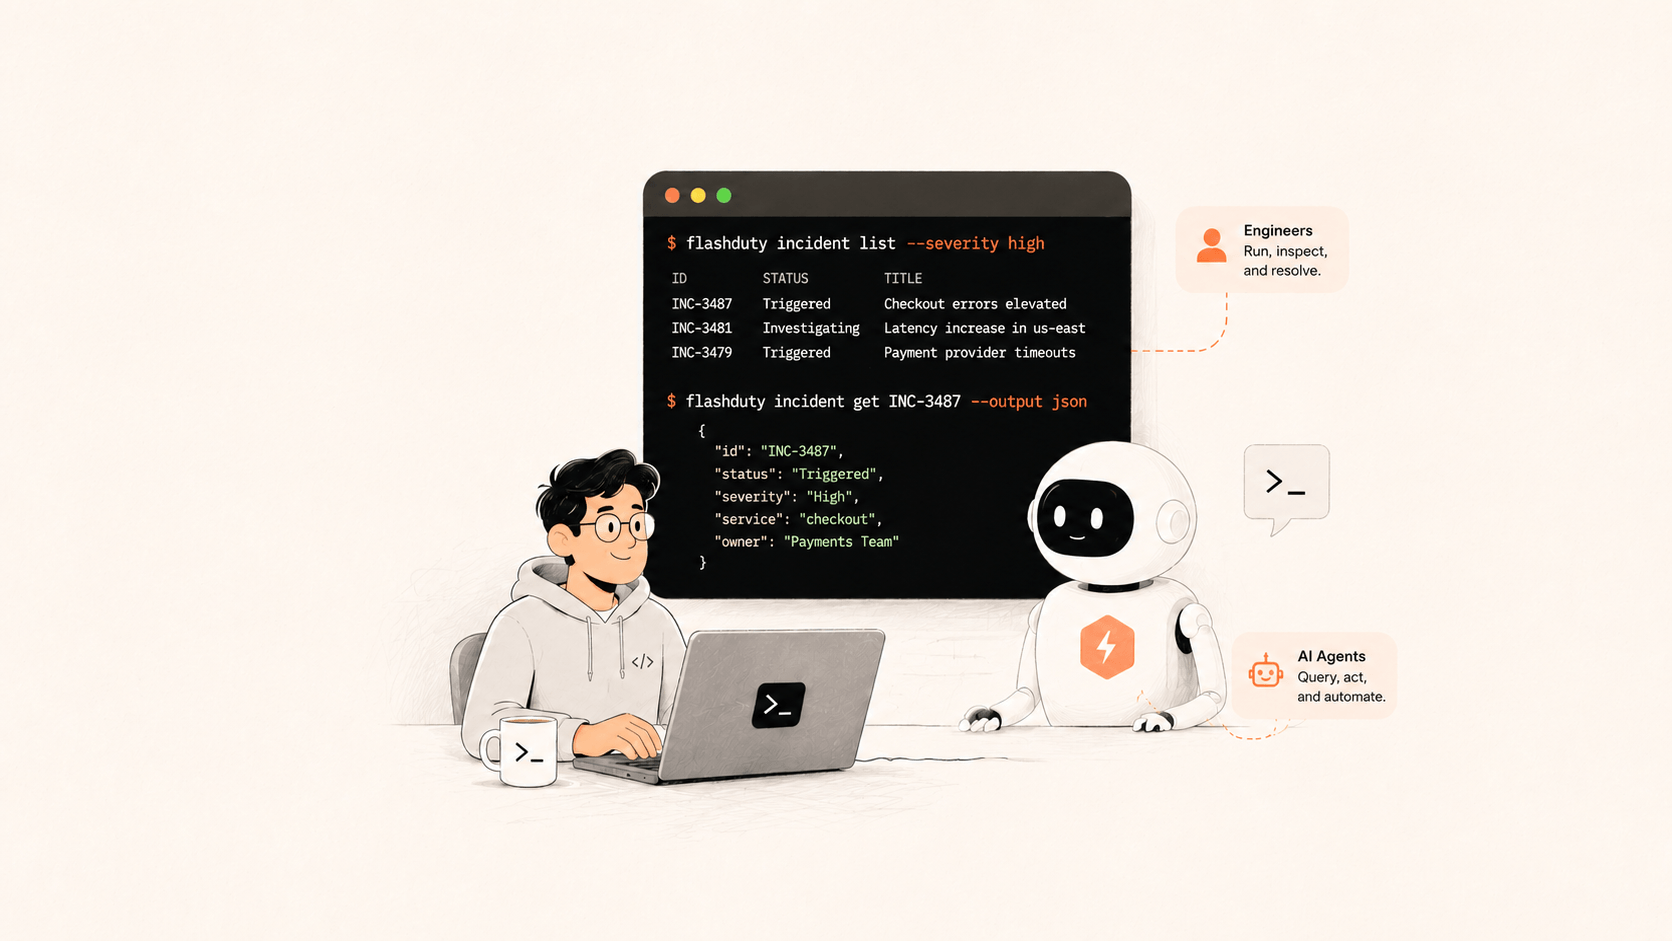
flashduty-cli:在终端中处理故障,并让 AI Agent 安全地参与处理
本文说明我们为什么为故障响应平台开发命令行工具,以及为什么将它设计为 AI 编程 Agent 操作 Flashduty 的入口。这是一篇关于 CLI 设计取舍的工程笔记。
Flashduty 工程团队
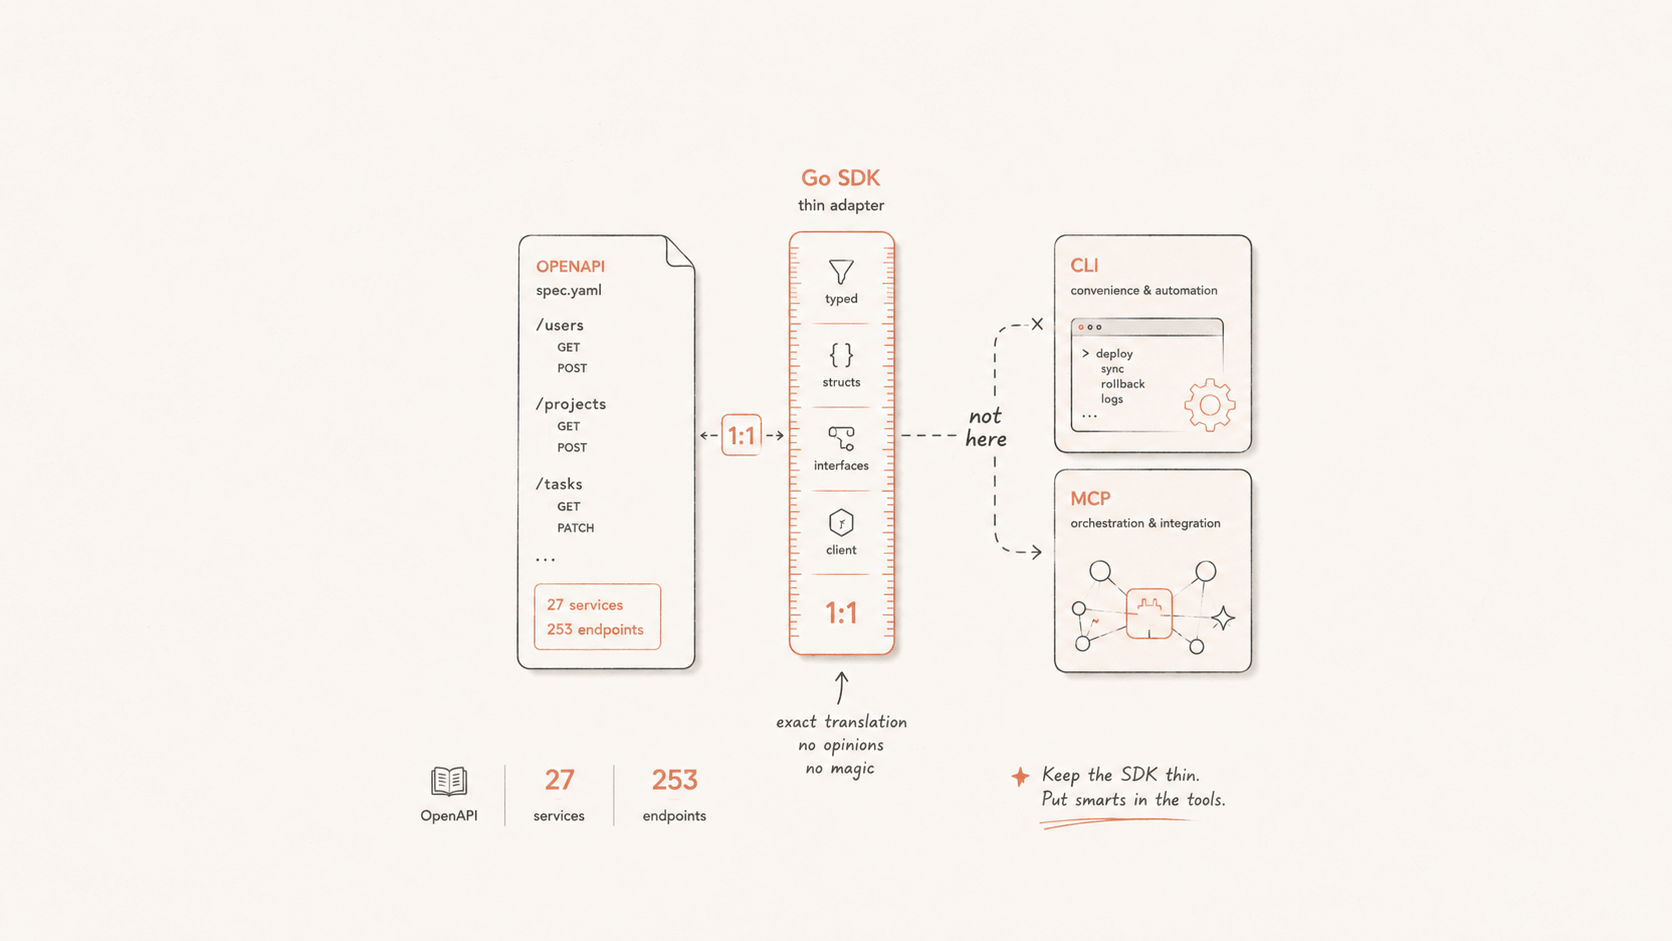
SDK 不应比 API 更聪明:go-flashduty 的三个设计决定
go-flashduty 是 Flashduty Open API 的官方 Go 客户端:薄、强类型、由 OpenAPI 规范代码生成。一个覆盖 27 个服务、253 个接口的 SDK 该如何设计与长期维护:为什么选 codegen 而非手写,为什么坚持与 API 严格 1:1,以及这条边界如何让 SDK 多年不腐化。
Flashduty 工程团队
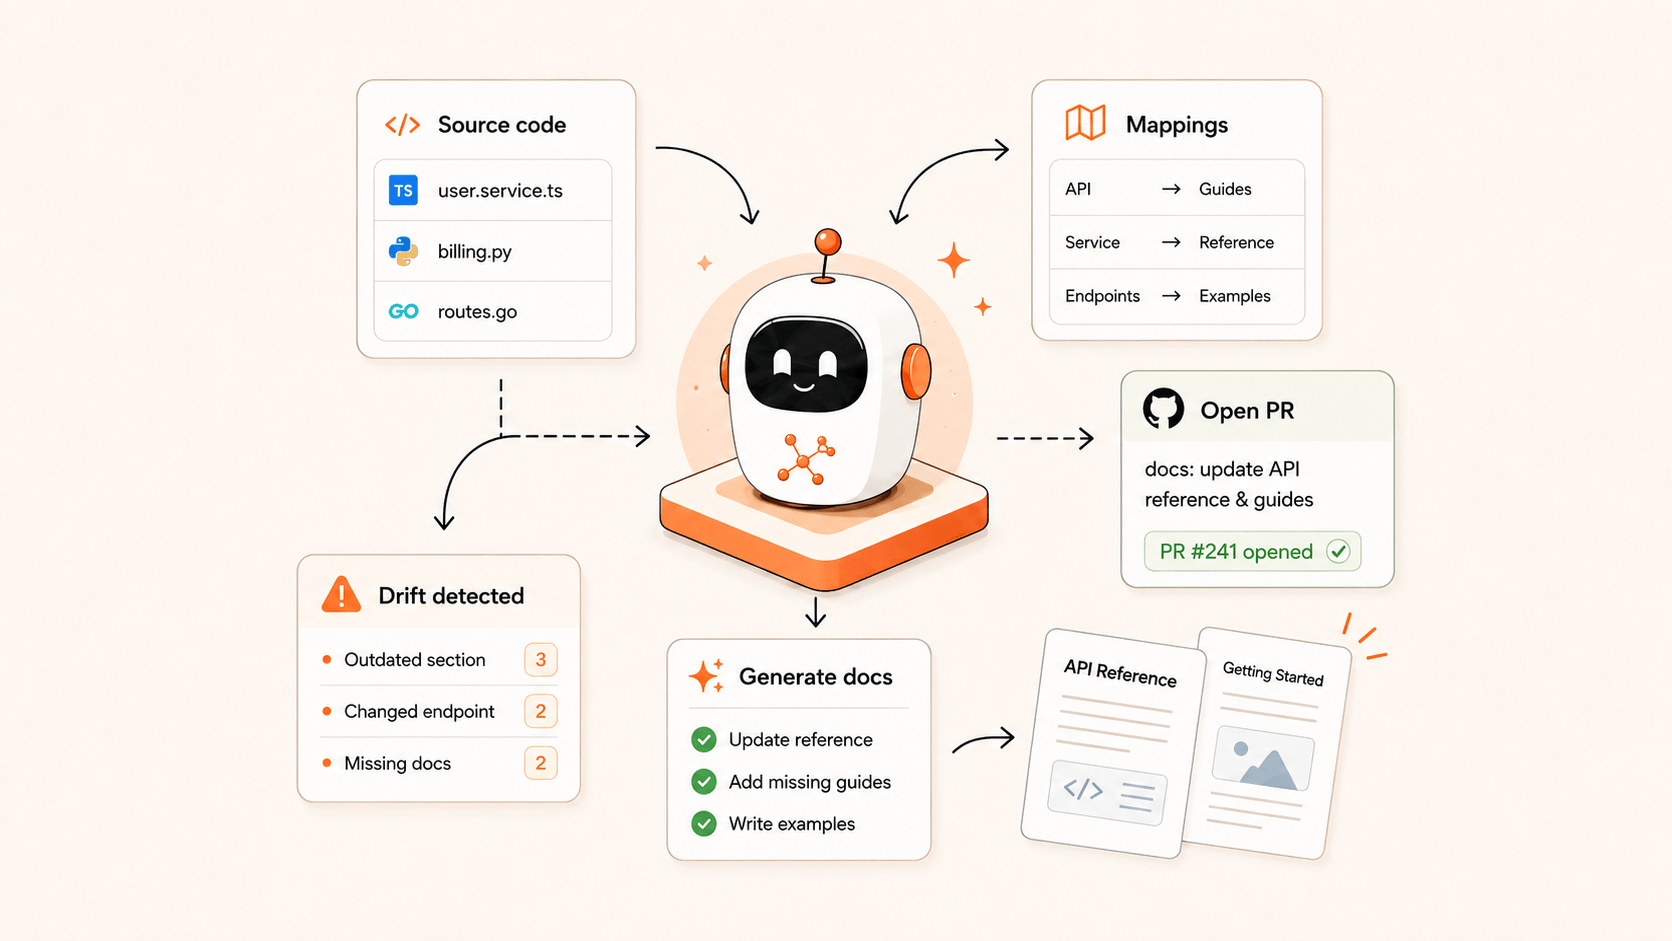
我们不再手写文档
一个没有专职产品经理的小团队,借助一个 AI Agent 找出数百个文档缺口、补齐内容并提交 PR。解决方法是让文档漂移及时暴露,而不是反复提醒工程师编写文档。
Flashduty 工程团队
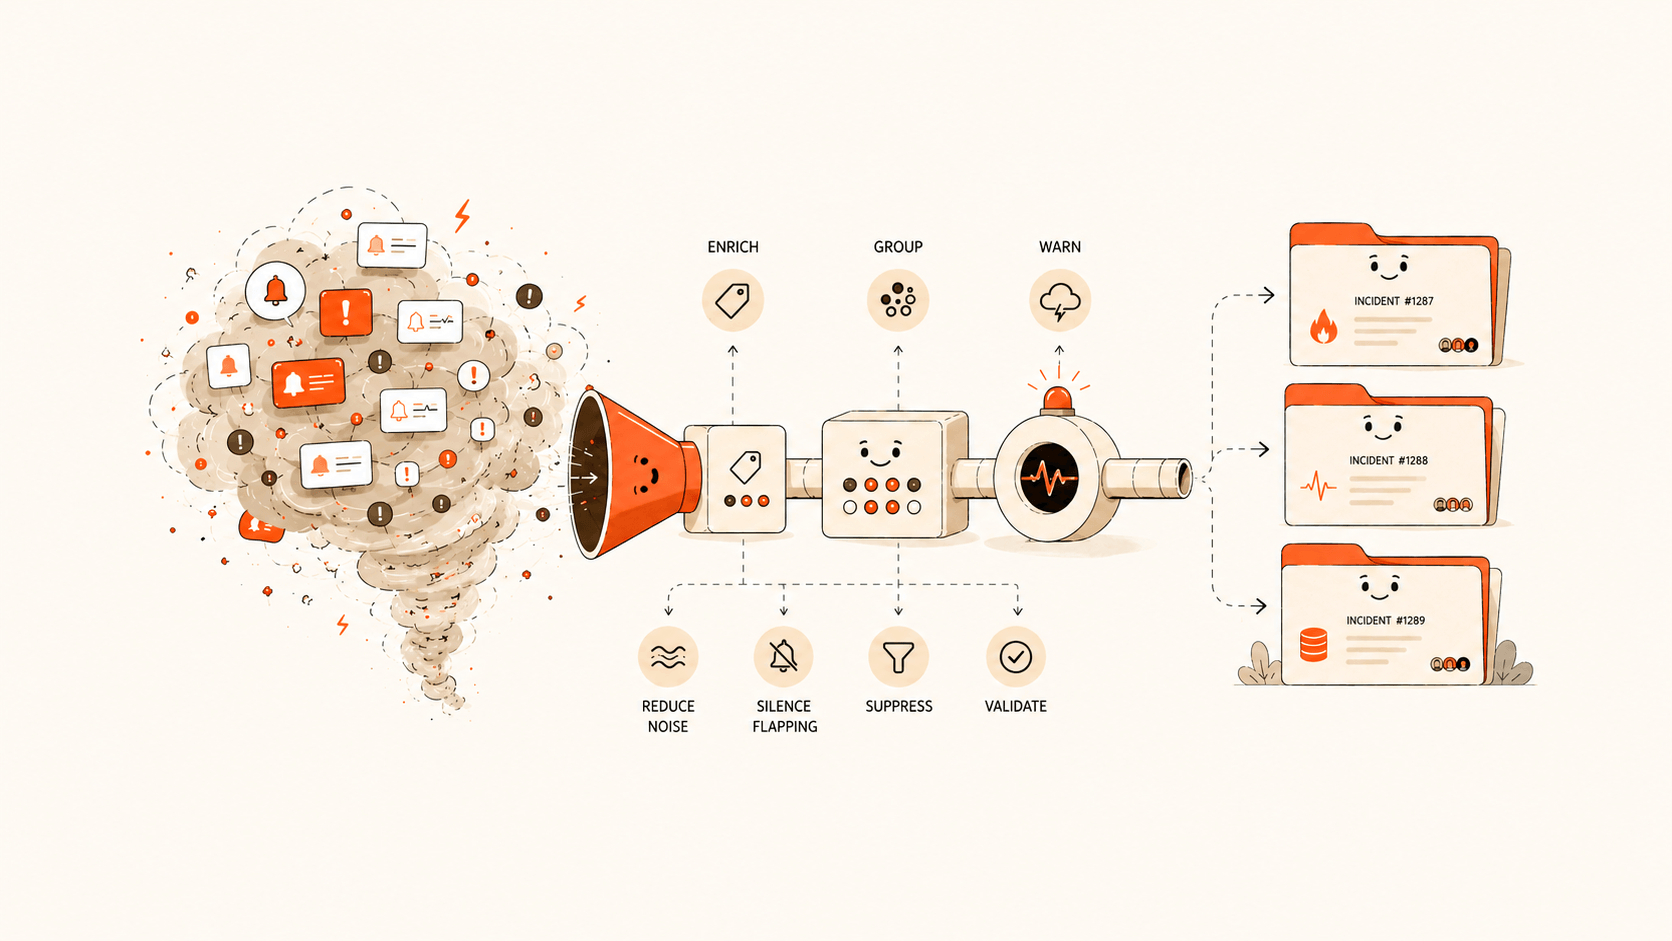
告警风暴降噪实践:用 14 天把告警收敛为可处理的故障
降噪的目标是把海量告警收敛为少量可处理的故障,而非删除告警。本文给出 14 天的分步做法、一份可复用的配置模板,以及判断降噪是否有效的指标。
Flashduty 支持团队
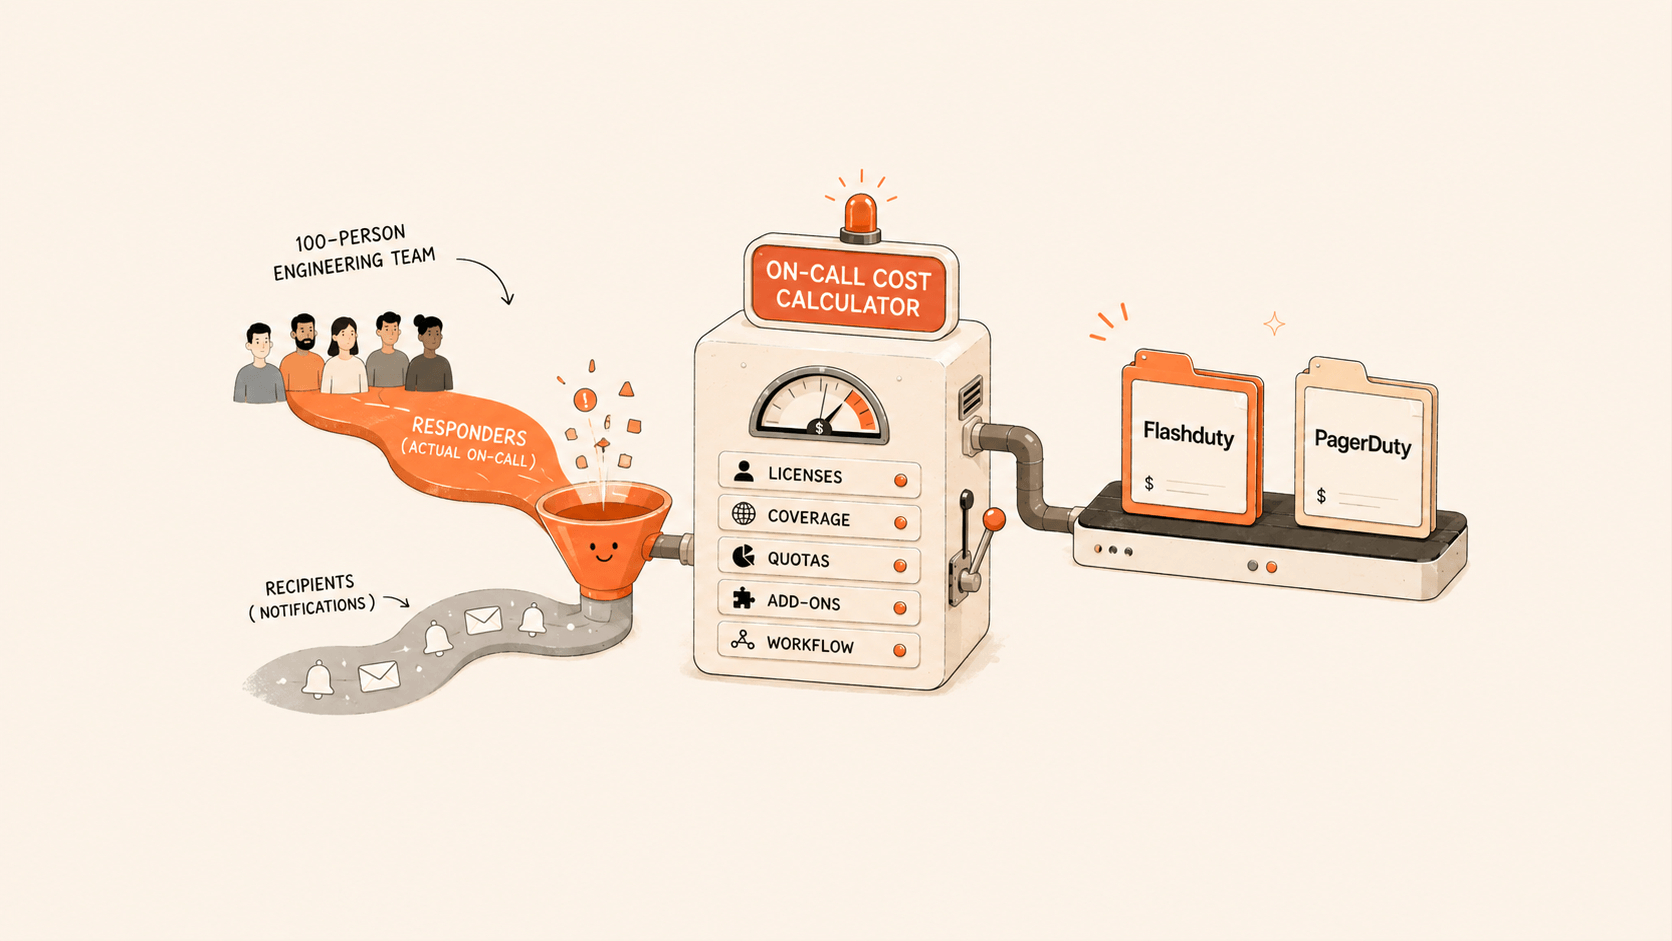
100 人团队的 PagerDuty 与 Flashduty 成本对比:取决于为谁付费
截至 2026 年 10 月、附出处的 On-call 成本模型:先区分处理人和只接收通知的成员,再对比 PagerDuty 完整席位、PagerDuty Stakeholder 席位和 Flashduty 处理人 License。
Flashduty 产品团队
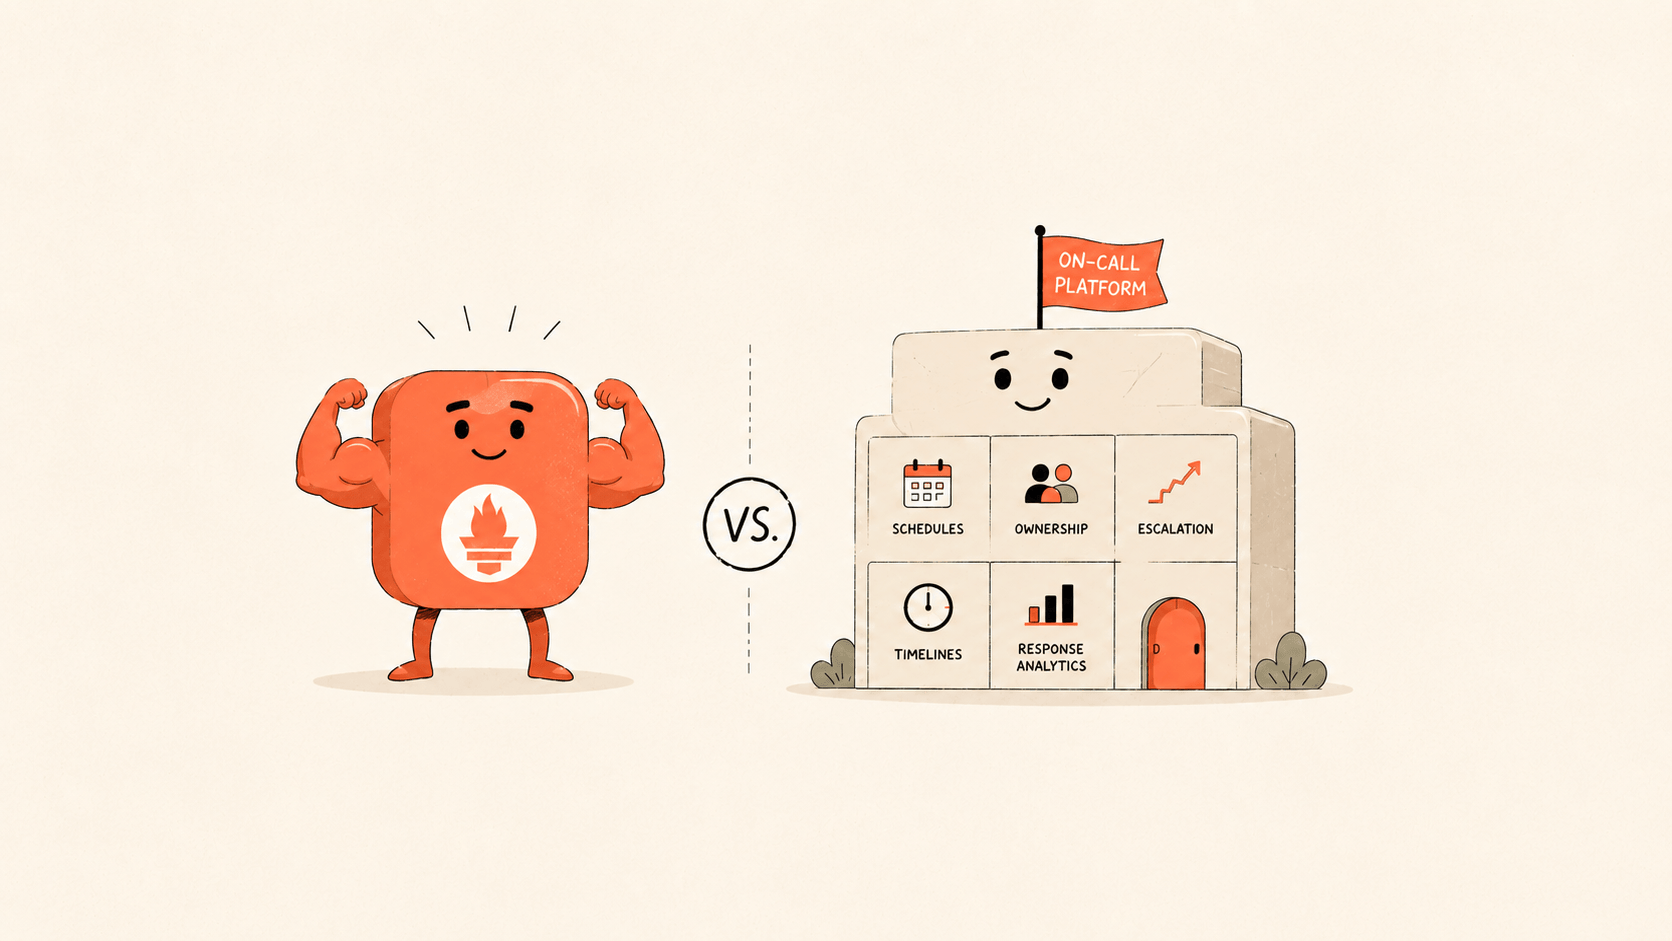
Alertmanager 够用吗?一张表判断是否需要 On-call 平台
Alertmanager 负责告警路由,On-call 平台负责故障响应。本文给出一张对比表和两份判断清单,说明 Alertmanager 何时够用、何时需要在其后接入 On-call 平台,以及接入 Flashduty 的配置方法。
Flashduty 产品团队
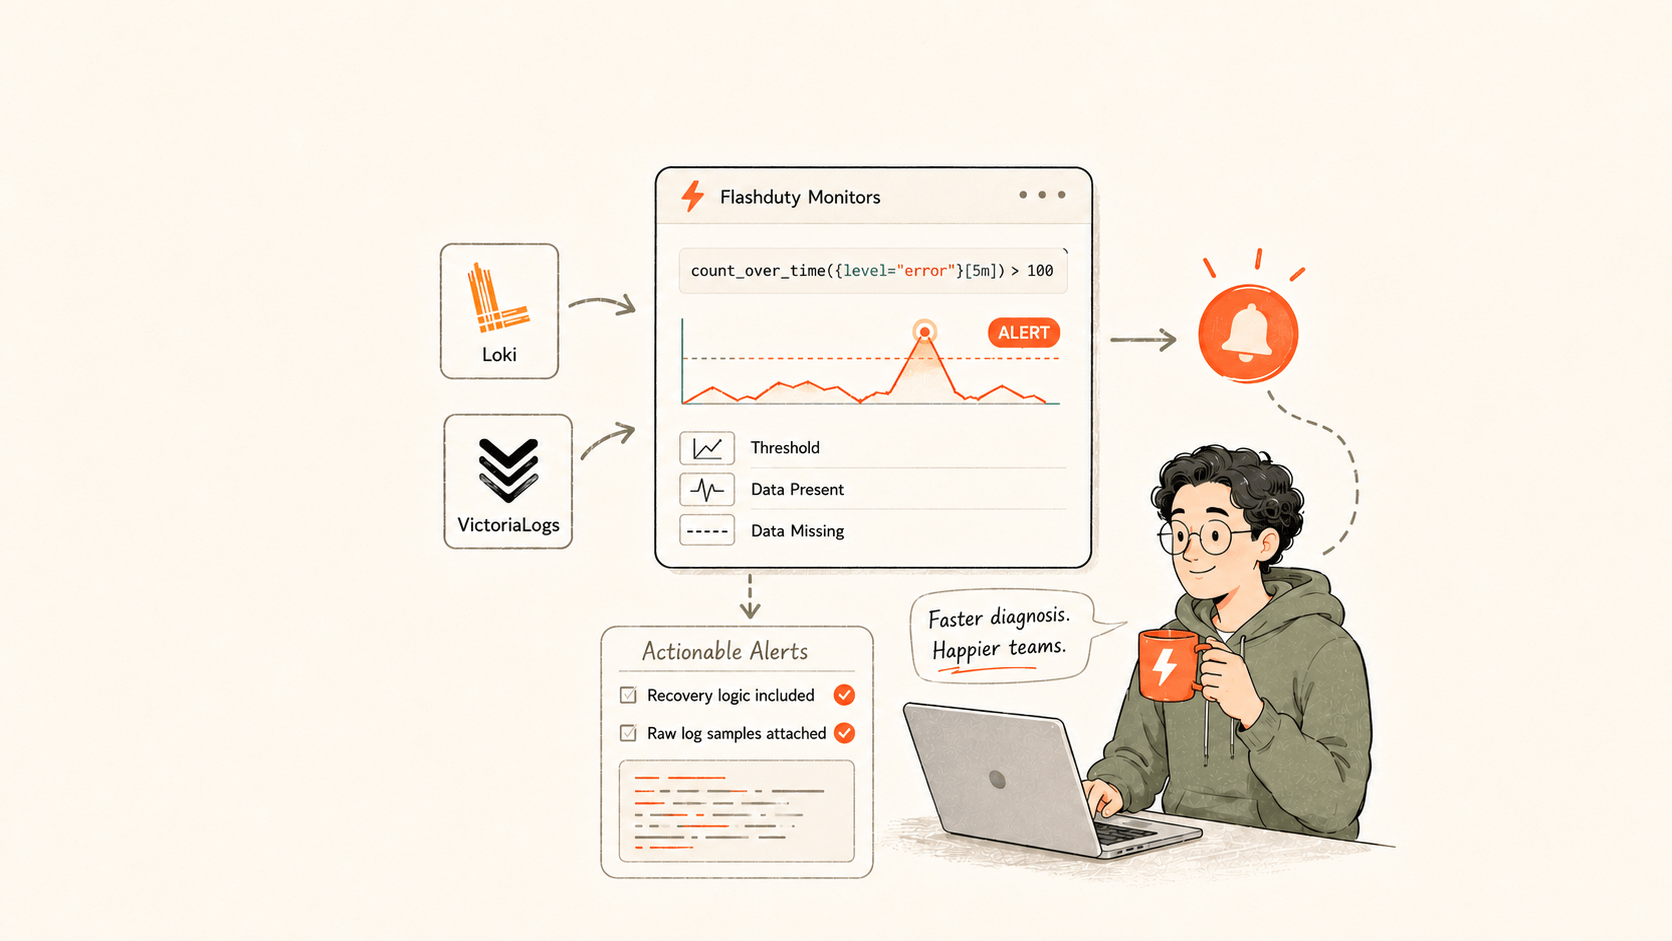
用现有的 Loki 和 VictoriaLogs 查询做告警:Flashduty Monitors 已支持
Flashduty Monitors 支持 Grafana Loki 和 VictoriaLogs 数据源,保留原生查询语法,并提供三种告警模式、独立恢复逻辑和告警中的日志原文样例。
Flashduty 工程团队
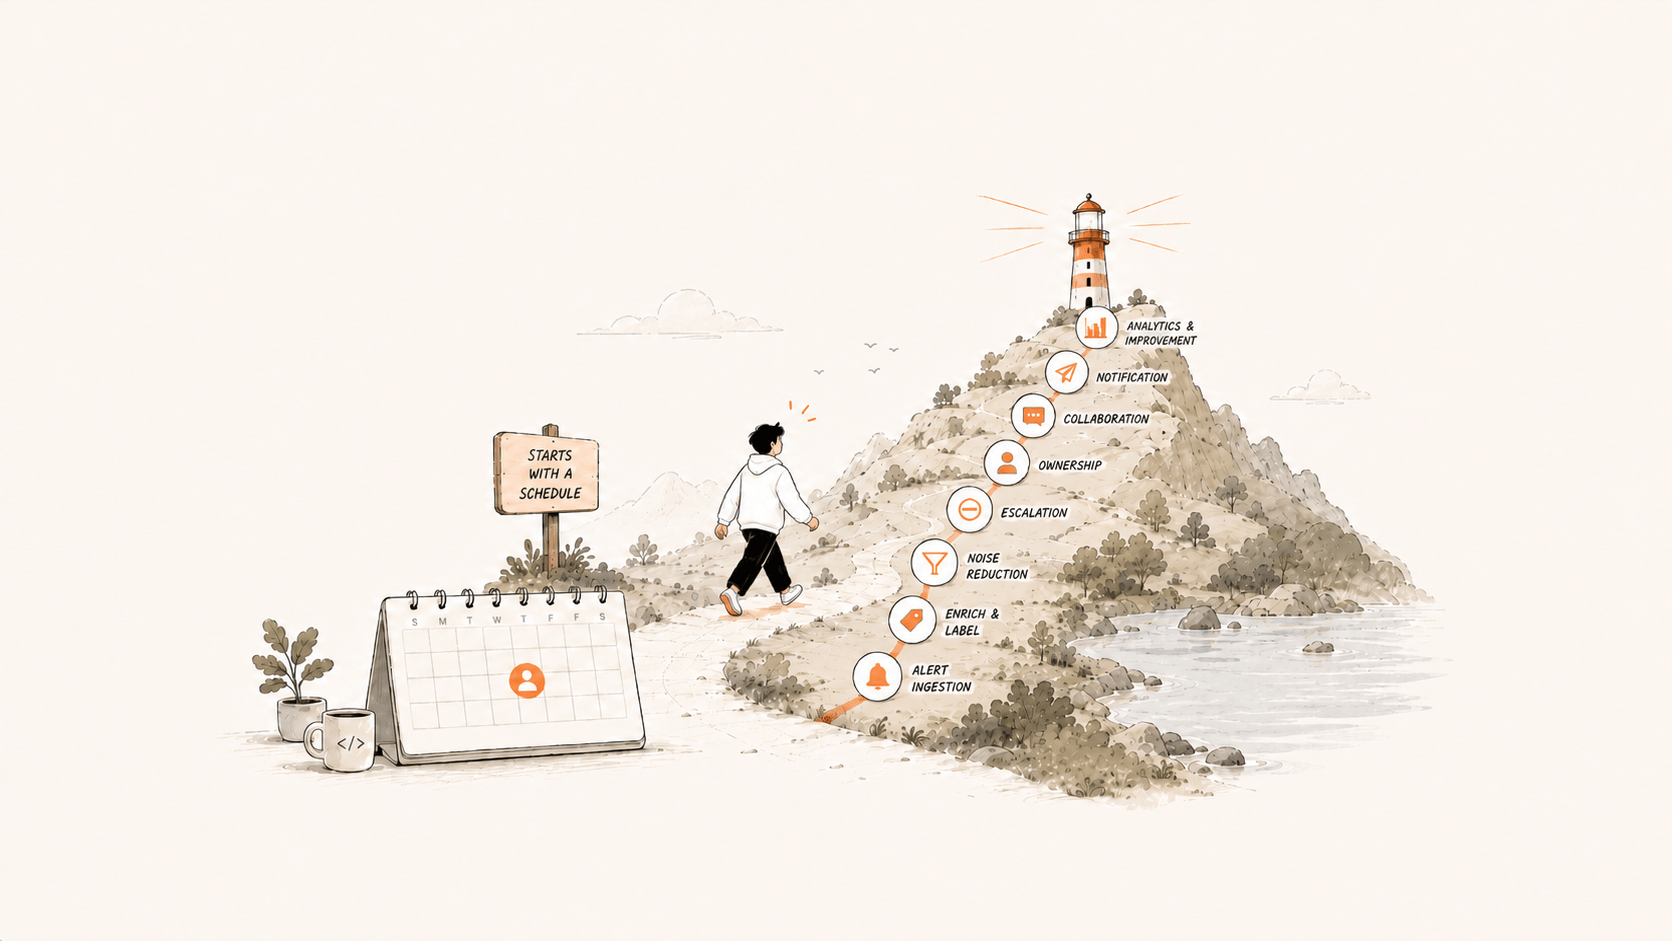
On-call 体系的八个环节:每个环节做到什么程度
On-call 远不止排班。从告警接入到统计分析,本文逐个说明八个环节为什么需要、做到什么程度、哪里容易出错。最划算的降噪,发生在告警产生之前。
Flashduty 产品团队
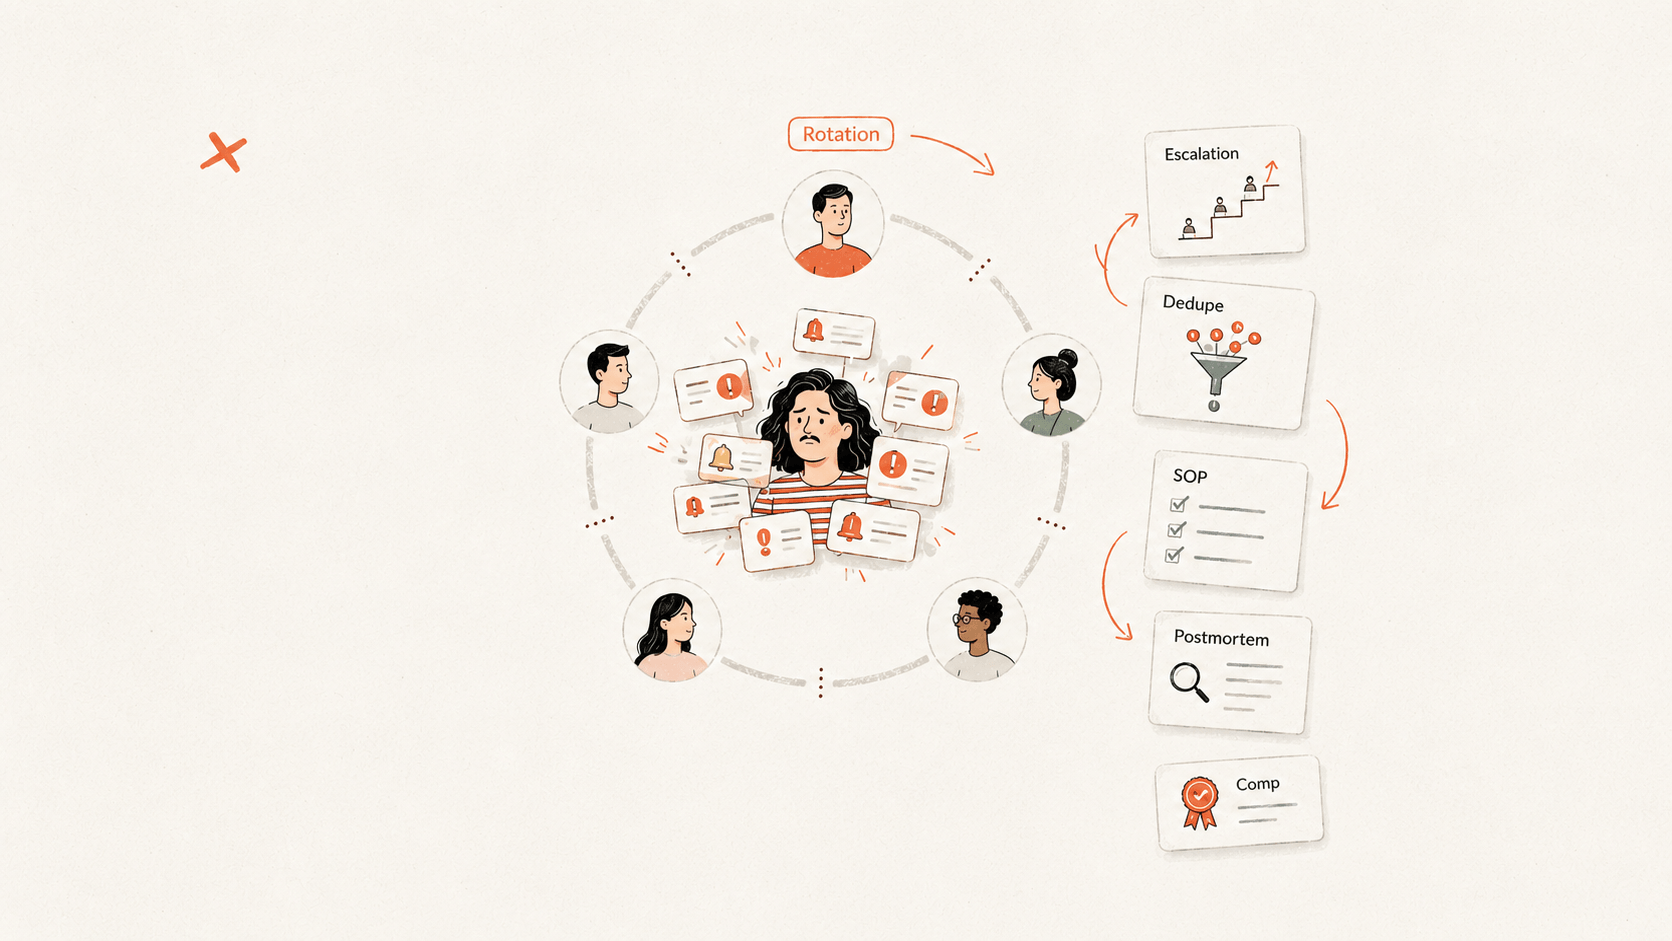
期货行业的 On-call 实践:每周数万条告警如何管理
一家上海期货公司的运维团队每周处理数万条告警。他们的做法包括四项:选用统一平台、建立值班制度、打通 CMDB 元数据、用 MTTA 和 MTTR 持续运营。本文整理自该公司技术专家在 CCF 夜莺论坛上的分享。
Flashduty 支持团队
别让 On-call 累垮最负责的人
很多团队名义上全员 On-call,实际上最负责的人承担最多值班,绩效却普通,最终离职。本文给出让 On-call 公平且可持续的六项做法,以及六个常见反模式。
Flashduty 产品团队
Google 和 Datadog 的 On-call:工具最容易复制,排班和度量才是门槛
Google 的 On-call 工具 Outalator 没有开源,但工具并非 On-call 的难点。Google SRE 和 Datadog 都把投入放在琐事上限、可持续排班和度量上。本文拆解两家的做法,并给出三项无须额外预算的起步动作。
Flashduty 产品团队