
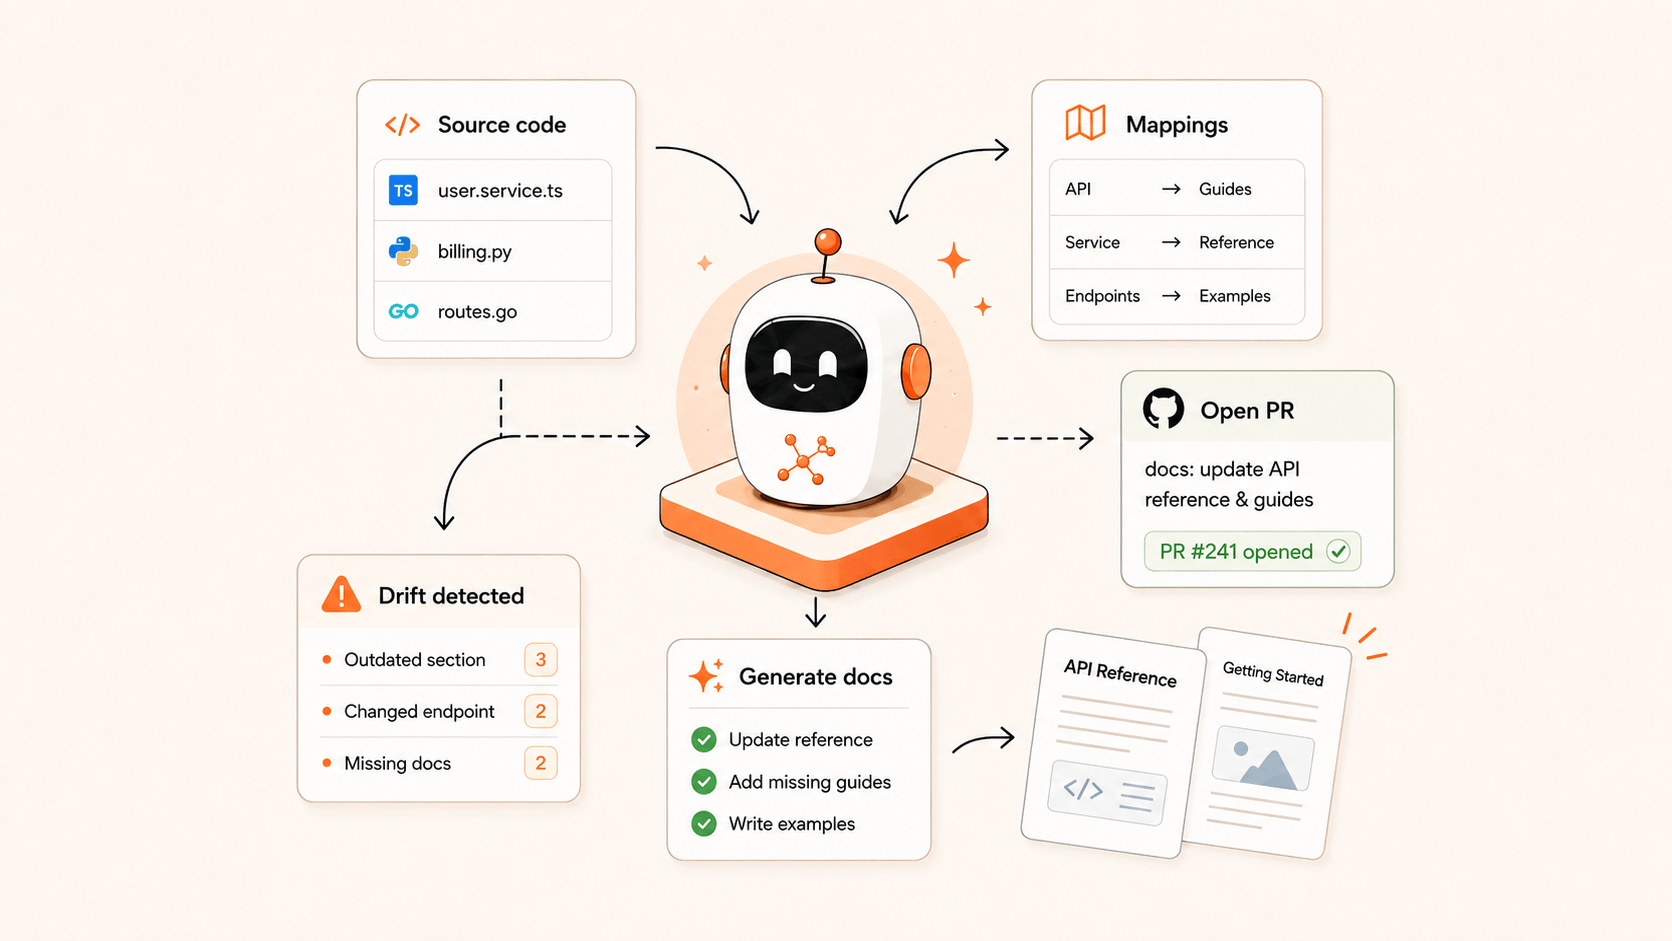
我们团队没有专职产品经理,文档更新长期滞后于代码。现在,这项工作由一个 AI agent 承担:agent 每周对照代码查找文档缺口,编写中英双语内容,然后提交 PR,工程师只负责审核。
首次运行时,agent 只检查了一个月的代码变更,就发现了 21 个缺口。全量审计发现的缺口数量是这一数字的十几倍。我们的结论是:与其反复提醒工程师编写文档,不如让文档漂移及时暴露。
下文介绍 agent 的工作方式,以及构建同类工具的方法。
一个未被记录的开关
Flashduty 的值班排班有一项功能,名为「公平轮换」。开启后,系统会自动调整轮换顺序,避免同一成员总是轮到周末值班。前端代码如下:
<div className='flex items-center'>
  {t('Fair Rotation')}
  <Tooltip>
    The system automatically adjusts rotation order to ensure
    each member gets on-call shifts across different time periods.
  </Tooltip>
</div>
<Form.Item name='fair_rotation' valuePropName='checked'>
  <Switch size='small' />
</Form.Item>
该功能的前端和后端均已实现并上线,也有用户在使用,但文档中没有任何相关说明。
用户只有在编辑轮换规则时偶然注意到这个开关,才会知道该功能存在。这就是文档漂移:它不会造成严重事故,但缺口会逐个累积,直到用户失去对文档的信任。
文档滞后的原因
我们正在开发一个 AI 客服,该客服通过阅读文档回答用户问题。文档存在缺口时,客服无法回答;文档存在错误时,客服会给出错误答案。
过去,文档质量主要影响凌晨三点被告警唤醒、查阅文档排查问题的工程师。现在,文档质量还直接决定 AI 客服的回答质量。
问题在于,文档缺少专人维护。
Flashduty 没有专职产品经理,由工程师兼任产品经理。需求分析、编写 PRD、开发、测试、部署和处理客户反馈,均由同一组人员完成。任何人的岗位职责中都不包含「同步更新文档」。
花两周开发完公平轮换的工程师,更希望投入下一个功能,而不是再花一天编写说明,因此文档没有更新。相关答案散落在飞书、企业微信和钉钉的聊天记录中,始终未进入文档。
我们有 12 个产品模块、20 多个微服务,文档包含中英两种语言、几百个页面。每合入一个 PR,都可能使某段描述失效。人工检查在理论上可行,但实际从未执行。
「请大家记得更新文档」这类提醒无法解决问题,因此我们改用自动化手段。
工具设计
我们开发了一个 Claude Code skill(技能,即可重复使用的 AI agent)。工程师可以通过一条命令运行,也可以将其配置为定时任务。
该 skill 的关键组件是一个 YAML 映射文件,记录每个文档页面对应的源码路径。agent 依据这个文件确定需要检查的代码。缺少映射时,agent 要么陷入无关的内部代码,要么遗漏关键变更。
flowchart TD
    T1["代码推送 / 定时任务"] --> SCAN["扫描源码仓库"]
    T2["手动触发"] --> SCAN

    SCAN --> DIFF{"模式?"}
    DIFF -- "diff" --> GD["读取 git diff\n识别新路由、开关、默认值"]
    DIFF -- "audit" --> WF["遍历前端代码\n盘点所有功能"]

    GD --> XREF["与文档交叉比对"]
    WF --> XREF

    XREF --> FIND["findings.yaml"]

    FIND --> AUTO{"自动模式?"}
    AUTO -- 否 --> HUMAN["工程师审核\n去除误报"]
    HUMAN --> FIX
    AUTO -- 是 --> FIX["读取源码\n生成文档(中 + 英)"]

    FIX --> PR["提交 PR"]
    PR --> REVIEW["工程师审核内容"]
    REVIEW --> MERGE["合并"]
该 skill 有两种模式。
Diff 模式回答的问题是:最近有哪些变更?agent 读取所有关联仓库的 git diff,查找与文档相关的信号:
- 新增的 API 路由或接口
- 新增的 UI 开关或表单字段
- 变更的默认值或校验规则
- 删除或重命名的功能
每个信号都与现有文档比对:文档已覆盖的信号直接跳过,未覆盖的信号记为一条发现。这一模式用于日常维护,在漂移累积之前发现问题。
Audit 模式回答的问题是:每个功能是否都有文档?这一模式更全面。它先遍历前端代码,列出所有用户可见的功能,包括页面、表单字段、开关和下拉选项,然后逐项检查文档覆盖情况。
选择前端作为起点,是因为前端最准确地反映了产品的实际能力。后端包含内部接口、预留字段、客户定制逻辑,以及界面上从不显示的保留枚举值。前端展示的内容,才是用户能够看到和操作的功能。
Audit 模式还会检查准确性:从现有文档中提取可机械核对的事实,例如字段名、默认值、导航路径和校验规则,再逐条与代码比对。例如,文档称轮换周期支持「天、周、自定义」,而代码支持的是小时、天、周、月,这就构成一条发现。
两种模式都会输出一份结构化的发现文件,随后进入修复阶段。agent 读取每条发现对应的源码,编写完整的中英双语文档(包括段落、表格和配置步骤),然后提交 PR。生成的文档内容完整,不含占位符或 TODO。工程师审核内容后合并。
检查结果
两种模式运行完毕后,agent 共提交 20 个 PR,新增 9000 多行文档,涉及 370 多个文件和几百条发现。
首次运行使用 diff 模式:/doc-review --mode diff --since "1 month"。这次运行只检查最近一个月的代码变更,产出了 PR #27。这一次运行发现 21 个缺口,修改 33 个文件,两种语言共新增一千多行文档。典型示例如下:
| 发现 | 具体情况 |
|---|---|
| 公平轮换 | 即开头提到的开关。功能完整,文档缺失。 |
| 权限体系 | 已经从扁平权限改成按作用域的权限,文档还是旧的。 |
| Nagios 集成 | 整个集成已经在生产环境运行,没有文档。 |
| 团队管理 | 团队详情页里添加成员、移除成员、退出团队,都没有文档。 |
| RUM Source Maps | Android ProGuard 和 iOS dSYM 上传流程已上线数月,从未编写文档。 |
| 协作空间导航 | 界面已经从 Tab 改成侧边栏,文档还在讲旧布局。 |
这些都是常用功能,用户却无法在文档中找到相关说明。
21 个缺口已经超出我们的预期。随后我们运行了 audit 模式,对全部前端代码进行了一次功能盘点,发现的缺口数量是 21 的十几倍。因此,我们决定将这项工作从一次性清理改为每周例行运行。
构建同类工具
构建同类工具无须从零开始。Claude Code 提供 skill-creator,可以根据描述生成 skill。以下是一个可用的 prompt 模板:
/skill-creator Create a doc-review skill that cross-references
source code against documentation to find documentation drift.

Context:
- Docs repo: company-docs (Docusaurus, English only)
- Source repos: billing-service (Go), web-app (React), api-gateway (Go)
- Docs structure: docs/ with subdirectories per product area
- Key concern: new features ship without doc updates

The skill should have two modes plus a fix phase:
1. Diff mode: scan recent git changes for doc-relevant signals
2. Audit mode: walk frontend code to inventory features, check coverage

After either mode, a fix phase generates complete documentation and opens a PR.
skill-creator 会生成映射配置、prompt 和串联逻辑。搭建框架约需一小时。调优耗时更长,我们经过约四轮调整,才将误报降低到可接受的水平。
决定效果的是写入 prompt 的设计原则。以下是我们根据实践总结的七条原则。
-
建立模块与仓库的映射。使用一个 YAML 文件,将每个文档页面与对应的源码路径关联。缺少该文件时,agent 要么陷入无关代码,要么遗漏关键变更。该文件是整套系统的骨架。
-
从前端开始盘点。前端划定了用户可见功能的边界,后端则包含内部接口、预留字段和保留类型。盘点应从前端组件出发,包括页面、表单、开关和下拉框;后端代码只用于补充前端已展示功能的细节。我们前两轮迭代从后端开始,结果被大量不应写入文档的内部工具干扰。如果产品是没有界面的 CLI 工具或 SDK 等 API 优先产品,应改用其他起点,例如 API 路由定义或 CLI 命令注册。
-
以产品经理的视角判断。在 prompt 中明确写出:「像产品经理一样,判断哪些内容应写入公开文档。」只记录用户在生产环境中可以操作的功能,跳过测试工具、调试面板、测试框架、内部管理功能和客户定制逻辑。
-
只检查可机械核对的事实,即字段名、默认值、API 路由和校验规则。描述行为的文字需要人工判断,且误报率高,应排除在检查范围之外。
-
约束条件以前端为准。后端上限为 100,而前端表单只允许填写 50 时,用户看到的上限是 50,文档也应写 50。只有文档与前端矛盾时,才记为一条发现。
-
生成完整内容。修复阶段必须读取源码,编写包含段落、表格和配置细节的完整文档。审核人员只负责润色文字,而非填补空白。这项要求决定了产出的是可用的 PR,还是一组 TODO。
-
分两个阶段执行,并在中间设置人工检查。流程为:分析、输出发现文件、人工剔除误报、修复。发现文件是两个阶段之间的检查点。误报率降至可接受水平后,可以使用
--auto跳过发现审核,但最终的 PR 仍须经人工审核后才能合并。
首次运行的结果通常较为杂乱。建议先使用 --dry-run 查看发现列表,再调整 prompt。迭代时也可以借助 skill-creator:将出错情况提供给 skill-creator,由其改进 prompt 和映射配置。
调优完成后即可实现自动化。我们使用 cron 定时任务每周运行一次 diff 模式,存在发现时自动提交 PR。检测、编写和提交均由系统完成,工程师只负责审核 PR。
经验总结
要求工程师提高写作水平,无法解决文档漂移。有效的方法是暴露缺口,再交给工程师一个内容完整的 PR。审核这样的 PR 只需五分钟;从零编写一篇文档至少需要半天,因此这项工作的优先级始终靠后。
我们原以为自己的文档质量尚可,运行结果表明差距很大。其他团队的文档很可能也存在类似规模的缺口,只是尚未检查。
AI 擅长处理繁琐的工作:阅读几百个文件、比对字段名、检查默认值与代码是否一致。判断一个功能是否需要记录、某段文字是否易于理解,仍需由人完成,因此 PR 仍然需要工程师审核。但最耗时的重复性工作已由 AI 承担。
后续计划
公平轮换开关现已有文档,其余几百条发现也已处理完毕。这只是第一步。
我们正在推进两项工作。第一,将 diff 模式接入 CI,在代码合入时检查文档漂移,像运行测试一样在缺口产生时立即拦截,而非等待每周扫描。第二,将检查范围扩展到 API 文档。目前系统主要从前端出发,而 Open API 同样需要完整的文档覆盖。
我们的文档发布在 Flashduty 文档站。现在,工程师审核文档 PR,而非从零编写文档。对我们有效的流程是:用一小时搭建框架,经过四轮调优,之后每周花五分钟审核一次 PR。