
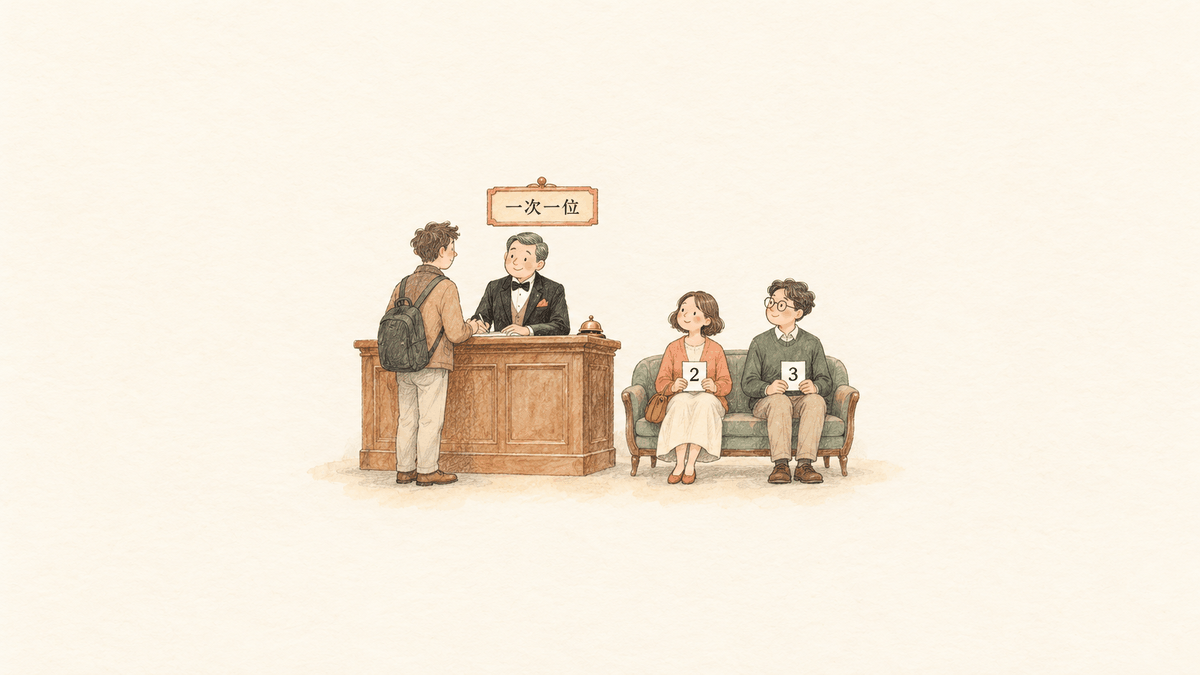
AI SRE 的每个会话只由一个处理者负责。我们使用一个 30 秒自动过期的 Redis 锁,保证同一时刻只有一个处理者。这条规则带来三个结果:消息按顺序处理,进程崩溃后其他进程可以继续处理,空闲会话几乎不消耗资源。整套机制只依赖 Redis 和 MySQL。
本文介绍这套机制的工作方式、我们遇到的问题,以及它不适用的场景。
本文是《Flashduty AI SRE 技术揭秘》系列的第 1 篇。该系列记录我们在生产环境中运行 AI SRE 的经验。
Agent 会话的难点
Agent 会话的处理时间远长于普通 Web 请求。普通 Web 请求在几十毫秒内返回,失败后由前端重试。Agent 的一次分析可能持续几分钟,需要调用十几次大模型,每次调用都产生费用。Agent 执行的命令可能改动真实环境,用户也在实时查看输出。
AI SRE 全天运行在多台服务器上。在一次分析的几分钟内,以下三种情况经常发生,必须专门处理。
- 用户追加消息,例如“同时检查慢查询”。此时模型正在等待工具结果。如果插入新消息,工具调用的顺序会被打乱,本轮分析随之失效。新消息也不能丢弃,只能排队,等待本轮结束。
- 服务器重启。每次发布新版本,服务器都要滚动下线。假设一次分析已经运行四分钟,所在进程收到了下线信号。如果没有其他进程接手,用户会一直看到加载动画,已消耗的 token 也随之浪费。
- 请求可能落到任意一台服务器。如果缺少协调,两台服务器可能同时接手同一个会话。后果是同一轮分析执行两次,同一个工单创建两次,两份输出交错写入同一份会话历史。此后 Agent 会把并非自己生成的内容当作上下文。
设计
整套设计由三项决定组成。
每个会话一个处理者
我们把处理者称为“管家”,内部名称是 actor,即专门服务一个会话的一段代码。管家开始工作前,先在 Redis 中获取锁。
- 只有在锁不存在时才能创建锁,锁在 30 秒后过期(
SET NX EX)。获取到锁的进程成为该会话的管家,其他进程立即退出。 - 管家在工作期间每 10 秒续期一次。
- 会话闲置 5 分钟后,管家释放锁并退出。
如果管家所在的进程异常退出,锁最多在 30 秒后过期,其他进程随即接手。整个过程不需要选主,也不需要人工介入。
发送方不等待处理结果
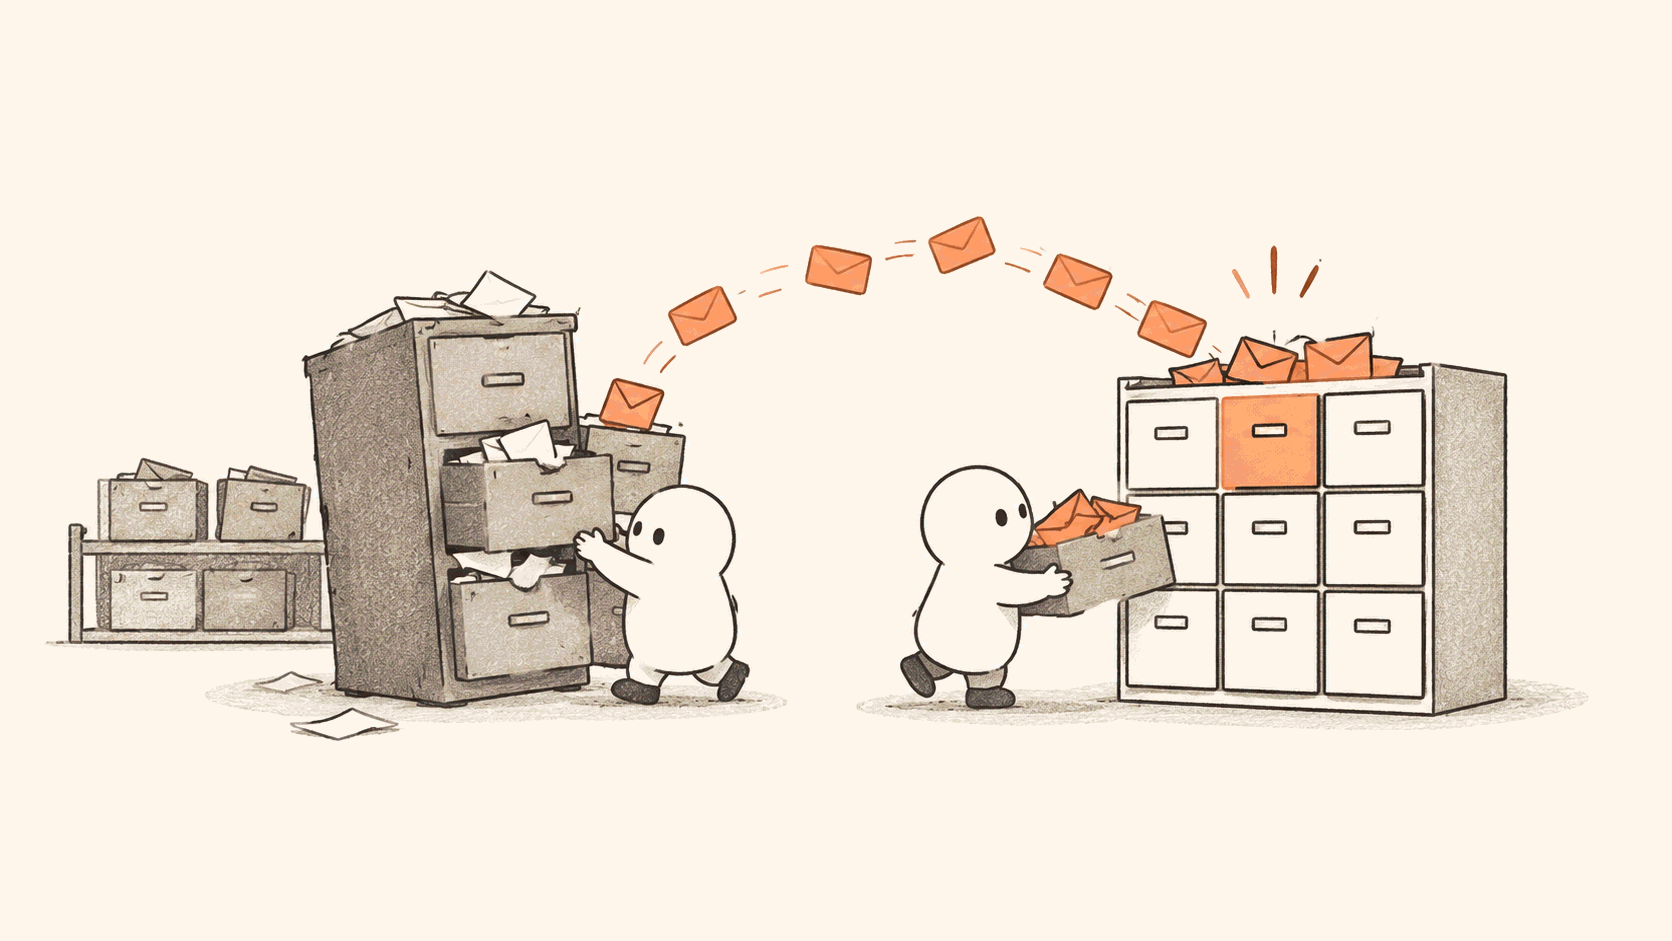
会话的消息来源有多个:网页、子 Agent 的汇报和自动化触发。每个来源只执行两步操作:先把消息追加到该会话的 Redis 列表,再发布一条 Pub/Sub 通知,然后立即返回。
管家每次取出一条消息,处理完成后将其删除。列表为空时,管家等待下一条通知。
这种设计让发送方与管家相互独立。任何服务器都可以发送消息,发送速率也不受限制。消息顺序由 Redis 列表决定,处理只在管家中进行。
空闲会话不占用资源
这项设计对成本的影响最大。大部分会话在大部分时间里处于空闲状态:用户提出一个问题后离开,半小时后才可能回来。如果每个空闲管家都以阻塞读取的方式等待,每个会话都会占用一条 Redis 连接。一万个会话就需要一万条连接。
因此,空闲的管家不占用 Redis 连接。管家在进程内存中挂起,由通知唤醒。为防止通知丢失,管家还会每 5 秒检查一次列表。用户通常几分钟后才回复,5 秒的延迟不会被察觉。这样,Redis 连接数只与正在处理消息的会话数相关,与会话总数无关。
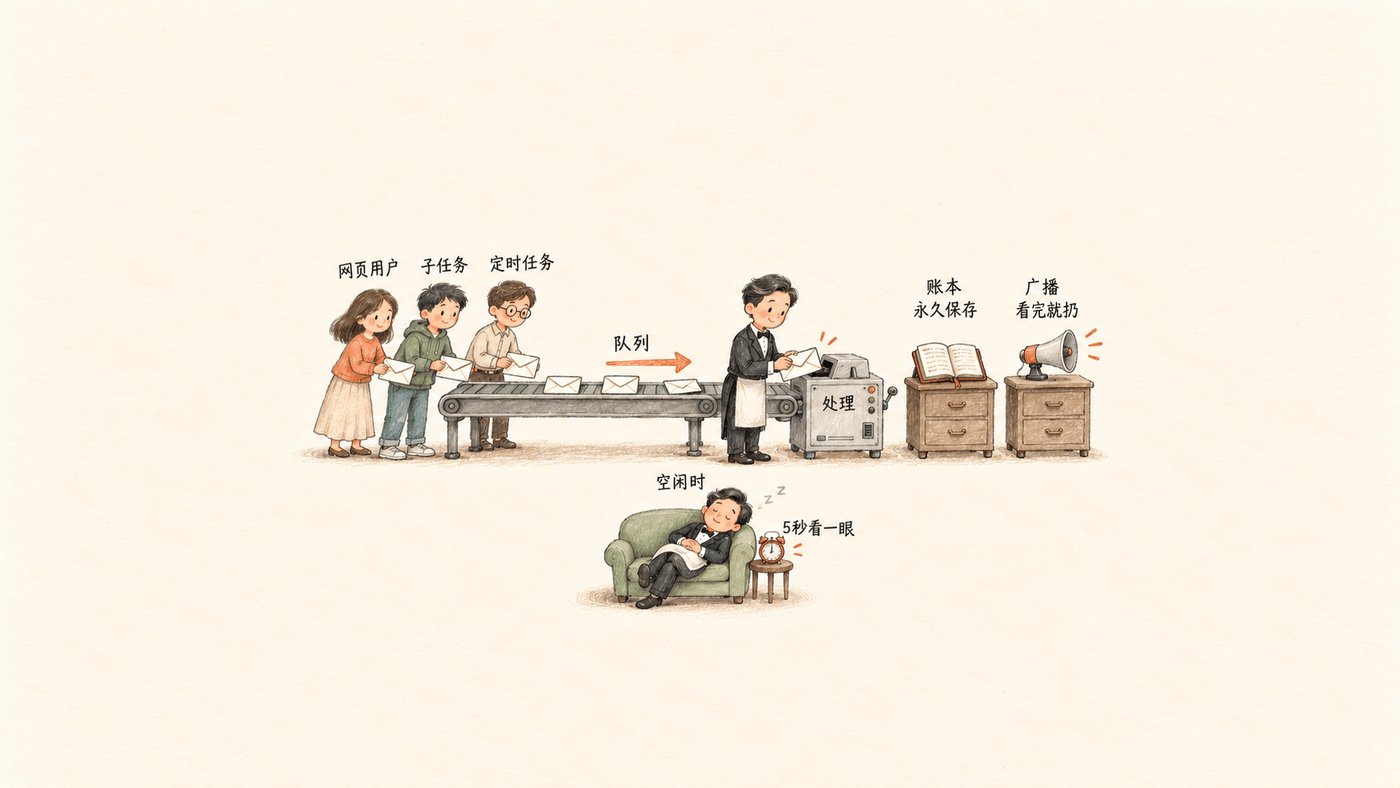
多个来源向同一队列投递消息,一个管家按顺序处理。账本保存事件,广播负责实时推送。
处理中途崩溃
上述流程存在一个缺口:管家取出消息后,如果进程在处理过程中崩溃,这条消息已经离开了列表。
为此,管家取消息时不直接移除,而是把消息移到另一个列表,即 processing 列表(LMOVE)。处理成功后,管家才从 processing 列表中删除该消息。
新管家接手时,首先检查 processing 列表。上一任管家遗留的消息,按原顺序移回待处理列表的头部(RPOPLPUSH)。这样,消息既不丢失,顺序也保持不变。代价是同一条消息可能被处理两次,因此下游的每个步骤都必须支持安全地重复执行。
还有一种情况:上一任管家并未崩溃,而是在一个耗时操作上停滞,错过了续期。锁过期后,新管家接手。旧管家恢复后,如果按原流程清空 processing 列表,就会删除新管家正在处理的消息。
解决方法是 owner token(归属令牌)。每任管家接手时获得一个 token,清理列表前先核对 token。如果 token 已不属于自己,管家就保留列表原状。锁过期只能说明持有者停止了续期,并不能说明持有者已经停止运行。
这种模式在消息队列教程中很常见。本文仍然详细说明,是因为在这个场景中,丢失一条消息就会丢失几分钟的分析结果和相应的 token 费用。
未采用的方案
我们没有使用 Redis Streams 或 Kafka。MySQL 保存每个会话的完整记录,包括每条消息、每次工具调用和每个模型回复。Redis 中的数据全部作为可重建的缓存。队列丢失时,消息仍保存在数据库中;实时通知丢失时,客户端重新连接后按游标补齐。如果再引入一套流式存储,同一份数据将保存两份,还需要持续核对两者的一致性。
我们也没有实现会话迁移和负载均衡。会话归属于获取到锁的进程。会话的大部分时间用于等待模型 API 返回,不占用我们的 CPU,因此没有迁移的必要。
最终,运行时只依赖 Redis 和 MySQL。熟悉常规后端服务的工程师,用一个下午就能读懂全部机制。
不适用的场景
这套设计要求每个会话一次只处理一条消息,单个会话的吞吐上限等于一个管家的处理能力。如果单个会话每秒需要处理几百条消息,应选择其他方案。
Agent 的负载特征正好相反:会话数量多,每个会话的消息少,每条消息的处理时间长达几分钟。管家大部分时间处于空闲状态,因此成本主要取决于空闲时占用的资源。只要控制住空闲开销,Redis 和 MySQL 就足以支撑一个多租户 Agent 平台。
消息顺序只是问题的一半,另一半是“停止”操作。用户可能随时点击停止,甚至在本轮开始之前点击。滚动发布期间,获取锁与停止请求之间存在竞态。我们曾发生一次真实事故:用户点击了停止,Agent 仍然执行完了整轮任务。后续文章将介绍我们如何使用“墓碑”(tombstone)修复这个问题。