
如果 SRE Agent 的故障分析结论过于笼统,在更换模型或调整提示词之前,先检查它能否获取排查所需的证据。模型无法调查它看不到的数据。
最近和一些团队交流 SRE Agent 时,经常听到这样的反馈:“AI 查问题不太行,给的结论很泛,跟没说一样。”更换模型、调整提示词都有帮助,但首先需要检查是否提供了足够的上下文。
假设让一位资深站点可靠性工程师排查故障,却只提供一条告警,不提供监控、日志、代码和近期发布记录,他也可能只能给出“建议检查数据库连接”之类的建议。当前主流模型已经具备较强的推理能力,但推理无法替代证据。
接入必要的数据是搭建 SRE Agent 的第一步。下面的 Flashduty AI SRE 集成页面展示了需要考虑的数据来源:
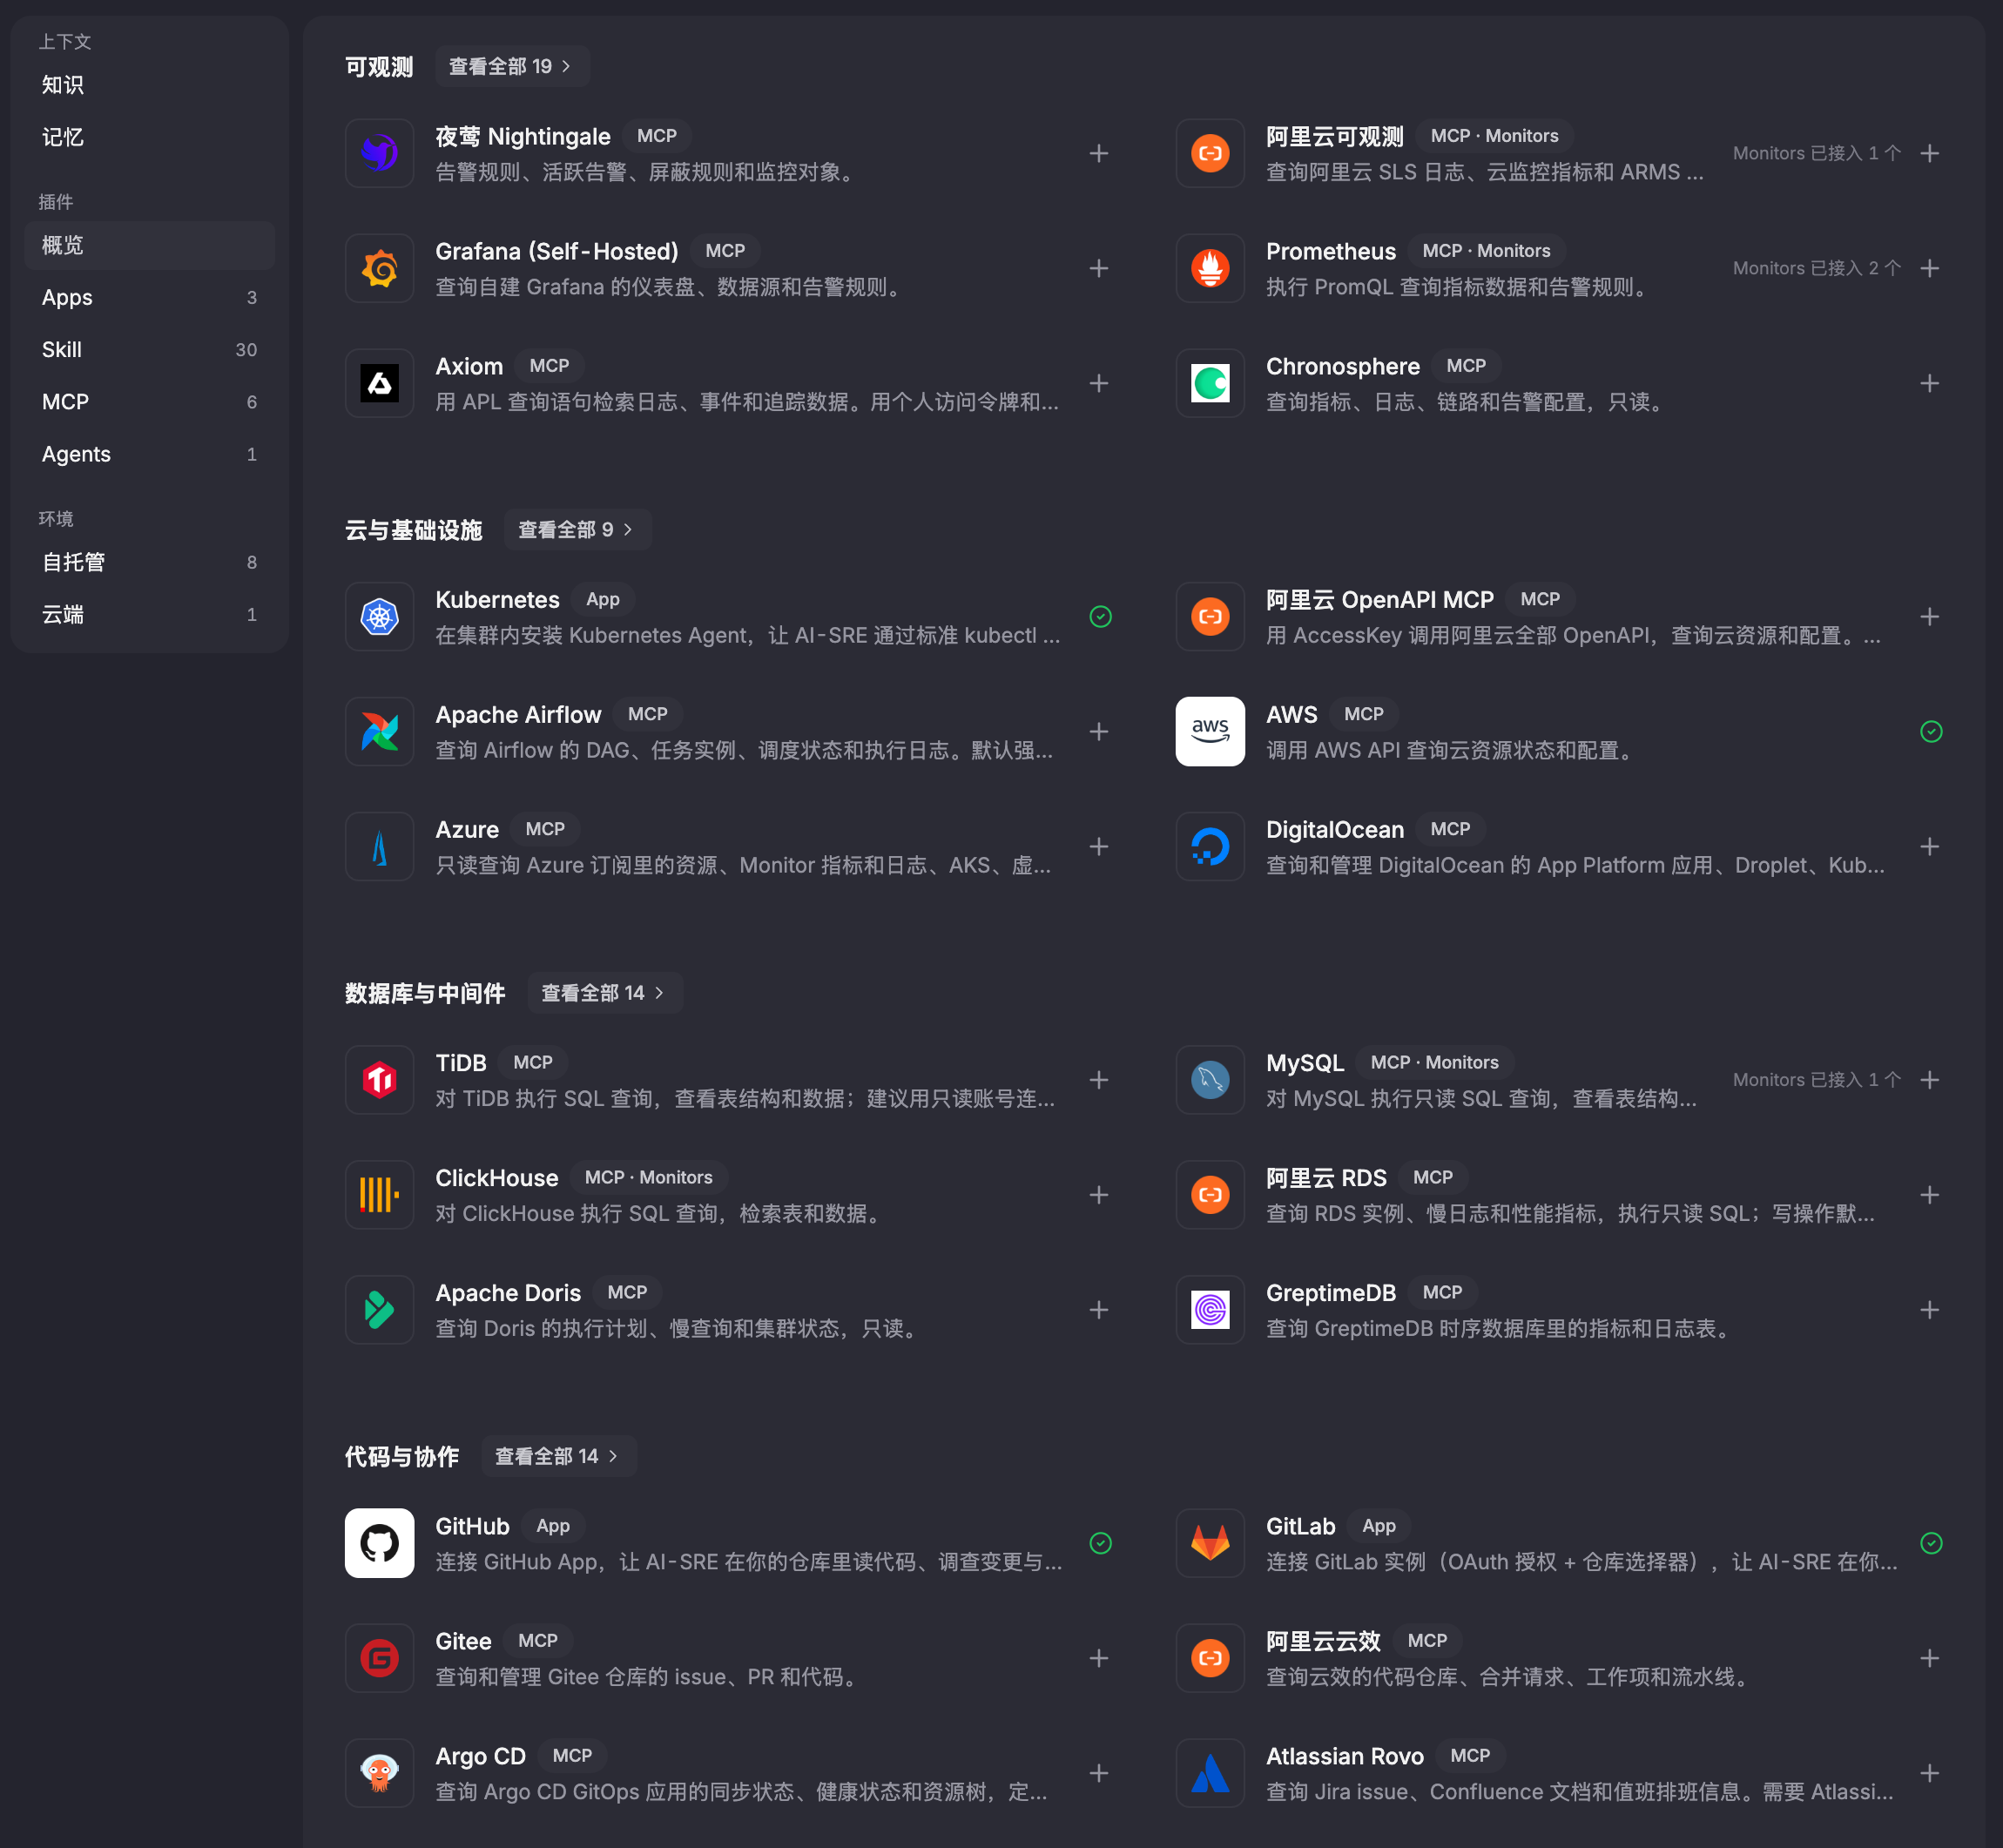
以下是我们在实践中整理的数据清单。
1. 告警事件
告警是排查的起点。除了当前事件,历史事件和复盘记录也很重要。很多故障是老问题以不同的形式再次出现。
事件质量同样影响排查效果。准确的时间戳,以及服务、地域、集群、实例等标签,可以帮助 AI 查找对应的指标和日志。告警中的排查入口和运行手册也能提供线索。告警本身怎么治理,详见想让 AI 自动排障,先把告警治理好。
2. 可观测性数据
指标、日志、链路追踪和性能剖析数据是常见的数据来源。接入数据源只是第一步,还需要告诉 AI 数据存在哪个数据源,以及查询各服务时需要使用哪些过滤条件。
例如,工程师知道某个服务的日志存在哪个 logstore,以及要按哪个 app 字段过滤。AI 需要获得这些信息,才能避免查询到其他服务的数据。
3. 实时状态数据
有些数据基数高、变化快,不适合存入可观测性数据仓库。例如 MySQL 当前的锁等待、连接列表和正在执行的慢 SQL。
这类数据需要在排查时实时获取。监控曲线可能只能显示数据库出现了问题,实时状态则可能帮助定位具体的连接或查询。
4. 配置管理数据库
配置管理数据库(CMDB)可以包含服务目录、服务元信息、依赖关系、机器信息和网络拓扑等内容。
这些信息帮助 AI 将告警放回整个系统中分析:服务由谁负责,依赖哪些服务,被哪些服务依赖,运行在哪些机器上。缺少这些信息时,AI 只能观察单个组件。
5. Kubernetes
AI 需要访问 Kubernetes 工作负载配置、Pod 状态和事件等信息。通常可以提供只读的 kubectl 访问权限,通过 Kubernetes App 或直接使用模型上下文协议(MCP)接入。Kubernetes App 由集群主动向外建立连接,无需开放入站端口,详见 AI SRE 安全访问 Kubernetes 集群。
6. 云厂商
服务运行在云上时,底层资源也可能与故障有关。例如 RDS 实例达到容量上限、负载均衡器出现异常,或者某个可用区发生波动。AI 需要通过云厂商的命令行工具或 MCP 读取云资源数据。
7. 变更
变更需要特别关注。很多故障发生在变更之后,“最近改了什么”往往是排查中最有价值的问题之一。
变更的范围比应用发布更广。应尽可能接入二进制发布、配置变更、功能开关、数据库表结构变更、接入层变更和网络变更记录。
8. 代码
代码的抽象层级低于文档,但它是事实来源。上层文档可能不完善,也可能已经过时。
过去排查时阅读代码耗时较长,很多场景下并不现实。现在 AI 可以更快地阅读代码,使这种方式变得可行。例如,查看代码可以帮助理解报错的含义。Flashduty 提供 GitHub App 和 GitLab App 集成,AI 无需依赖本地代码目录即可读取仓库,详见 GitHub / GitLab App:AI SRE 读取提交、分析 CI 日志并创建 PR。
9. 知识和技能
知识和技能有一个反直觉的特点:模型能力越强,需要的指令可能越少。
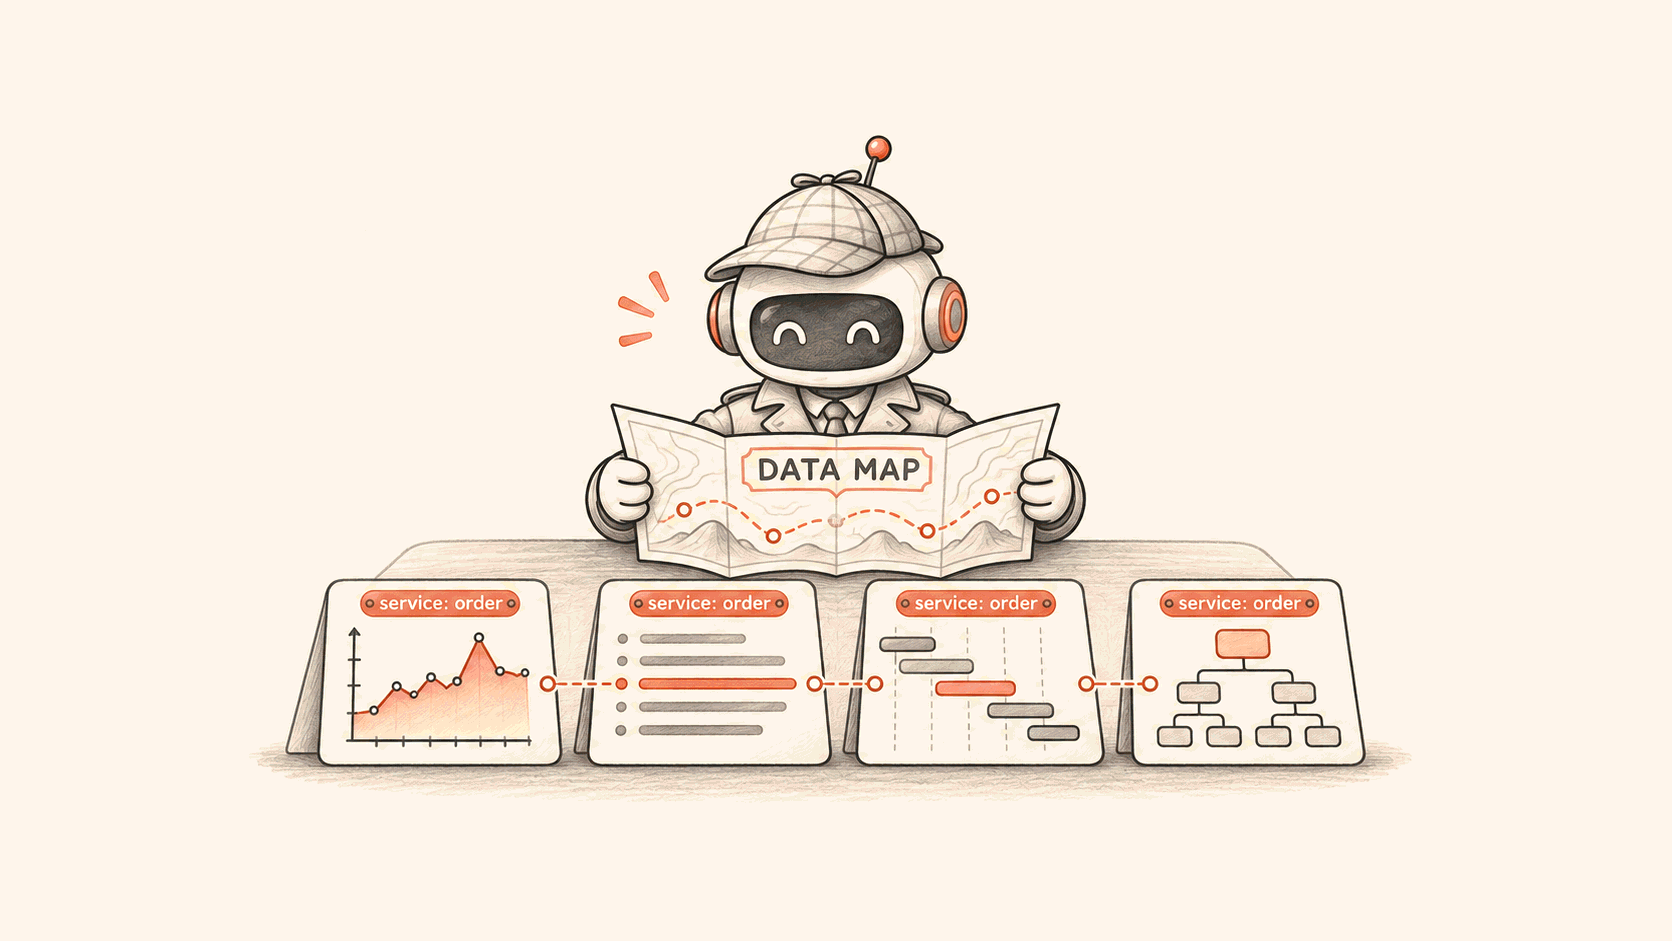
不必为每种场景编写详尽的排查手册。更有价值的是两类信息:一类是排查原则,例如“先看变更再看资源”;另一类是高层数据地图,说明各类数据在哪里。服务目录也可以整理成 Markdown 提供给 AI。
检查 AI 能否获取证据
这份清单与资深 SRE 排查故障时需要查看的内容基本一致。AI 也需要获取同样的证据。
下一次 SRE Agent 的排查效果不理想时,可以先检查:本次故障的关键证据,AI 能否获取?如果不能,缺失的上下文可能就是原因。
数据接全之后,数据的组织方式同样影响排查效果,见 SRE Agent 查不准?数据给全了,还得组织好。
为什么排查故障需要一个专门的 SRE Agent,而不是通用 Agent,见有 Codex、Claude Code 和 Cursor,为什么还需要 SRE Agent。
了解并试用 Flashduty AI SRE。