
越来越多公司开始让 SRE Agent 参与生产环境的故障排查。常见的方式是在告警详情页放一个“AI 分析”按钮:工程师收到告警,点一下,AI 开始查询指标、日志和链路,给出分析结果。
这个方式在白天还好。到了凌晨 3 点,On-call 工程师被电话叫醒,打开电脑,再点击按钮等待 AI 分析,还是慢了一步。更理想的方式是故障发生时就自动启动分析,等工程师起床,AI 已经把初步发现和排查方向准备好了。
不过,自动触发很快会碰到两个问题。很多公司的告警没有经过治理,每天产生大量告警,如果每条都让 AI 分析一遍,Token 消耗会很大。更麻烦的是告警风暴:一批告警同时触发分析,每个 Agent 都去查指标、日志、链路等数据源,查询并发可能把本来就繁忙的数据源压垮。故障还没解决,排障动作先给系统添了负担。
所以,在开启自动分析之前,有两件事值得先做。
先做告警治理
一条告警应该是 actionable 的:收到之后,有人能根据它采取明确的行动。如果一个告警响了无数次,大家的反应都是“先不用管”,那就应该重新审视这条规则。它可能需要调整阈值、降低通知级别,也可能根本不需要作为告警。
这件事可以让 AI 帮忙。把 actionable 作为判断原则,让 AI 读取告警规则、历史触发情况和对应服务模块的代码,分析告警反映的是什么、是否需要人处理、处理时可以做什么。这种方式通常效果不错:AI 可以结合代码理解告警的业务语义,而不是只看指标名称猜测。当然,规则怎么调整,仍然要由熟悉服务的工程师确认。
再做告警降噪
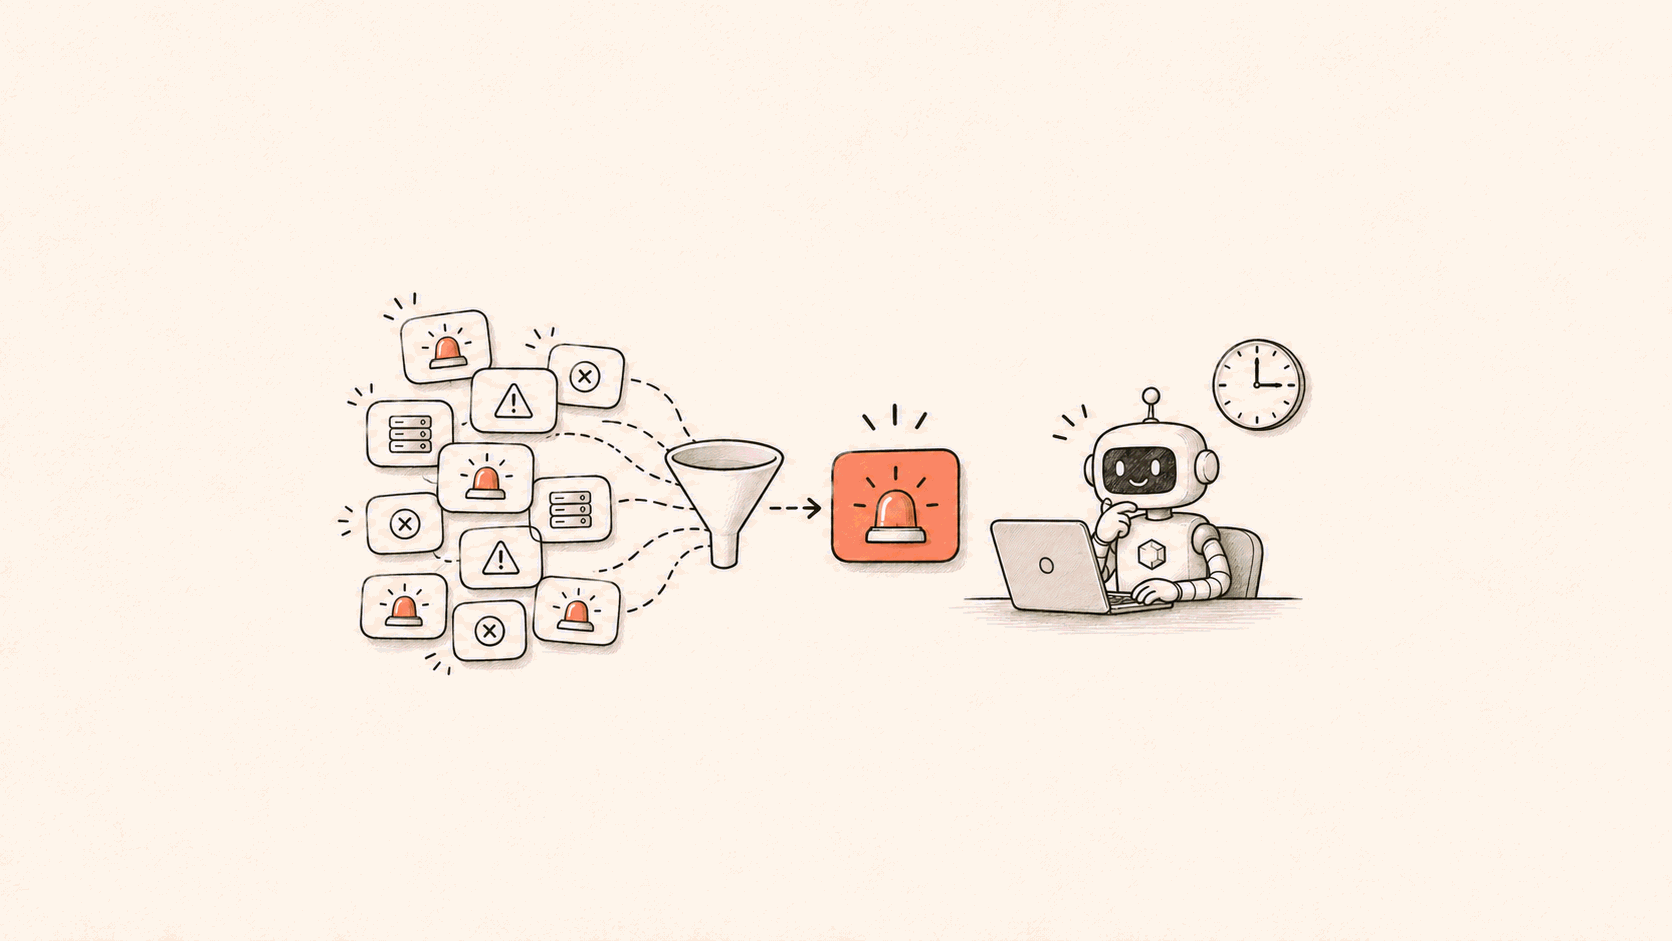
告警治理减少不该产生的告警,但即使规则都合理,一个故障仍可能引发许多告警。例如数据库出现问题,多个依赖它的服务都可能报错。逐条分析这些告警,不仅重复消耗 Token,也会让多个 Agent 查询相同的数据源。
这正是 Flashduty 这类 On-call 产品的用武之地。以 Flashduty 为例,告警信息通常经过两层聚合:
监控系统上报的事件(Event)
  同一告警的重复事件、恢复事件
             │ 事件聚合
             ▼
        告警(Alert)
  多条相关告警,如数据库和依赖服务告警
             │ 告警聚合
             ▼
        故障(Incident)
             │ 触发 AI 分析
             ▼
一份初步排查结果第一层是事件聚合:同一告警反复上报的事件,在聚合窗口内合并到一条告警。第二层是告警聚合:把相关告警合并到同一个故障中,交给 On-call 工程师统一处理。聚合需要根据服务、资源等信息配置,不能为了减少数量把不相关的问题硬合在一起。
AI 自动分析可以从故障这一层触发,让一次分析读取同一故障下的相关告警,而不是为每条告警启动一次。
但即使告警已经聚合成故障,一场风暴也可能产生多个相似的故障。Flashduty 的故障自动分析还有一层“相似故障合并分析”:同一条自动化规则收到新故障时,如果它与正在分析或近期分析过的故障足够相似,就把新故障并入已有分析会话,不再单独启动一次分析。这项功能默认开启,也可以关闭。这样既保留了新故障的信息,也减少了重复分析和查询。
告警治理决定哪些问题值得打扰人,告警降噪把相关信号组织成可处理的故障。把这两件事做好,SRE Agent 才能在凌晨先跑起来,让工程师醒来时看到有用的初步分析,而不是更多等待和一堆重复报告。
如果想了解 Flashduty 如何处理 On-call、告警降噪和 AI SRE,欢迎了解和试用:Flashduty