
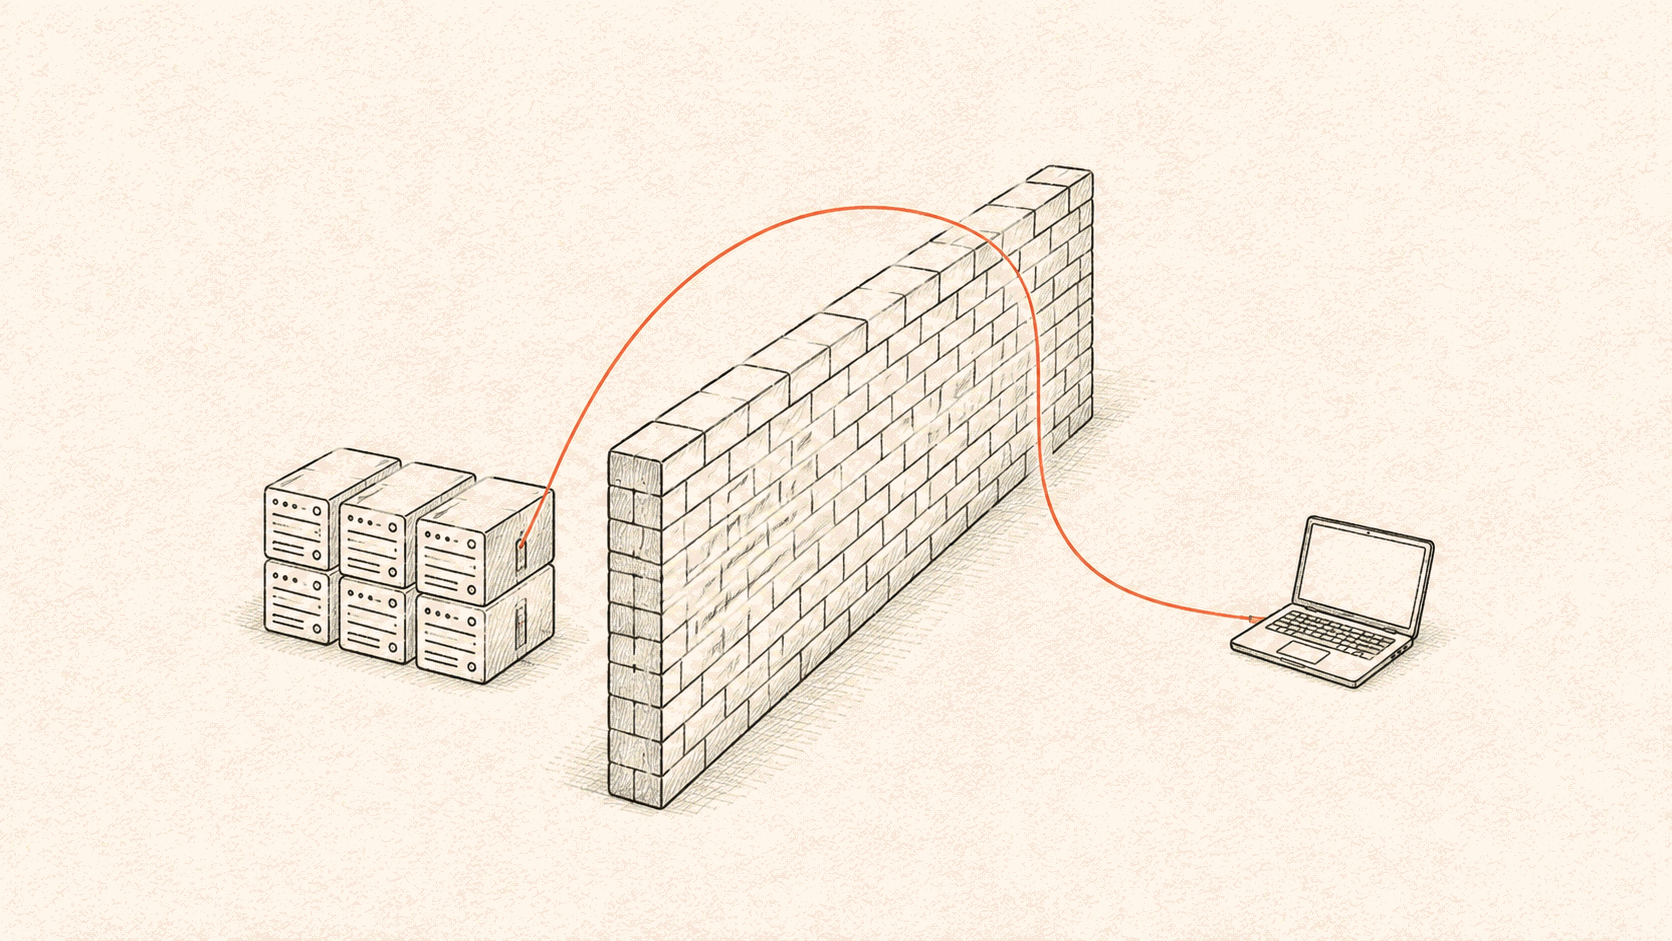
AI SRE 现在可以访问 Kubernetes 集群。集群主动向外建立连接,Agent 通过这条连接运行原生 kubectl,每个请求都由集群自身的 RBAC(Role-Based Access Control,基于角色的访问控制)判定。kubeconfig 不离开集群,也不需要开放任何入站端口。
在此之前,Agent 无法查看反复重启的 Pod。Agent 能够读取告警、代码和监控图,但无法获取 Pod 的当前状态和最近事件。Agent 只能推测原因,或者等待用户手动运行 kubectl 并粘贴结果。
本文说明三个问题:为什么放弃三种常见做法,我们的方案如何工作,以及该方案目前的局限。
设计目标
方案需要同时满足以下四个目标。
- Agent 能够使用 kubectl 的全部表达能力。
- 凭据不离开集群。
- 不开放任何入站端口。
- 权限严格受控,并且不依赖我们手工维护的能力清单。
最后一个目标最难实现。每个集群都有大量各不相同的 CRD(Custom Resource Definition,自定义资源),手写的清单在发布当天就已经不完整。接口越通用,权限越难收紧。
放弃的三种做法
做法一:提供 kubeconfig 并直连集群
这种做法的第一个问题是凭据离开了集群。另外,多数生产集群的 apiserver 不对公网开放。用户必须暴露 apiserver 并为我们的 IP 配置白名单,或者把 Agent 部署到内网中。安全团队通常不会同意这两种方案。
在托管集群上,这种做法也无法使用。EKS、GKE、AKS 的 kubeconfig 不包含凭据,只包含一段指令:调用本地程序换取令牌,例如 aws-iam-authenticator 或 gke-gcloud-auth-plugin。将该文件复制到其他机器后,它便无法使用。
这种做法的唯一优点是覆盖面完整,kubectl 支持的操作它都支持。我们的方案保留了这个优点。
做法二:部署 Kubernetes MCP 服务端
这种做法的第一个问题是覆盖面。MCP 提供给 Agent 的是预先定义的工具。如果没有人把 kubectl get pods -o jsonpath='{.items[?(@.status.phase!="Running")].metadata.name}' 这类查询或集群特有的 CRD 加入工具表,Agent 就无法执行。我们自己的平台正是出于这个原因从 MCP 改为 CLI,详见从 MCP 到 CLI。
这种做法的安全问题更隐蔽。今年 5 月披露的 mcp-server-kubernetes 漏洞 CVE-2026-46519 是一个例子。该项目的“只读模式”只在列出工具时生效,在执行工具时不生效。知道工具名称的人可以直接调用删除操作。公告指出,这个绕过无法超出 Kubernetes 已授予服务端的权限。因此,实际起拦截作用的是集群自身的 RBAC,而不是只读开关。
做法三:自建一套 Kubernetes 工具
即使只实现一小套只读工具,也存在与做法二相同的覆盖问题,我们需要持续追赶 Kubernetes API 和各集群的 CRD。自建工具还会占用上下文:每个工具的 schema 都常驻在模型的上下文窗口中,模型还需要学习从未见过的工具。模型在训练中已经掌握了 kubectl,编写 jsonpath 查询的能力超过大多数人。用工具表限制模型,相当于让一位表达流利的人只能照着短语手册朗读。
目前厂商和社区的方案基本属于这三种。因此,我们确定了三条原则:保留 kubectl 的全部能力;不直连集群;不在我们一侧做权限判定。
方案的工作方式
Agent 运行的是原生 kubectl,没有任何封装。唯一的变化是 kubeconfig 中的服务器地址:该地址指向我们的服务端点,而不是集群的 apiserver。Agent 始终无法获得真实的集群凭据,只需让 kubectl 认为凭据存在。
连接由集群首先发起。用户在集群中安装一个小型程序,该程序启动后主动连接我们的服务,并保持连接。此后的每个请求都沿这条连接回传到集群。
因此,网络问题只剩一个:集群能否访问公网。用户无须提交防火墙工单,也无须配置 VPN、跳板机或 IP 白名单。
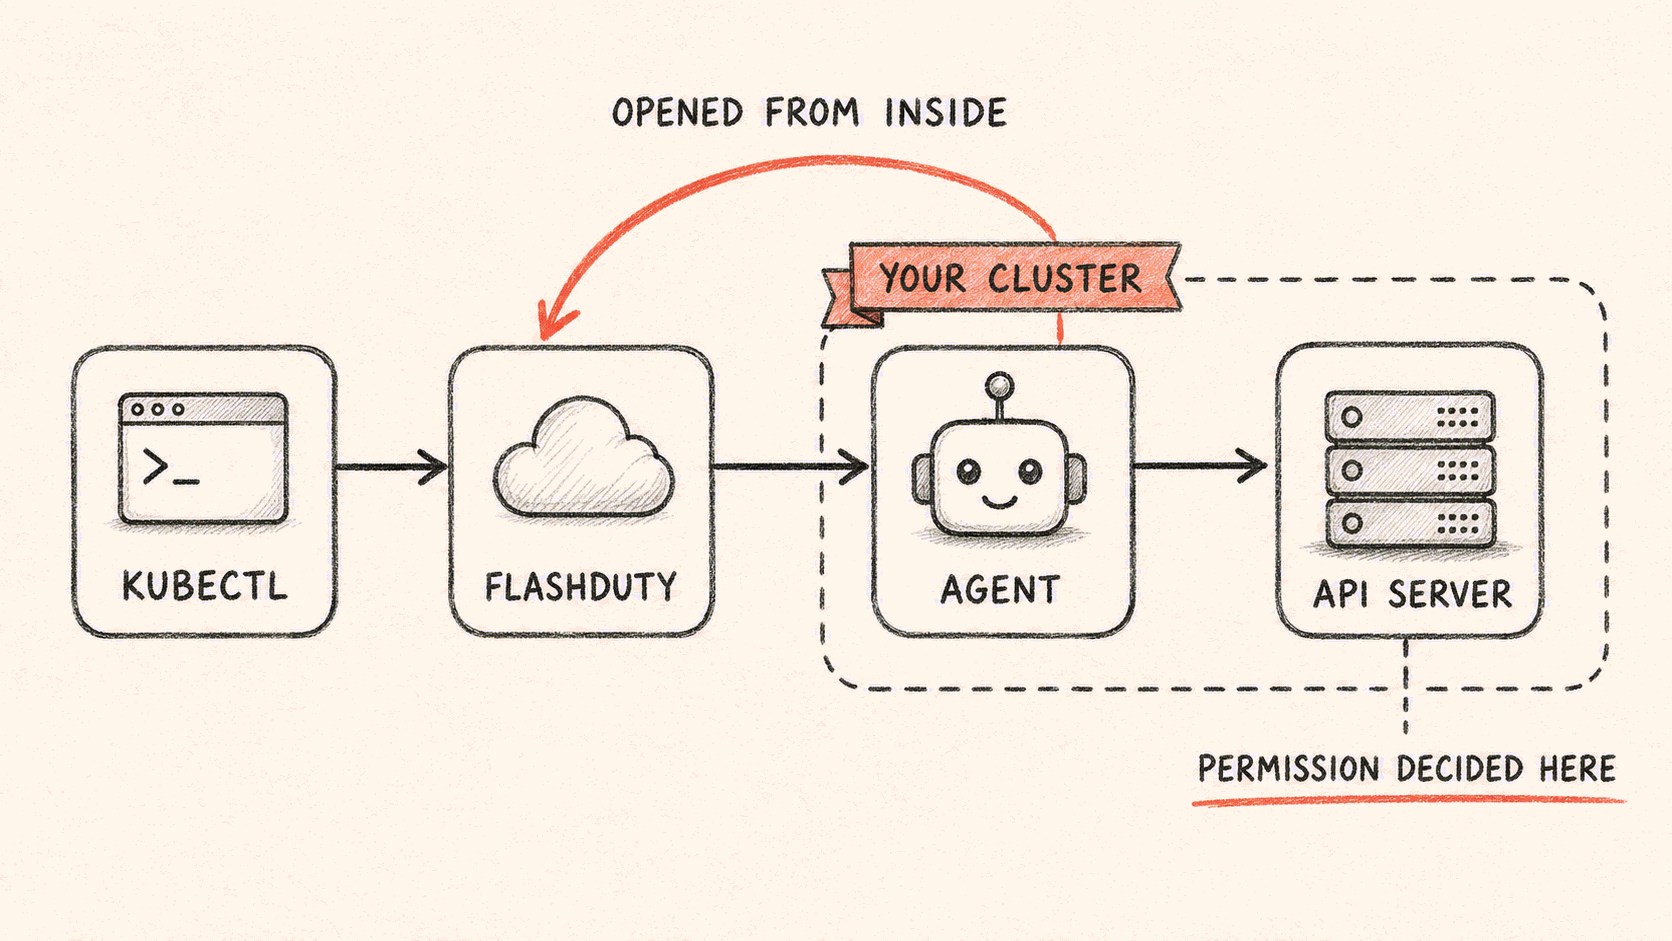
请求依次经过以下环节:
kubectl(会话执行环境)
  → 我们的公网地址 /safari/k8s/proxy/<集群>/...
  → 校验:令牌、集群归属、请求形状
  → 顺着集群拨出来的那条连接送回去
  → 集群里的转发器,原样重放给 apiserver
  → apiserver 用它自己的 RBAC 判定准不准
单个请求的限制如下:超时时间为 60 秒,请求体最大 1 MiB,响应体最大 6 MiB。连接每 54 秒发送一次心跳。
三种做法的对比如下:
| 提供 kubeconfig | 部署 MCP 服务端 | Kubernetes App | |
|---|---|---|---|
| 需要开放的入站端口 | apiserver 必须可访问 | 取决于实现 | 0 |
| 离开集群的凭据 | 完整的 kubeconfig | 取决于实现 | 无 |
| 可表达的查询 | kubectl 全集 | 仅限工具表中的工具 | kubectl 全集 |
| CRD 长尾 | 支持 | 需等待工具作者添加 | 传输层原样透传 |
| 托管集群是否可用 | 不可用 | 取决于实现 | 可用 |
| 在集群中运行的程序 | 无 | 取决于实现 | 一个 2.7 MB 的二进制文件,不含 shell |
该连接采用请求–响应模式,因此不支持流式命令,详见文末的“边界与局限”。
精简的转发器
集群中的程序只负责转发请求。我们将其精简为一个静态二进制文件。
docker run --rm --entrypoint sh \
  registry.flashcat.cloud/public/flashduty-k8s-agent:v0.1.0 -c 'echo hi'

exec: "sh": executable file not found in $PATH
镜像中不包含 bash、sh、ash、dash、busybox、kubectl、curl、wget、cat、ls、env、python 和 perl。整个镜像大小为 2.7 MB,共 2 层。
这样设计的原因是:即使我们一侧被完全攻破,攻击者在集群中也找不到可以执行命令的 shell。镜像是公开的,用户可以运行上面的命令自行验证。
多集群与单一 kubeconfig
Agent 使用原生 kubectl,因此多个集群直接对应 kubectl 已有的 context 概念。
每轮对话开始时,平台会重写 Agent 执行环境中的 kubeconfig,写入该会话当前可见的集群。每个集群对应一个 context,各自携带独立的地址和令牌。由于凭据不共用,各集群在凭据层面相互隔离。Agent 切换集群时,使用其已经掌握的命令:
kubectl --context <集群别名> get pods -n payment其中有两个设计细节。
第一,只有一个集群时,平台才设置默认 context;有两个及以上集群时,平台有意不设置默认值。注入给模型的说明要求模型不要猜测默认 context,先运行 kubectl config get-contexts,不确定时询问用户。这样可以避免命令因 prod 恰好是默认值而误发到 prod 集群。
第二,该文件每轮都会重写。没有任何允许访问的集群时,平台写入一个空文件。因此,权限收回后,对应的 context 在下一轮就会消失。已停用的集群不会被写入该文件。
由 Kubernetes 判定权限
我们曾实现过一个版本:4 个专用的写操作工具,每次执行前都要求人工确认。后来我们删除了整个版本。
在 apiserver 之前进行的任何检查都只能起到建议作用。Kubernetes 已经具备完整的权限体系,涵盖主体、资源、动作和 namespace。如果我们再增加一层权限,安全性并不会提高,反而会多出一套需要维护和审计的体系,而且这套体系更弱。
因此,权限只在一处定义:由控制台生成、由用户自行 apply 的 RBAC YAML 文件。权限分为三档:
- 只读:绑定 Kubernetes 内置的
viewClusterRole,对常见资源具有 get、list、watch 权限。 - 读取 + 有限修改:在只读基础上只增加两项操作,即调整副本数和驱逐 Pod。
- 完全权限:绑定内置的
cluster-admin,不设任何限制。
只读档最初是我们手写的资源清单,后来改为直接绑定内置的 view,原因有两个:手写清单曾遗漏 configmaps;手写清单也无法跟上 CRD 的增长。view 由上游维护,始终不包含 secrets。view 还带有一条 aggregationRule:operator 将自身 CRD 的读权限标记为 view-safe 后,这些权限会被自动纳入。生成的清单主要包含以下绑定:
roleRef:
  kind: ClusterRole
  name: view  # 内置只读面,不含 secrets;view-safe 的 CRD 自动聚合
  # …完整的三档 YAML 由控制台生成,配置说明见文末的产品文档
有限修改档遵守一条规则:不能改变 Pod 的有效 spec。镜像、命令、环境变量、身份和挂载都不能修改。该档只能调整已声明 spec 的副本数量,或者驱逐 Pod,由控制器按原样重建。
这条界线的依据是:如果允许修改 spec,就可以把命令改成打印挂载的凭据,再通过只读档已有的 pods/log 读取结果,整个权限模型便会失效。
代价是 kubectl rollout restart 和 rollout undo 同样无法使用。这两个命令都是对工作负载的 PATCH 操作,任何授权层都无法区分真实的回滚与被替换的模板。重启可以用逐个驱逐 Pod 的方式替代。回滚没有替代方式,Agent 只能建议由人工执行。
这份 YAML 文件由用户自行阅读和 apply。用户可以直接核查权限边界,无须依赖我们的描述。
不过,仅依靠 RBAC 并不足够。RBAC 只判断动作和资源,无法识别一个接口的实际行为。安全公司 Horizon3 公开过一个例子:某个账号只拥有 nodes/proxy 的读权限,从权限定义看属于只读,却能通过 kubelet 执行任意命令。原因是建立连接使用的是 GET 请求,RBAC 将其视为读操作。上游将该问题标记为不修复。
因此,我们在自己一侧增加了一项检查。该检查限制的是请求的形态,而不是权限。我们按 / 拆分请求路径,任何一段等于 exec、attach 或 portforward 时直接拒绝。携带 watch=true 或 follow=true 的请求同样被拒绝。
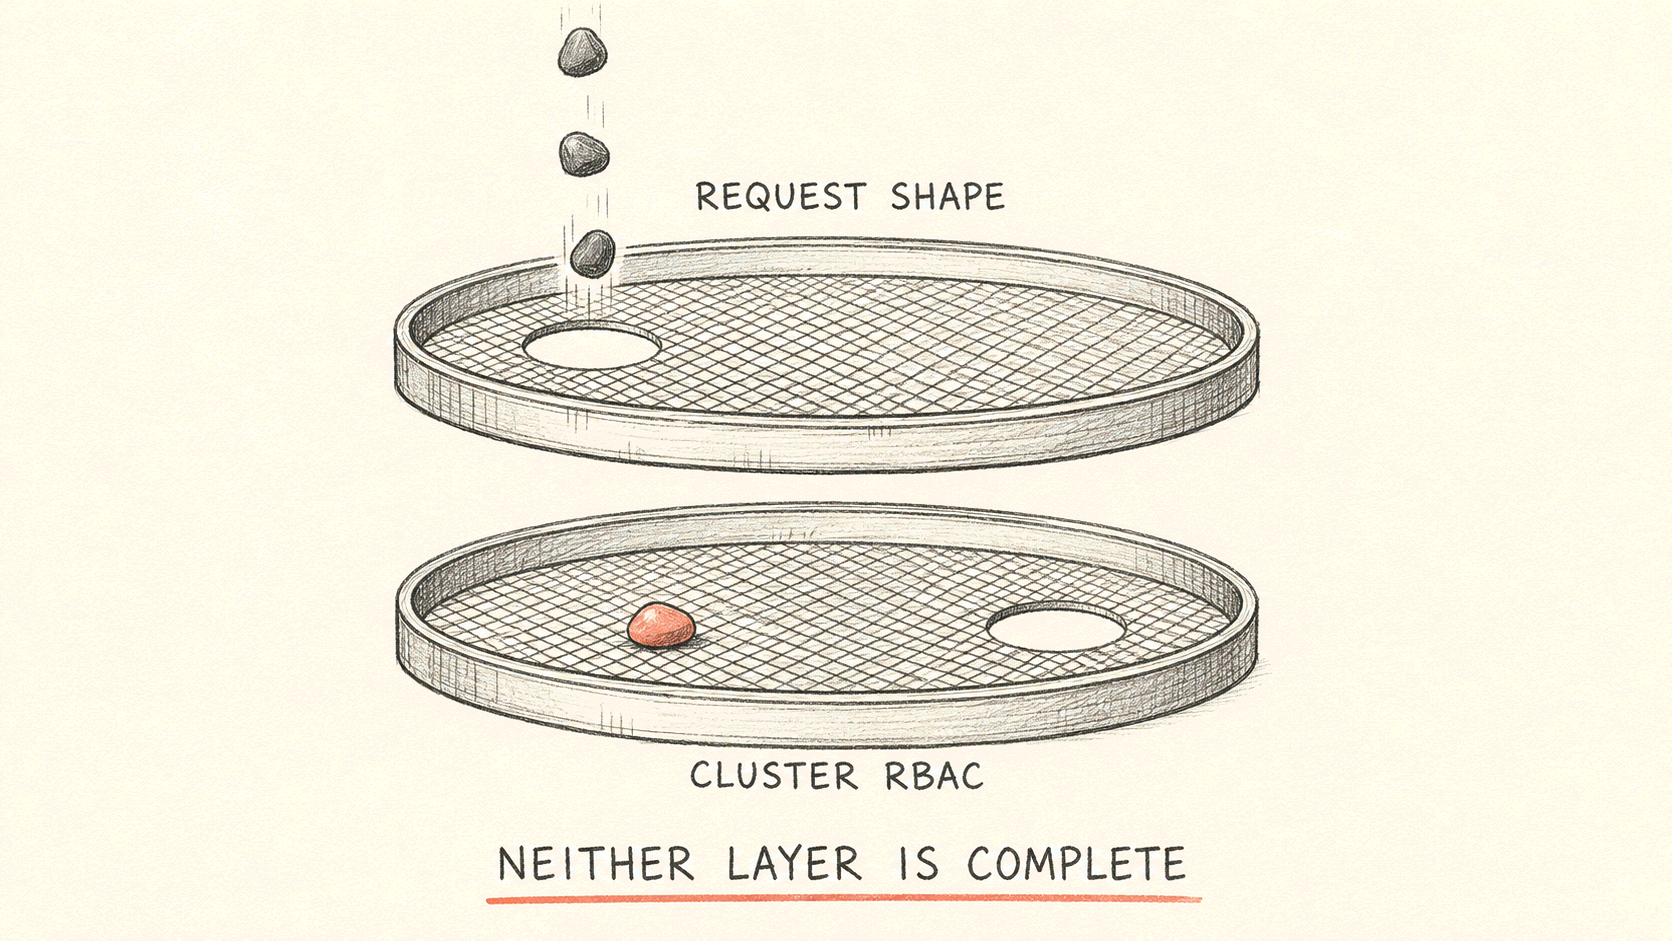
两层检查各自的覆盖范围如下:
| 能够拦截 | 无法拦截 | 兜底措施 | |
|---|---|---|---|
| 我们一侧的请求形态限制 | 路径中含 exec、attach、portforward 的请求,包括 kubelet 的 .../proxy/exec/... | kubelet 的其他执行入口(例如 .../proxy/run/...)不在列表中 | 我们不授予 nodes/proxy 权限,此类请求在 apiserver 处被拒绝 |
| 集群自身的 RBAC | 只读档和“读取 + 有限修改”档均不包含 nodes/proxy | “全部 namespace + 完全权限”不设限制,包含该权限 | 只有控制台上的红色警告,能否守住取决于使用者 |
任何一层单独使用都不完整,安全性来自两层的重叠。
由用户执行安装
如果用户提供集群凭据,控制台可以代为完成全部安装。但这正是已被放弃的做法一。
因此,控制台生成一条命令,由用户自行执行。这增加了一个操作步骤,换来的是用户可以在 apply 之前审阅全部内容。该命令运行在生产集群上,因此脚本采取了以下防护措施:
- 整个脚本体包含在
main() { ... }中。下载被截断或被篡改时,脚本会在语法检查阶段失败,不会执行不完整的脚本。 - 脚本首先用
kubectl auth can-i检查所需的八项权限。缺少任何一项时,脚本列出缺失项并退出,同时输出No cluster resources were changed.。 - 脚本先运行
kubectl apply --dry-run=server,由集群的 apiserver 验证清单,然后才正式安装。 - 卸载时只按精确的归属标签删除资源,不使用“标签存在”这类宽松条件。卸载只删除该 App 安装的资源,保留共享的 namespace。
- 安装和卸载命令的链接在 10 分钟后失效。
在控制台中,Kubernetes App 与 GitHub、GitLab App 位于同一目录,但接入方式不同。GitHub 和 GitLab App 通过授权流程换取凭据,详见GitHub / GitLab App:AI SRE 自己读提交、翻 CI 日志、开 PR。Kubernetes App 则由集群主动向外建立连接。
边界与局限
- 不支持流式操作。
logs -f、exec、port-forward和watch均不可用,跟踪变化需要轮询。 - 只读档的范围与内置
view相同:包含常见资源,始终不包含secrets。CRD 是否可读,取决于其 operator 是否将读权限标记为 view-safe。未标记的 CRD 需要完全权限档才能读取。 - 有限修改档不能修改 Pod 的 spec,包括镜像、命令和环境变量,只能调整副本数和驱逐 Pod。因此
rollout restart和rollout undo不可用。重启通过逐个驱逐实现,回滚交由人工执行。 - “全部 namespace + 完全权限”不设任何限制。控制台上的红色警告应当认真对待。
- 吊销只会切断连接。集群中已安装的资源会保留,直到用户执行卸载。
功能说明详见这条更新,配置步骤详见产品文档。如需试用,请在控制台的“AI SRE → Apps(插件)”中创建一个 Kubernetes App,先授予单个 namespace 的只读权限,再查看 Agent 的排查结果。