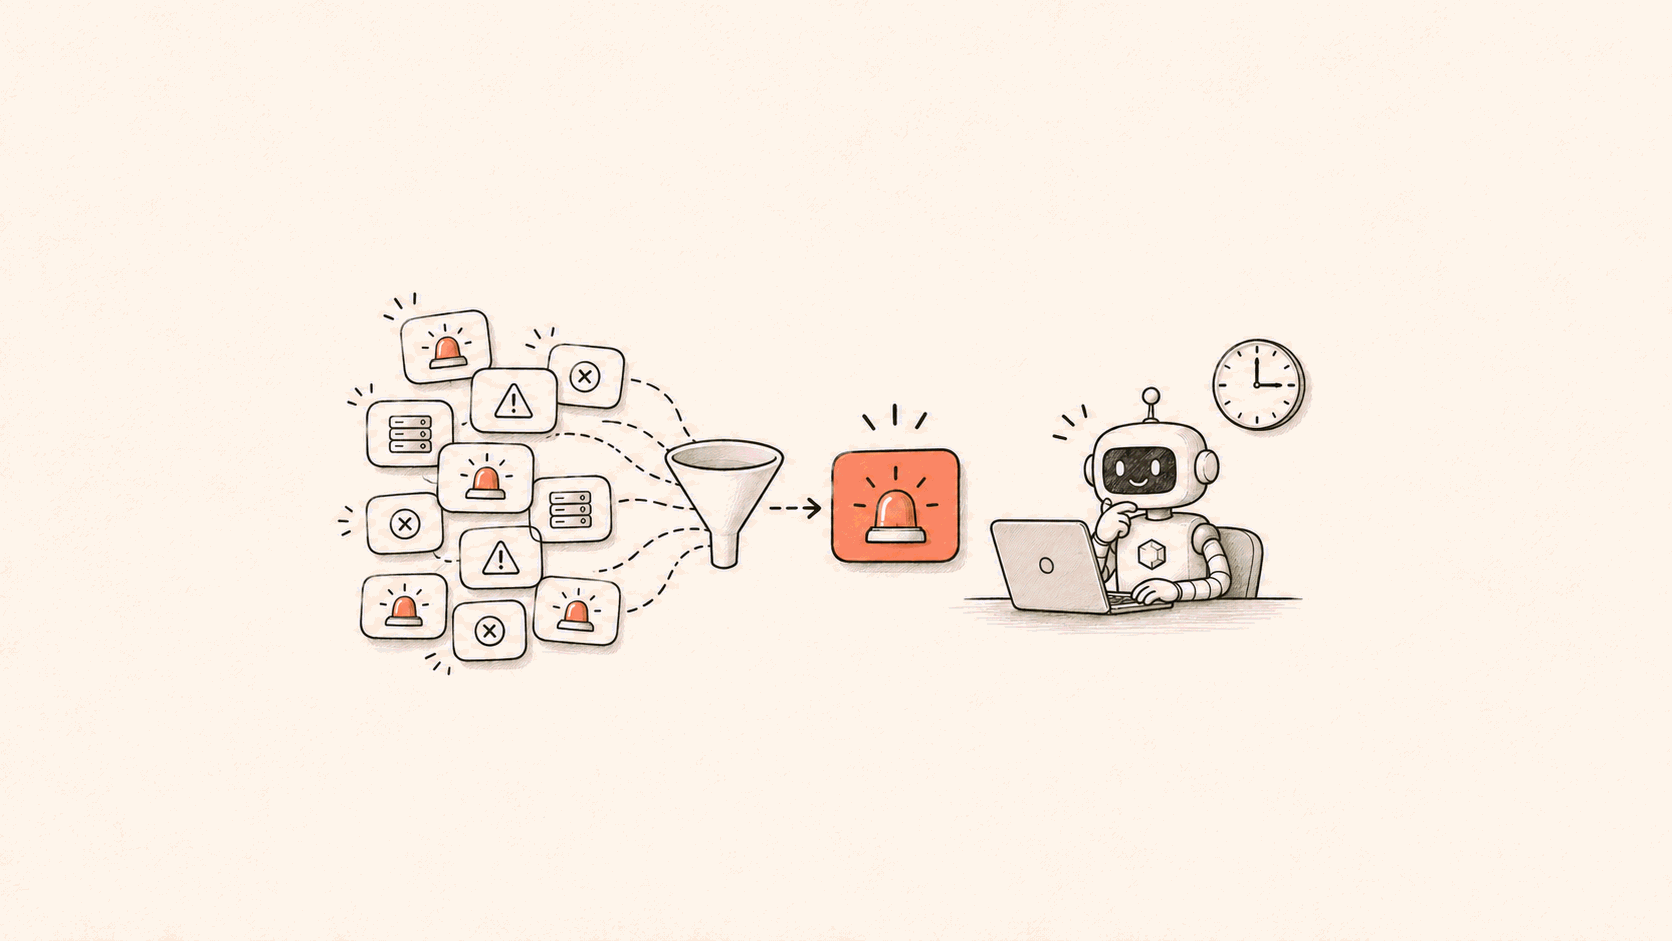

数据接全之后,SRE Agent 仍然可能查偏、查慢、抓不住重点。这时问题多半出在数据的组织方式上。核心原则是:数据要规范,易于 AI 处理。具体可以从三个方面入手:渐进式、语义一致、数据串联。
上一篇讨论了 SRE Agent 排查效果不好时,首先要检查数据是否给全。本文接着讨论数据接全之后的问题。
我们在不少团队中看到过这样的情况:
- 指标、日志、链路和 CMDB 都接给了 AI,AI 却在几十个数据源里反复尝试,查了二十次才找到对应服务的日志。
- 日志里的服务叫
order-api,指标里叫order_service,CMDB 里叫“订单中心”,AI 无法判断这是同一个服务。 - 一个小时的原始日志被直接放进上下文,关键的几行错误淹没在几十万行正常请求里。
这些问题与模型能力关系不大。一位刚入职的资深 SRE 面对同样的数据,也会犯同样的错误。老员工能够依靠隐性知识补齐缺口:知道某个服务的日志在哪里,知道两个名字指向同一个服务,知道应该先看哪张大盘。AI 没有这些隐性知识,只能依据提供给它的信息排查。
先给数据地图,再给细节
提供数据地图
工程师排查问题时,通常不会直接翻日志,而是先看全局大盘,定位可疑的服务,再下钻到指标和日志。AI 也应该按这个顺序排查。
第一步是为 AI 提供一份数据地图和概览,说明以下内容:
- 有哪些数据源,每类数据存在哪里。
- 查询每个服务时需要带上哪些固定的过滤条件。
- 核心大盘有哪几张。
这份地图不需要很长,一页 Markdown 即可。它能让 AI 一开始就找对方向,避免在大量数据源中盲目尝试。
盲目尝试的代价很高。每次无效查询都会占用上下文窗口。查询次数越多,前面的有用信息越容易被挤出上下文,最终结论也越不可靠。
用算法把原始数据压缩成特征
第二步是先用算法提取特征,再把结果交给 AI,避免直接提供原始数据。
以指标为例,一条曲线可能有上千个数据点。直接提供给 AI 既消耗 token,模型也不擅长从一长串数字中判断趋势。更好的做法是提供一个 metrics_trend 工具,返回加工后的结论:基线是多少,何时开始变化,变化幅度多大,哪些维度(例如哪个实例、哪个接口)贡献了主要变化。
日志同理。一个小时可能有几十万行日志。可以提供一个 log_pattern 工具,把日志聚类成模板,返回每个模板的数量和首次出现时间,再与故障前的基线时段对比。“告警前 5 分钟新出现了一个 connection refused 模板,共 3000 条”这样一条结论,比 3000 行原始日志有用得多。
这里的分工是:数值计算、聚类和对比交给算法,算法又快又准;推理、关联和下结论交给模型,这是模型擅长的工作。让模型统计数量,是在使用它的短处。
同一个对象只用一个名字
统一命名
同一个监控对象在不同数据源中应该使用相同的名字。指标的 service 标签、日志的 service 字段、链路中的服务名、CMDB 中的服务标识和告警事件的标签,最好都是同一个值。
标签的 key 也要统一。有的地方叫 service,有的叫 app,有的叫 app_name;环境有的写 prod,有的写 production。工程师看一眼就能识别,AI 只能推测。推测错误时,AI 会查到其他服务的数据。
如果不确定如何制定规范,可以参考 OpenTelemetry 语义约定,例如 service.name 和 deployment.environment.name。这是现成的通用标准,模型在训练中也接触过大量此类数据,理解起来最自然。
除了名字,还有两点容易被忽视:
- 时间。不同系统的时区不一致,是排查中很隐蔽的问题。如果日志使用本地时间、指标使用 UTC,AI 对齐时间线时很容易错开 8 个小时。应统一使用带时区的时间格式。
- 单位。延迟是毫秒还是秒,内存是字节还是 MB。在指标名中加上单位后缀(例如
_seconds、_bytes),可以避免很多误判。
用知识库兜底历史命名
老系统的命名很难一次改完。无法修改时,可以在知识库(Knowledge)中写清映射关系:order-api、order_service 和“订单中心”是同一个服务,日志在哪个 logstore,按哪个字段过滤。
这是退而求其次的办法,但很有效。AI 读取一段映射说明的成本很低,比让它自行推测可靠得多。
建设全局服务目录
更进一步,是建设全局的服务目录(Service Catalog),记录有哪些服务,以及各服务的职责、负责人、依赖关系、部署位置和数据入口。服务目录是 AI 理解整个系统的骨架。
很多公司没有结构化的 CMDB,或者 CMDB 中的数据早已过时。这种情况下,可以先把服务目录写成一份 Markdown 提供给 AI,也能解决大部分问题。不必为了追求完美的结构化而推迟这项工作。一份持续维护的 Markdown,远胜于一个无人维护的 CMDB。
从任意一个点都能找到相关数据
告警要带上排查线索
告警是 AI 排查的起点。如果告警只有一句“XX 服务错误率超过 5%”,AI 只能从零开始寻找线索。
更好的做法是在告警规则上附带三类信息:
- 标准操作流程(SOP):这类告警通常如何排查,先看什么,后看什么。
- 临时查询(ad-hoc query):排查时常用的几条查询语句,例如按接口拆分错误率、查询对应时段的错误日志。
- 仪表盘链接:该服务的核心大盘。
这些信息对值班工程师有用,对 AI 更有用。它们把一条告警变成了带有线索的排查入口,AI 可以直接沿着这些线索排查,无需自行摸索。
日志要能关联链路和指标
日志方面有几条具体建议:
- 打印 traceid。有了 traceid,AI 可以从一条错误日志跳转到完整的调用链,确认问题发生在哪一跳。
- 使用 JSON 格式。结构化日志可以直接按字段过滤和聚合,无需编写正则表达式解析。
- 使用 canonical log line。这是 Stripe 推广的做法:每个请求结束时输出一行宽日志,记录这次请求的关键信息,例如接口、用户、耗时、状态码、下游调用次数和数据库耗时。排查时查看这一行即可掌握请求全貌,无需从几十行零散日志中拼凑。
- 日志字段与指标标签保持一致。日志中的
service、endpoint、region与指标标签使用相同的 key 和 value。AI 在指标中发现某个接口异常后,可以直接用同样的条件查询日志,无需做任何转换。
变更事件同理。发布、配置变更等记录要带上相同的服务标签。AI 发现某个服务出现问题时,可以立即关联到该服务最近的变更。
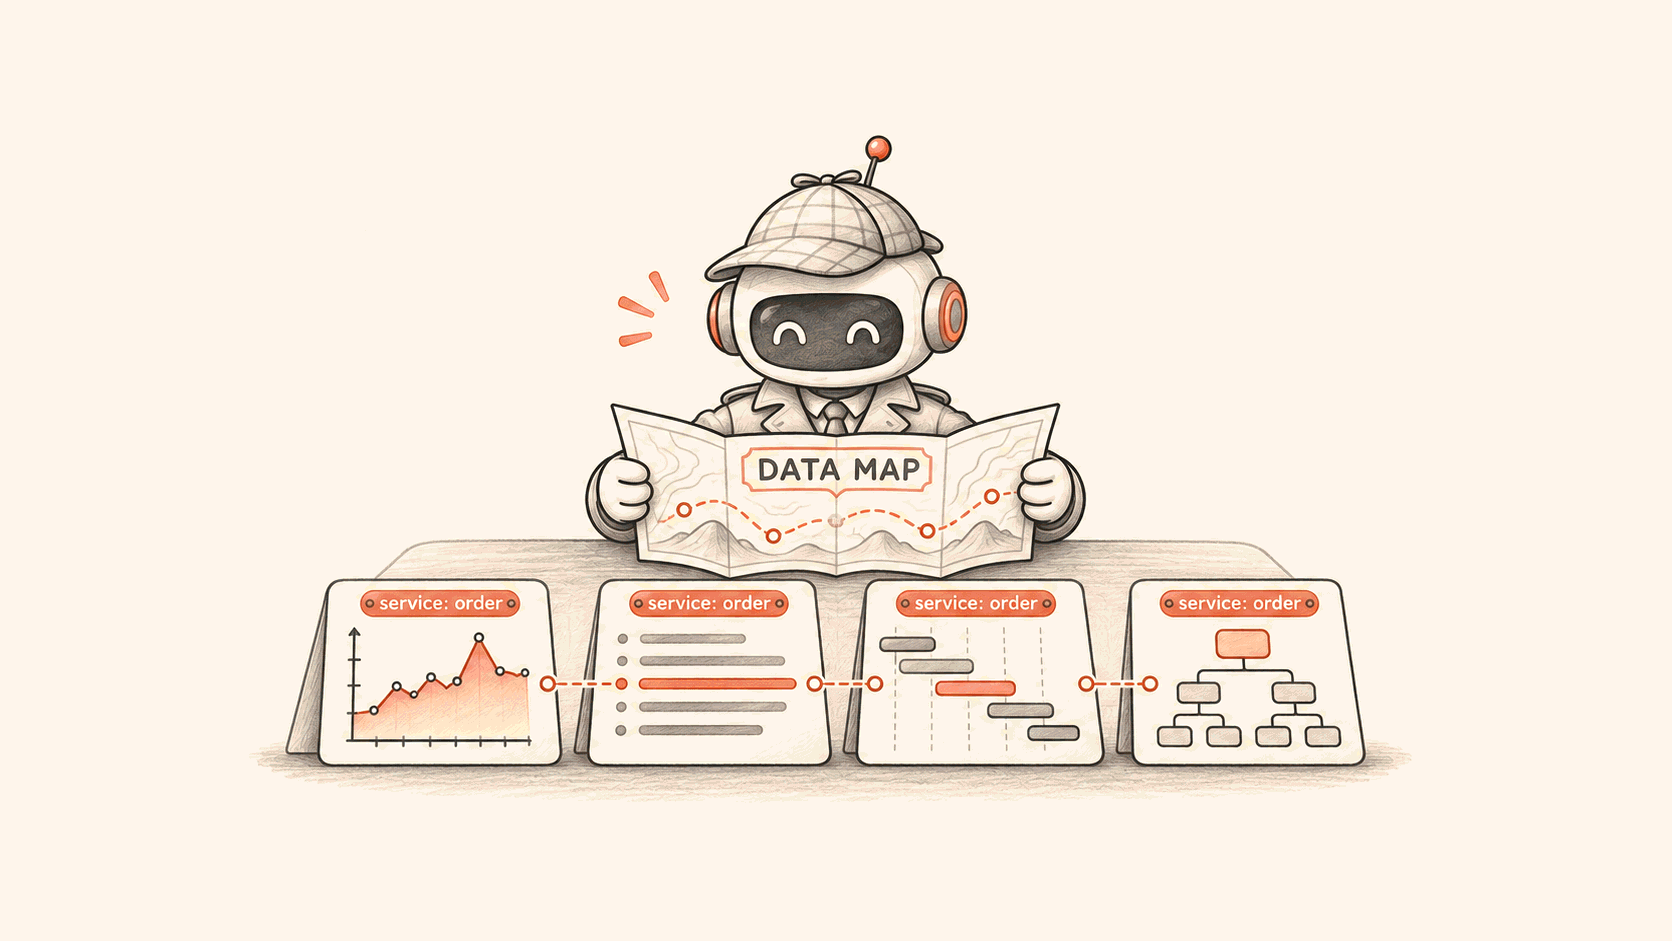
数据串联的目标是:从任意一个点出发,AI 都能沿着统一的标识找到其他相关数据。告警关联大盘和查询,指标关联日志,日志关联链路,服务关联变更。
用历史故障检验数据组织
检验数据组织得好不好,可以让 AI 复盘历史故障,然后观察它的排查过程。
不要只看最终结论是否正确,还要看 AI 中间调用了哪些工具、查询了哪些数据:
- 反复查询同一个数据源并更换不同的过滤条件,说明数据地图有缺失。
- 查到了指标却找不到对应的日志,说明字段没有对齐。
- 在大量原始数据中来回翻找,说明缺少特征提取工具。
AI 卡住的地方,就是数据的缺口。这比任何检查清单都准确。
这些规范对人同样有用
这些规范没有一条是专门为 AI 设计的。统一命名、结构化日志、traceid、服务目录、告警附带运行手册,都是可观测性领域推行多年的最佳实践。过去有工程师的经验兜底,做得不好也能应付;现在由 AI 排查,这些欠下的技术债就暴露出来了。
为 AI 所做的数据治理,工程师同样受益:新人上手更快,值班更轻松,故障复盘更容易。
下一次 SRE Agent 查得不准时,除了检查数据是否给全,还可以再问一句:这些数据,一位刚入职的工程师能看懂吗?
了解并试用 Flashduty AI SRE。