
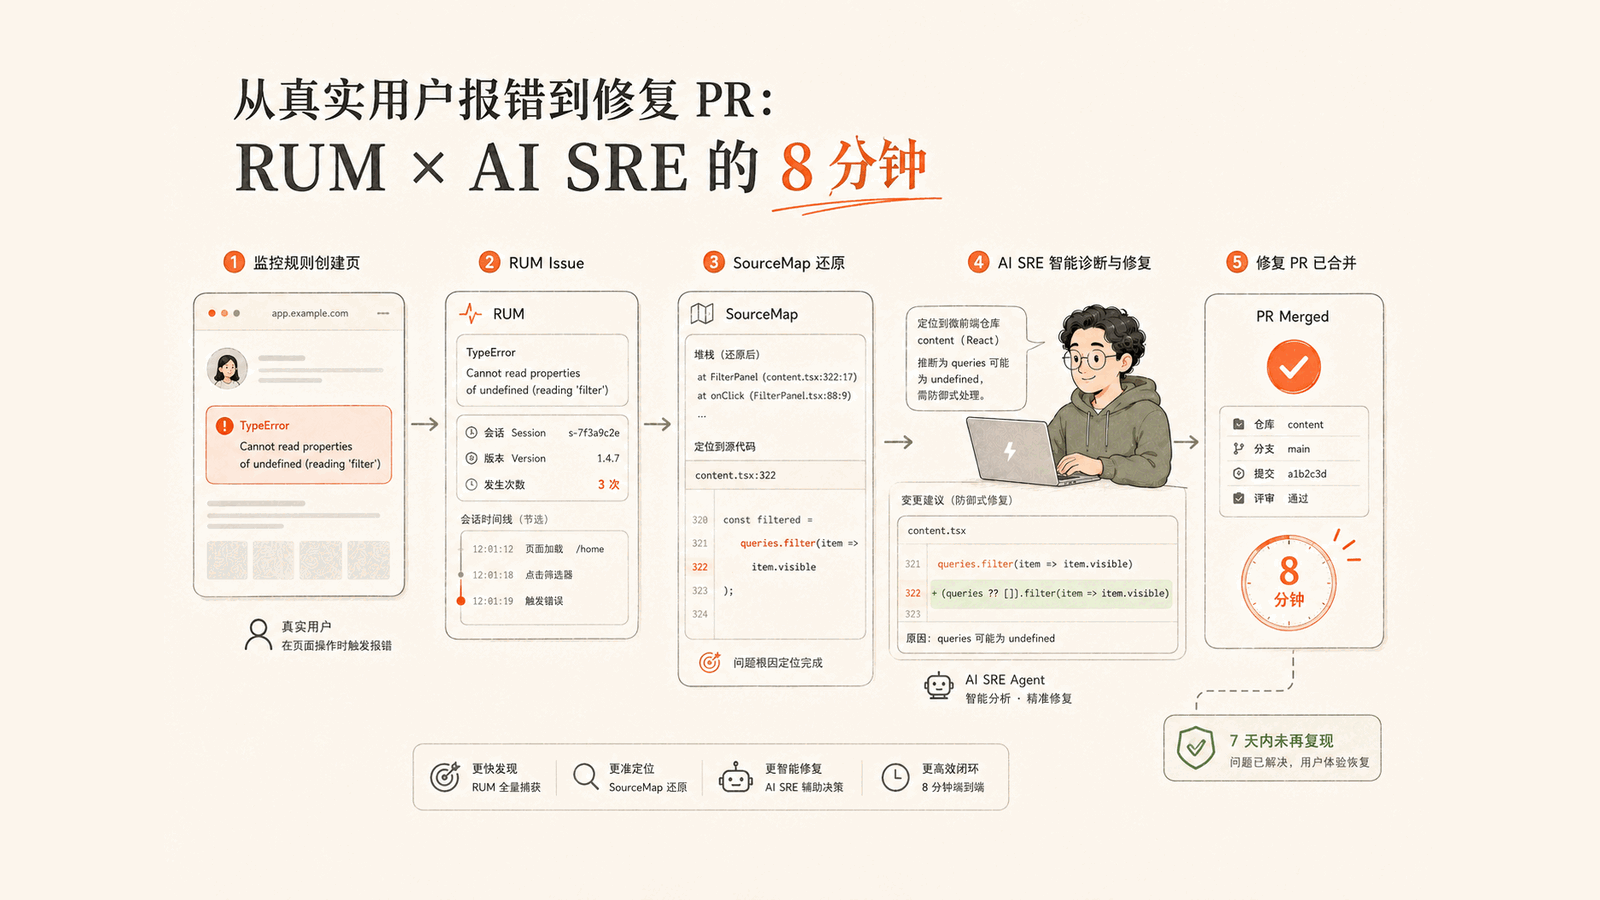
7 月 15 日,我们自己控制台的监控规则创建页向一名用户连续抛出 3 次相同的异常。最后一次报错后 8 分钟,AI SRE 编写的一行修复合并到了主分支。本文介绍 RUM 如何保留现场、AI SRE 如何定位正确的仓库,以及另一个 AI SRE 正确地决定保留代码原状的案例。
异常如下:
TypeError: Cannot read properties of undefined (reading 'filter')三次报错发生在半分钟内。用户很少为这类局部问题提交工单,研发人员也无法根据“页面好像不太对”这样的描述复现问题。不过,页面中的 RUM(Real User Monitoring,真实用户监控)SDK 已经记录了现场。RUM 记录真实用户遇到的问题,而不是测试环境中页面能否打开。RUM 将这次错误与页面、版本、设备和访问过程关联,并将相似的错误聚合为一个 Issue。
该 Issue 显示,错误集中在监控规则创建页。该样例影响 1 个会话,出现 3 次,来自同一个正式版本。会话时间线还保留了报错前的页面访问记录。
SourceMap 将错误还原到源码
前端代码上线前需要打包和压缩。没有 SourceMap 时,浏览器堆栈只能指向类似 index-q2_vQxih.js:134:36624 的位置。研发人员需要根据这个位置,再花时间查找对应的源文件和函数。
SourceMap 记录了压缩代码和源文件之间的对应关系。上传与线上版本匹配的 SourceMap 后,RUM 即可把堆栈还原成源文件、函数和行号。
在该 Issue 中,RUM 将最上层的堆栈还原到:
src/Packages/monit/pages/rule/add/content.tsx:322:16调用方的位置还原到 content.tsx:287:12。展开堆栈后,出错的代码行直接显示如下:
if (queries.filter((i) => i.expr).length === 0) return false;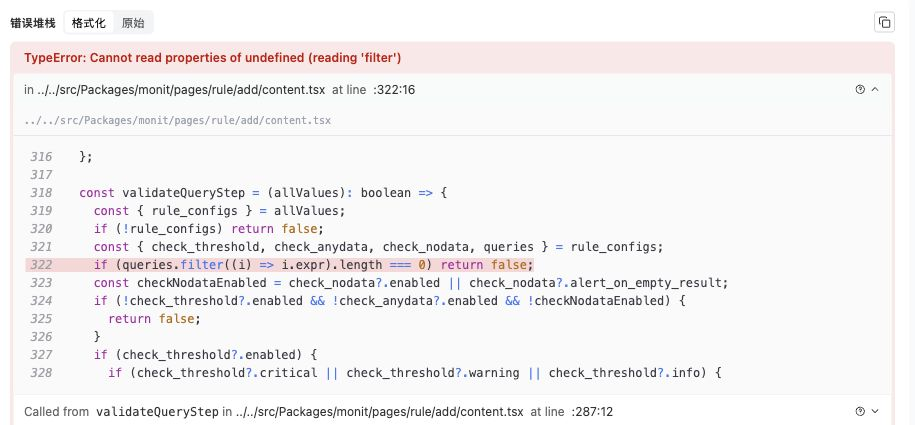
(截图已裁去 Issue、应用、用户和会话标识)
此时,研发人员可以确认:validateQueryStep 在校验告警查询条件时,对 queries 调用了 .filter()。
但出错原因仍不清楚:queries 为什么是 undefined?该文件属于哪个仓库?应该修改前端基座,还是负责监控的微前端?
自动化将现场交给 AI SRE
在我们的配置中,RUM Issue 进入 Flashduty 的故障响应流程,随后触发一条自动化。自动化有三种启动方式,本次使用的是故障触发。
这条自动化规定触发条件,注入 RUM 上下文,指定排查步骤和工具,并限定 AI SRE 可执行操作的范围。
因此,AI SRE 获得的是一整组证据,而不只是一行报错:错误类型、出现次数、页面 URL、发布版本、会话分布和 SourceMap 堆栈。
排查过程中有一个实际难点:应用映射最初指向前端基座 foundation-app,但出错的页面是 /monit/rule/add。AI SRE 结合路由和还原后的源码路径,继续追踪到负责监控的微前端,并找到了这段代码所在的仓库,而没有在基座仓库中盲目搜索。
这一步对大型前端项目很重要。一个基座承载多个微前端时,仅知道报错的应用并不够。只有结合页面路由、SourceMap 路径和仓库映射,才能定位需要修改的代码。
根因在表单初始化
SourceMap 还原出的上下文大致如下:
const { rule_configs } = allValues;
if (!rule_configs) return false;

const {
  check_threshold,
  check_anydata,
  check_nodata,
  queries,
} = rule_configs;

if (queries.filter((i) => i.expr).length === 0) return false;
代码检查了 rule_configs 是否存在,却假定其中的 queries 一定是数组。表单首次校验时,rule_configs 已经存在,但查询条件尚未完成初始化,此时 queries 可能是 undefined。
这也解释了同一次访问中连续报错的原因:每次校验都会执行到同一行代码。
修复无须修改接口,也无须重写表单。对于“尚未配置查询条件”的状态,校验返回不通过即可,而不应抛出异常:
- if (queries.filter((i) => i.expr).length === 0) return false;
+ if ((queries ?? []).filter((i) => i.expr).length === 0) return false;改动只有一行。queries 存在时,逻辑保持不变;尚未初始化时,空数组使校验返回 false,不再抛出异常。
最后一次报错后 8 分钟修复合并到主分支
该 Issue 保留了清晰的时间线:
- RUM 记录到最后一条错误样例。
- 约 4 分钟后,针对
queries.filter(...)的修复提交完成。 - 约 8 分钟后,修复 PR 合并到主分支。
PR 描述中记录了线上错误、服务与版本、SourceMap 行号、根因和一行代码改动,并标注由 Agent 生成。
自动修复并不代表 AI 可以绕过研发流程直接上线。AI SRE 可以读取证据、修改代码和创建 PR,是否合并以及何时发布仍由团队决定。本次修复经过评审后合并。最后一条错误样例出现在合并之前,此后 7 天内未再出现同类样例。
一周后,我们将同一个 Issue 再次交给 AI SRE 回放。AI SRE 重新读取 RUM 证据,沿路由和 SourceMap 找到监控微前端,确认主分支已包含这处保护,因此没有重复修改。对 SRE 来说,避免重复修改和避免漏修一样重要。
部分 Issue 无须修改代码
另一个 Issue fetchError · Network request failed 也触发了同一条自动化。该 Issue 只影响 1 个移动端会话,只出现 1 次,没有同类错误聚集,页面和堆栈证据也不充分。
AI SRE 没有为了完成任务而强行修改代码,而是记录了当前判断和缺失的证据:先观察;如果错误反复出现或影响更多会话,再重新调查。
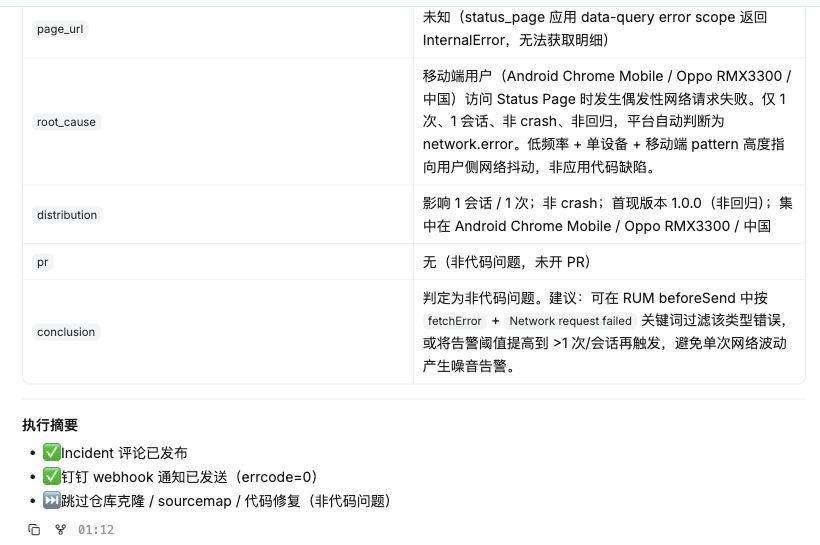
对比这两个 Issue,可以看出这条自动化的作用。证据指向代码缺陷且改动范围明确时,流程可以推进到 PR;证据不足、更接近偶发的环境问题时,流程应当停止,而不是提交一份缺乏把握的代码改动。
各组件的分工
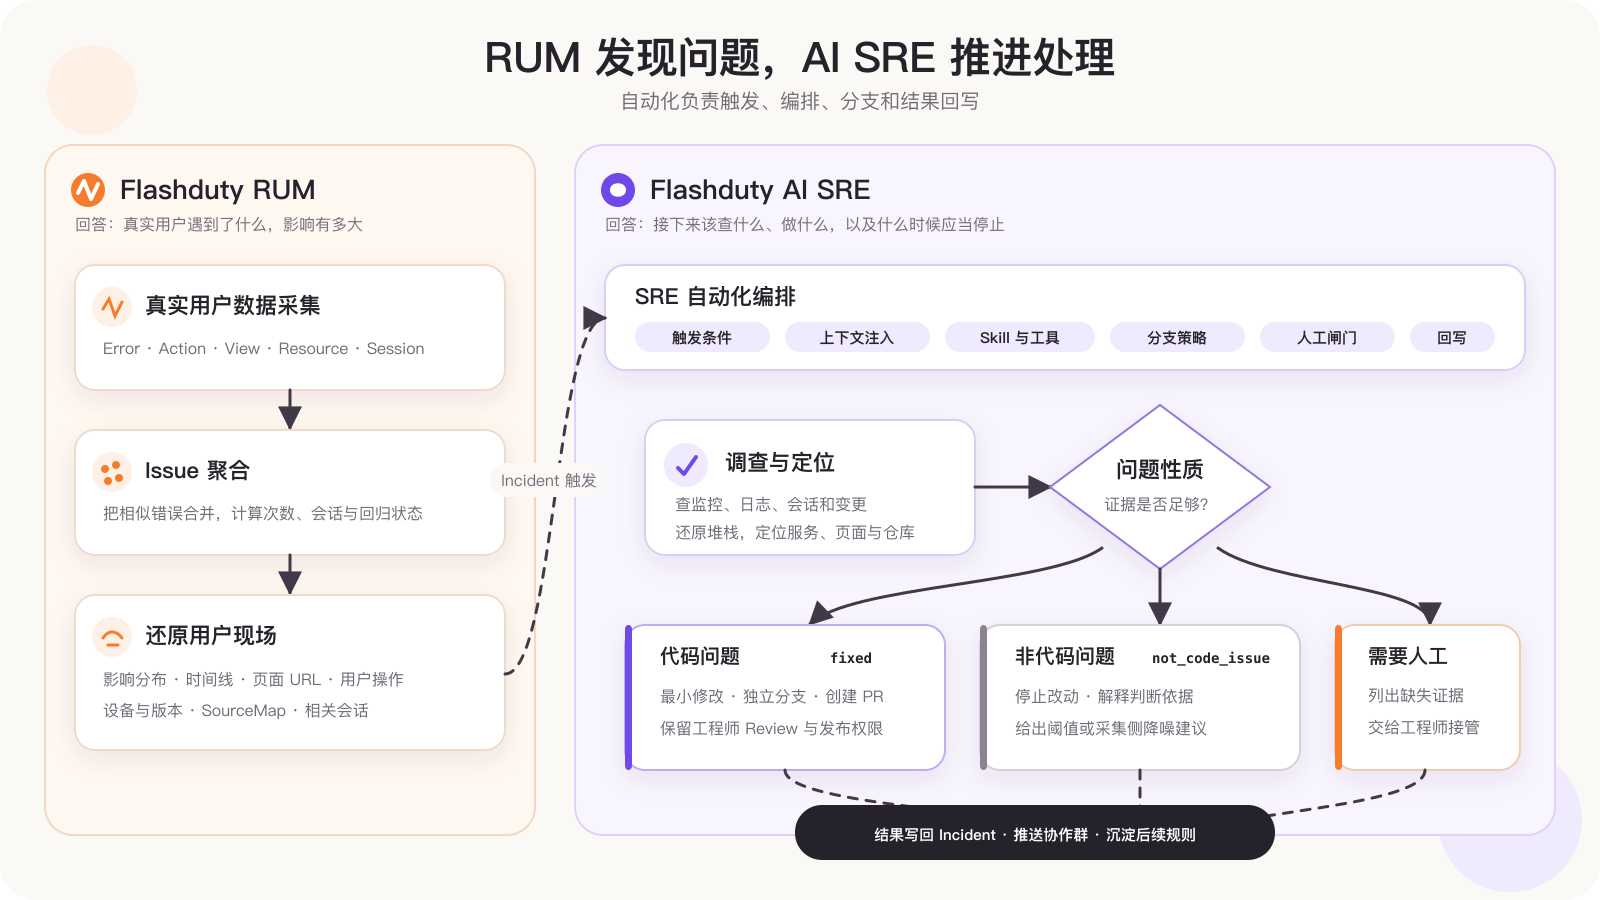
RUM 提供真实用户的现场。自动化决定哪些 Issue 触发运行、注入哪些上下文、可使用哪些工具、能否创建 PR,以及哪些步骤需要人工确认。AI SRE 在这些限制内调查和修改。工程师保留评审、合并和发布的权限。发布后,RUM 继续观察新版本中是否仍有同类错误。
在自有应用上部署
首先,选择一个重要的前端应用接入 RUM。采集错误时附带版本、环境、页面和会话信息,每次发布都上传匹配的 SourceMap。当一个 Issue 能够回答“什么错误、哪个页面、哪个版本、哪一行源码”时,RUM 已经开始缩短排查时间。
然后,建立应用、页面和代码仓库之间的对应关系,并为 AI SRE 开放受控的权限:读取 RUM 证据、读取代码和创建 PR。权限的签发方式和范围限定,详见GitHub / GitLab App:AI SRE 自己读提交、翻 CI 日志、开 PR。首次回放时,建议选择一个历史上反复出现、SourceMap 已指向业务代码的 Issue。
有价值的回放不一定产出 PR,也可能得出证据不足、问题已修复或应继续观察的结论。需要保证的是:每个判断都有证据支持,代码修改有明确的边界,合并和发布始终由工程师掌握。