
自动化让 AI SRE 无须人工发起即可开始工作,凌晨三点也同样如此。如果只想尝试一项功能,建议为一个协作空间的 Critical 故障开启“故障自动分析”。夜间告警触发后,值班人员打开故障之前,Agent 已经把初步结论写入故障评论。
本文介绍我们使用自动化的五种方式,并附上每种方式的提示词,以及结果送达相关人员的途径。
工作原理
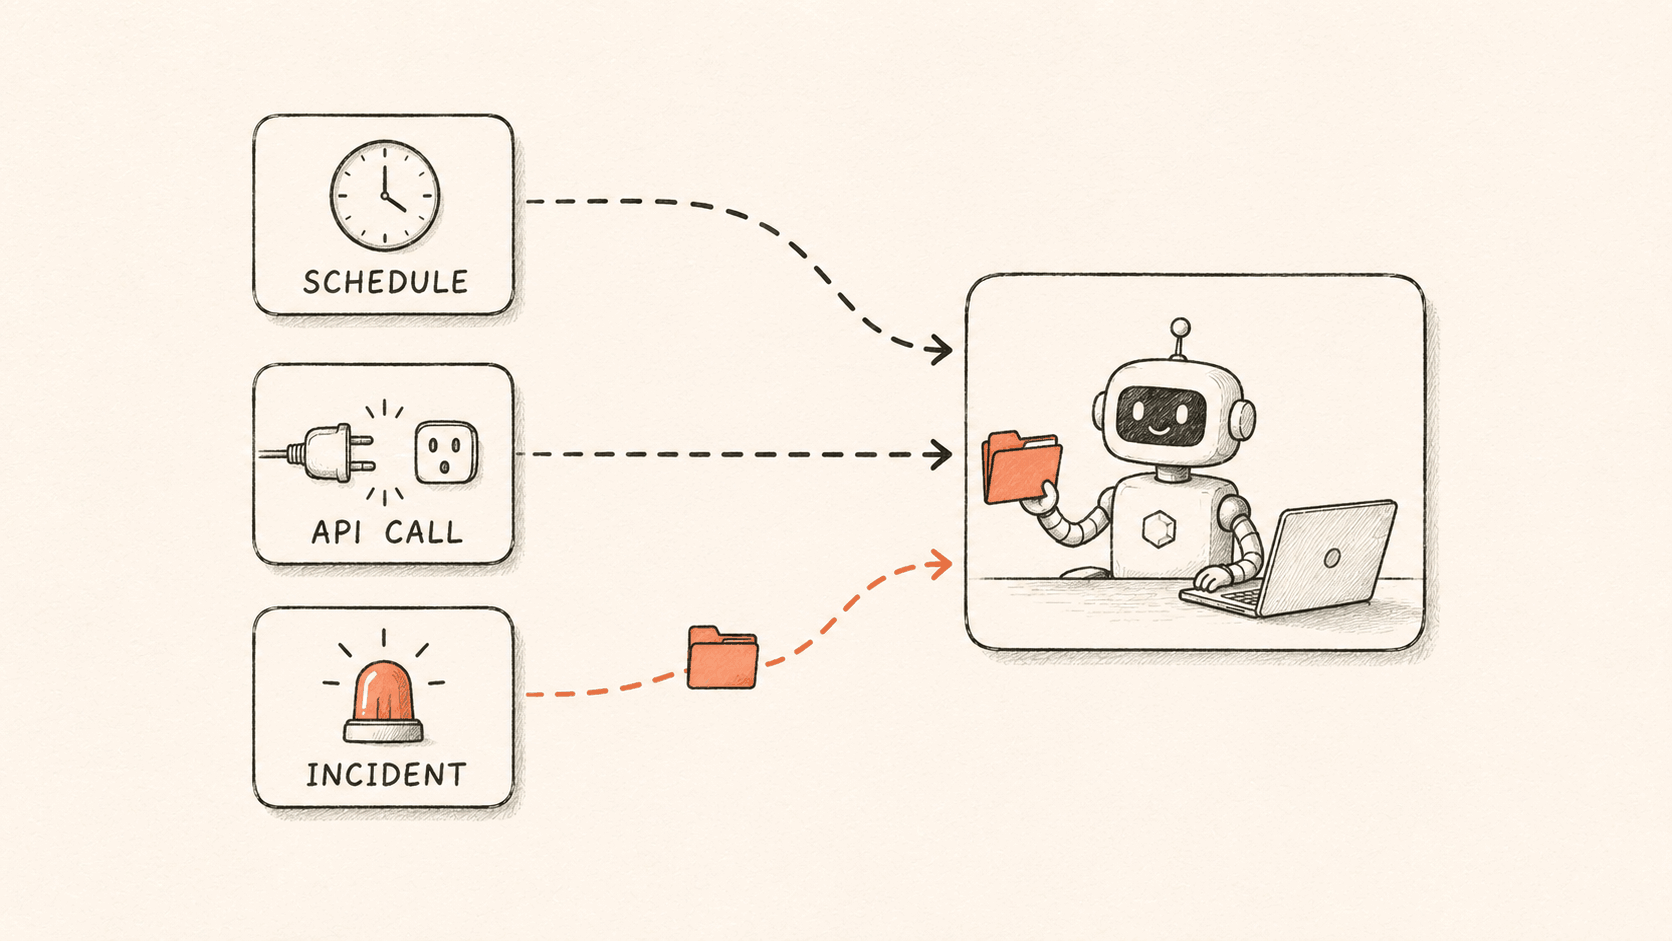
一条自动化是一条规则,由一段任务提示词和至少一种启动方式组成。启动方式有三种:
- 按周期执行:每小时、每天、每周,或者使用自定义的 cron 表达式。
- 通过 API 调用:系统提供一个地址和一个 Token,调用方可以从任何位置发送 POST 请求。
- On-call 故障触发:选择要监听的协作空间和严重程度,匹配的故障会启动一次运行。
一条规则可以同时配置三种启动方式。三种方式共用同一段提示词。
每次运行会在后台创建一个会话。该会话不出现在会话列表中,Agent 使用的工具与日常对话相同。运行结束后,打开运行记录即可查看 Agent 执行的每条命令、每次工具调用和全部产出。
前三种场景是产品自带的模板,后两种是示例,复制后按需修改即可使用。各场景的结果去向如下:
| 场景 | 结果去向 |
|---|---|
| 1 · 每周洞察 | 留在运行会话里;由 Agent 发布后可长期保存为产物 |
| 2 · 告警治理 | 同上 |
| 3 · 故障自动分析 | 作为评论写回故障,借助故障的通知送达值班人员 |
| 4 · 发布后巡检 | 调用立即返回 session_url,发到发布群或附在流水线中 |
| 5 · 变更风险预检 | 调用立即返回 session_url,附回变更单 |
1. 每周洞察
许多团队每周一都要花两个小时整理上周的情况:发生了哪些故障、收到多少告警、由谁值班、做了哪些变更。每周查询的都是同一批数据。
这个场景使用按周期执行,每周运行一次。建议设置在周一上午,团队成员上班时报告已经生成。模板名称为“每周洞察”:
生成一份每周洞察报告。分析过去一周的事故、告警、响应情况、通知负载和相关变更。重点说明
本周发生了什么、哪些信号值得关注、哪些改进动作最有价值。不要修改任何 Flashduty 业务状态。
提示词的最后一句必须保留。Agent 有权修改 Flashduty 中的配置,因此只生成报告的规则应明确禁止修改。
报告保存在本次运行的会话中,打开规则的运行记录即可查看。如需长期保存,可以在提示词中要求 Agent 将报告发布为产物。
2. 告警治理清单
多数团队都知道自己有一批无效告警,但很少有团队拥有一份排好序的清单,写明哪些告警最需要治理、治理后能减少多少通知。
这个场景使用按周期执行,每月运行一次即可,因为相关数据不会每天变化。模板名称为“告警治理”:
/alert-governance
生成近 30 天该范围的告警治理报告。重点说明最值得治理的告警,以及预期的通知量降幅。
仅生成报告——不要修改任何 Flashduty 配置。
第一行调用了一个技能(skill)。自动化可以像对话一样调用技能。治理方法写在技能中,提示词只需说明治理范围。
结果的去向与每周洞察相同:保存在会话中,或者由 Agent 发布为产物。
该规则只生成报告,不修改配置。是否把报告转化为配置变更,仍由人决定。这是有意的设计。
3. 值班人员介入前的首轮调查
凌晨触发一条 Critical 故障后,值班人员通常要过一段时间才能看到,随后还要花十五分钟查找资料:关联告警、时间线和最近的发布记录。这一轮查找可以交给 Agent 完成。
选择“On-call 故障触发”,指定协作空间,勾选需要关注的严重程度。新故障匹配后,运行立即开始。模板名称为“故障自动分析”:
请分析本次触发该自动化的故障。使用 Flashduty CLI 获取故障详情、关联告警和时间线,再结合
最近变更、告警上下文和已有处理记录判断可能原因。证据不足时,请说明不确定性和建议下一步
排查方向。
如果形成了有价值的调查结论,请给故障添加一条总结性 comment。尽量写一次完整的调查总结,
不要频繁分多次评论。
调查结论以评论的形式写回故障。新评论会按故障的分派策略通知值班人员。值班人员在原本就要查看的位置看到结论,无须知道背后运行过一条自动化。
“证据不足时说明不确定性”这一句是我们特意添加的。措辞确定的猜测,危害大于如实说明“证据不足,下一步应检查这两处”。
这种触发方式还能减少 Agent 的无效步骤。定时运行开始时只有提示词,API 运行额外带有调用方传入的内容。故障触发的运行在第一步之前,上下文中就已经包含故障本身的信息:故障 ID、协作空间和严重程度。提示词还要求 Agent 不要在故障列表中查找目标。这省去了多轮工具调用,而每一轮都可能选错目标。相比之下,9 点运行的定时任务只能在 9 点报告前一晚的故障。
需要注意以下细节:
- 只有新建的故障会启动运行,认领、解决和重新打开均不会触发。
- 筛选条件目前只支持协作空间和严重程度,尚不支持标签。
- 同一个故障只启动一次运行。即使内部消息重复投递,也不会产生三个并行的调查。
4. 发布后巡检
发布新版本后,工程师通常要观察看板十分钟,确认没有引入问题。大多数情况下,指标没有变化。
这个场景使用 API 触发。添加这种启动方式并保存规则后,系统会提供一个地址和一个 Token。Token 只显示一次,离开页面后无法再次查看,只能重置。重置会生成新 Token,旧 Token 立即失效。
在流水线的最后一步调用该地址:
curl -X POST 'https://<触发地址>' \
  -H 'Authorization: Bearer <token>' \
  -H 'Content-Type: application/json' \
  -d '{"text":"payment-service v2.14.0 已发布到生产。改动:结算回调的重试策略,t_order.created_at 新增索引。"}'
text 中的内容会追加到提示词末尾,只对本次运行生效。这是向提示词传入外部信息的唯一途径。定时运行没有调用方,故障触发的运行从故障本身获取上下文。
可以使用以下提示词作为起点:
本消息末尾是一次刚完成的发版信息。针对其中提到的服务,对比发版后 30 分钟与发版前同长度
窗口的告警量、故障数和报错模式。只报告发生了变化的部分,并判断是否可能与本次发版有关。
如果没有变化,用一句话说明。不要修改任何 Flashduty 状态。
调用会立即返回,无须等待 Agent 运行结束:
{
  "data": {
    "type": "routine_fire",
    "session_id": "<session-id>",
    "session_url": "https://<console>/ai-sre/chat?session_id=<session-id>"
  }
}
可以把 session_url 发到发布群,或者附在流水线记录中。需要查看细节的人员打开该链接即可。
每条规则每分钟最多接受一次 API 调用。同一条规则上的两个 API 触发共用这个额度。API 触发面向事件设计,不适合用于轮询。
5. 变更前风险预检
变更审批往往是唯一有人会问“这类变更以前是否引发过故障”的环节,但通常没有人有时间查证。
这个场景使用 API 触发。变更单进入“已批准”状态时,由变更系统调用该地址,并把变更内容放入 text。
可以使用以下提示词作为起点:
本消息末尾描述了一次待执行的变更。查找近 90 天内涉及相同服务、或同类改动的故障,逐条说明
当时坏在哪里、最后怎么解决的。然后列出这次变更落地前后具体值得盯的检查项。如果没有找到
相关历史,请直接说明,不要泛泛而谈。不要修改任何 Flashduty 状态。
与发布后巡检相同,调用会返回一个 session_url。将该链接附回变更单后,审批人无须离开自己的系统,就能查看相关历史记录。
结果的送达方式
自动化没有独立的通知渠道。结果通过以下两种途径送达相关人员。
故障触发的运行借助故障本身的通知。结论写成故障评论,按故障的分派策略通知值班人员,无须额外配置。
其他运行由 Agent 主动发送。定时运行和 API 触发的运行默认不通知任何人,结果保存在会话中。如需推送到群聊,可以在提示词中写明 IM 机器人的 webhook 地址。飞书、钉钉和企业微信的自定义机器人都只需要一个 URL。Agent 运行结束后,会自动把摘要 POST 到该地址:
任务完成后,把结论压缩成 5 行以内的中文摘要,用 curl 以 JSON POST 到这个机器人地址:
https://oapi.dingtalk.com/robot/send?access_token=<你的 token>。
发送失败就在结果里说明,不要重试超过两次。
我们自己也采用这种方式。下图是每日文档审计运行结束后,Agent 发送到我们钉钉群的消息:
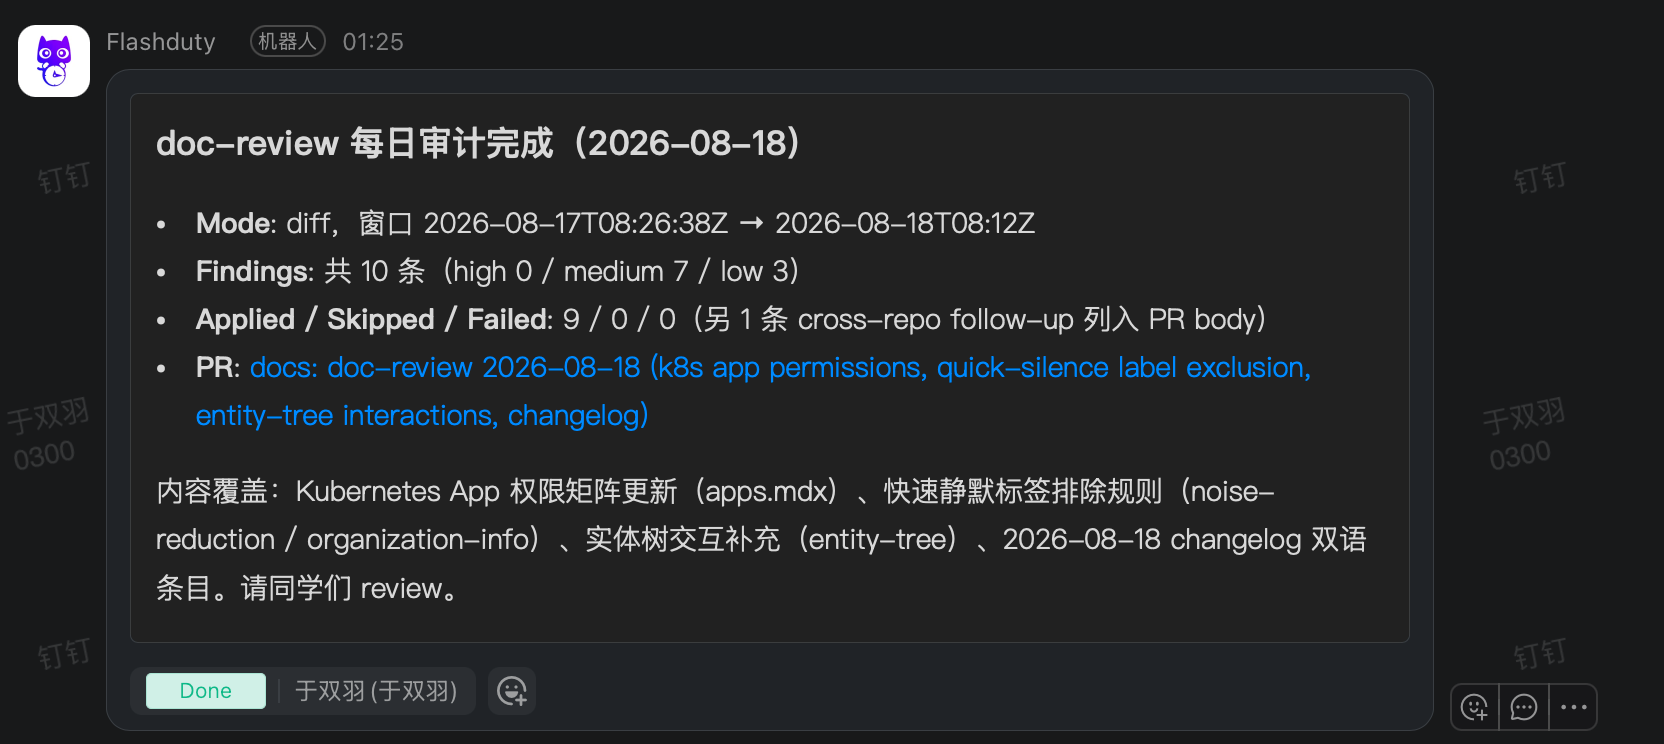
一条消息即可说明审计范围、发现的问题数、修复的问题数和 PR 地址,需要细节时打开链接即可。请注意:能够查看这条规则的人员都能看到 webhook 地址,获得地址的人都能向该群发送消息。因此,只应允许可信人员编辑这类规则,并尽量开启机器人自带的安全设置。
平台的默认行为
平台为自动化预设了以下行为。
- 启动时间存在偏移。设置为 9 点的任务可能在 9 点 03 分才开始,这是有意的设计。如果平台上所有定时任务都在 9:00:00 同时启动,所有任务都会变慢。请把该设置理解为“每天早上”,而不是精确到秒的计时。
- 上一次未结束时跳过本次。到达启动时间时,如果上一轮仍在运行,本次运行直接跳过,不进入排队。否则,耗时较长的任务会不断积压。
- 延迟过久的运行会被丢弃。一次运行延迟超过一天时,系统将其丢弃。故障恢复后集中产生四十份报告,对任何人都没有价值。
- 重启不丢失,也不重复。服务重启时,正在进行的运行不会丢失,也只记录一次。
- 其他团队的故障按本规则的权限处理。故障所属团队与规则所属团队不同时,运行照常执行,使用的是该规则的权限。Agent 开始时会被告知:该故障属于其他团队,对方团队的知识未加载。Agent 不会越权读取,也不会静默跳过。
开始使用
入口位于控制台的“AI SRE → 自动化”,自带模板位于创建页面。从真实用户报错到修复 PR 的 8 分钟完整演示了一次故障触发的运行。
Agent 操作 Flashduty 的方式,详见从 MCP 到 CLI。完整的字段说明(包括 cron 写法和各触发方式的请求格式)详见文档。AI SRE 目前全量公测,公测期间免费。
自带的提示词反映了我们自己的习惯:周一查看周报,每月治理一次告警,先写评论再通知值班人员。请根据团队的值班方式修改。