
AI Agent 排查故障时,通常需要先读数据:查一段时间的指标,看看错误日志,再到数据库里确认某个服务的状态。查询语句可以由模型生成,但执行查询的是生产环境里的真实数据源。
这就带来一个容易被忽略的问题:一条写得不合适的查询,即使没有修改任何数据,也可能扫描过大的时间范围、返回海量结果,给存储和查询链路带来压力。结果送进大模型后,还可能占满上下文窗口,让后续分析无处可放。
我们在做 Flashduty AI SRE 时,需要让 Agent 查询不同网络分区里的数据源。这里分享几个实践中的考虑,也给准备建设类似能力的团队一些参考。
先打通网络,再约束查询
企业的数据源往往分散在不同的虚拟私有云(VPC)、机房或内网分区。中心服务未必能直接访问每一套 Prometheus、日志系统或数据库,也不应该为了方便查询,把这些数据源都暴露到公网。
我们的做法是在需要访问数据源的网络分区部署 MonitEdge,由中心端将查询请求转给对应的 Edge,再由 Edge 访问数据源并回传结果。Agent 面向数据源提供的 query tool 发起查询,不需要自行处理每个网络分区的连接问题。目前支持十几种数据源,多数提供了查询工具,供 Agent 在根因分析过程中获取数据。
分布式数据源控制面介绍了这种部署方式的更多背景。AI SRE 安全访问 Kubernetes 集群介绍了集群访问的另一种场景。
网络打通只是第一步。Agent 生成的 QL 可能有语法错误,也可能语法正确、执行代价却很高。因此,查询工具需要在执行前、执行中和返回结果时分别设置边界。
限制能做什么,也限制能查多少
对于 SQL 数据源,我们会检查语句,只允许符合策略的只读查询,拦截 INSERT、UPDATE、DELETE 等写操作,以及多语句等不符合要求的请求。但不要把 SQL 校验当成唯一的安全边界:不同数据库的语法和函数有差异,仅靠关键词或语法分析很难证明一条语句绝对没有副作用。数据源凭据本身仍应使用只读账号,并只授予排障所需的最小权限。
只读也不意味着便宜。例如,一条 SELECT 可能扫完整张大表;日志查询没有限定时间范围,可能读出数小时乃至更久的数据;PromQL 选择了过多的时间序列,也会消耗大量计算和内存。返回结果加了 LIMIT,并不一定能限制数据源为了得到这些结果而扫描的数据量。
所以,除了限制返回行数,还需要结合数据源类型控制查询时间范围、执行超时和并发数,并尽量让 Agent 先从故障发生前后的小时间窗口、具体服务或实例入手。数据不足时再逐步扩大范围,比一开始就拉取所有数据更可控。对于数据库,索引、资源配额等数据源侧的控制也不能省略。
在数据进入内存之前就设上限
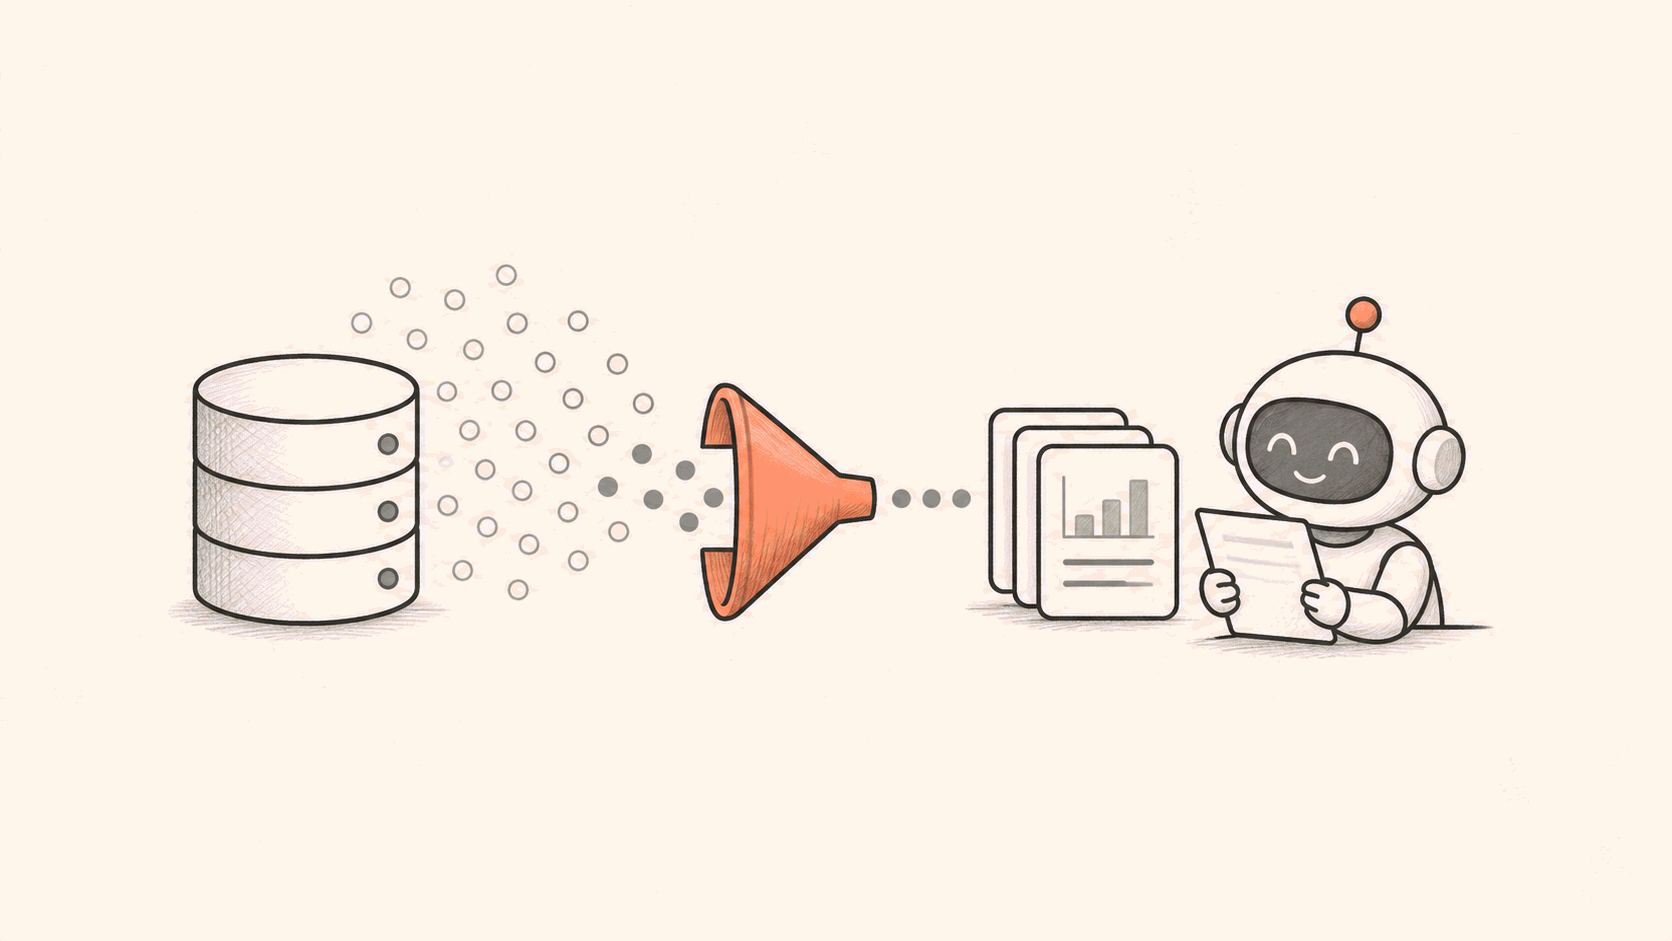
结果大小至少会影响三处:Edge 从数据源读取响应时的内存,中心 WebAPI 接收和处理结果时的内存,以及 Agent 把结果放进模型上下文时的 token 消耗。
因此,不能等整个响应读完、序列化完,再检查它是否太大。对于 HTTP 数据源,可以在读取响应流时累计字节数,超过预算就停止读取并返回明确的超限错误;对于数据库结果,则应在遍历行和编码结果时控制行数、字段大小和总字节数。中心端也需要有自己的接收上限,避免某个环节失守后,大结果继续向上传播。具体阈值需要结合数据源、部署规格和调用场景调整。
给 Agent 的结果预算还可以更紧。模型通常不需要几万行原始日志,它可能只需要错误分布、几个有代表性的样本,以及异常发生的时间段。能在数据源侧聚合的尽量先聚合,再让 Agent 根据摘要决定是否深入查询。
如果结果超限,最好明确告诉 Agent 是哪类限制触发了,而不是悄悄截断并当作完整结果返回。这样它可以缩小时间范围、增加过滤条件或改用聚合查询;如果确实返回了部分结果,也应标明不完整,避免模型基于缺失的数据下结论。超时和取消同样需要尽可能传递到数据源,避免上层已经放弃等待,底层查询仍在持续消耗资源。
护栏也要方便排障
限制过严会让 Agent 查不到需要的证据,过松又会影响生产系统。实际运行时,可以观察查询耗时、超时和超限次数、并发拒绝次数,以及返回行数和字节数,再根据数据源特性调整预算。记录这些指标时也要注意,查询表达式和结果可能包含敏感信息,不宜直接作为指标标签或随意写入日志。
AI 帮 SRE 排查问题,前提是它能拿到可信的现场数据。让查询可达只是起点,权限、查询成本和结果预算同样需要纳入设计,才能让 Agent 在故障期间安全地获取证据。
Flashduty AI SRE 帮助团队处理告警,并结合数据源中的指标、日志等信息辅助定位问题。