
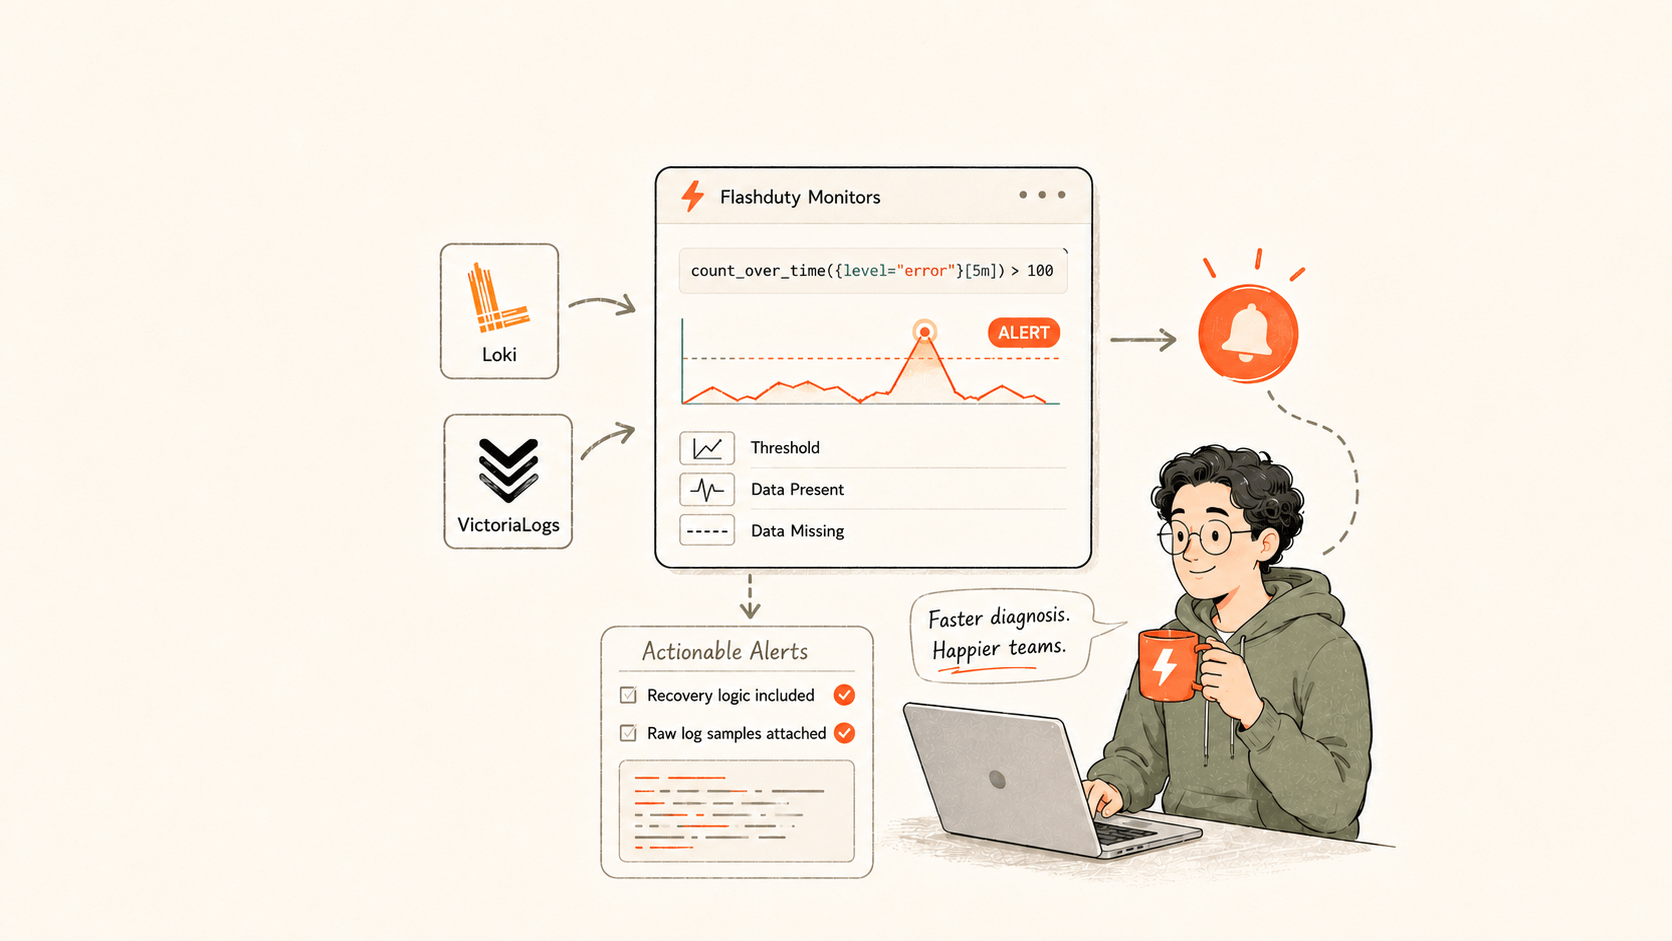
Flashduty Monitors 新增了两个数据源:Grafana Loki 和 VictoriaLogs。现有的 LogQL 或 VictoriaLogs 查询可以直接用于告警,无须学习新语法。告警、恢复、通知和值班由 Flashduty 负责。告警消息中还可以附带触发告警的日志原文。
已能检索日志的团队,难点通常在下一步:将日志转化为告警。需要通知谁?通知中包含哪条日志?何时判定为恢复?下文依次介绍告警模式和恢复方式,最后给出三条可直接复用的规则。
原生查询语法
Monitors 直接支持 LogQL 和 VictoriaLogs 的查询语句。
Loki LogQL 示例:
count_over_time({job="mysql"} |= "error" [5m])VictoriaLogs 示例:
_time:15m and level:ERROR | stats by (level) count(*) total | filter total:>10三种告警模式
| 模式 | 适用场景 | 典型案例 |
|---|---|---|
| 阈值判定 | 需要多级告警(Info/Warning/Critical) | 5 分钟内错误日志超过 50 条触发 Critical |
| 数据存在 | 只要有异常数据就告警 | 出现任意 500 错误立即告警 |
| 数据缺失 | 监控日志链路健康 | 采集 Agent 停止上报时告警 |
日志告警建议优先使用「数据存在」模式:将过滤条件写在 Loki 或 VictoriaLogs 的查询中,查询返回数据时,Flashduty 即触发告警。
三种恢复方式
- 自动恢复。数值回落到阈值以下时,告警自动恢复。
- 恢复阈值。单独设置恢复条件,例如
$A < 5。数值在阈值附近波动时,告警保持稳定,避免反复触发和恢复。 - 恢复查询。使用另一条查询判断是否恢复,支持
${label_name}变量替换。告警和恢复需要不同查询的场景(例如交换机网卡状态变化)适合采用这种方式。
# 告警查询:查错误日志
count_over_time({job="mysql"} |= "error" [5m])

# 恢复查询:查恢复标记日志
count_over_time({job="mysql"} |= "recovered" [5m])
在告警中附带日志原文
日志告警触发后,值班人员首先需要知道触发告警的是哪条日志。
配置「关联查询」并将查询结果写入规则的备注模板后,告警消息会附带日志原文:
error log count: 23.000
Loki log time: 2026-01-09T10:23:45+08:00
Loki Log line: [ERROR] Connection refused to database server 10.0.1.5:3306
值班人员收到的是包含第一条排查线索的告警,而不仅是「日志异常」的提示。
配置方法见 Loki 告警规则配置和 VictoriaLogs 告警规则配置。
三条可复用的规则
规则一:监控应用错误日志(Loki)。5 分钟内错误日志超过 10 条时触发 Warning,超过 50 条时触发 Critical。
count_over_time({job="myapp"} |= "error" [5m])阈值设为 Warning $A > 10,Critical $A > 50。
规则二:检测 HTTP 500 错误(VictoriaLogs)。出现任意一条即告警。选择「数据存在」模式,查询返回数据即触发告警。
_time:5m and status:500 | stats by (service) count(*) total | filter total:>0规则三:监控日志采集链路。某台主机超过 15 分钟未上报日志,可能表示采集器已停止运行。选择「数据缺失」模式,持续无数据时触发告警。
# Loki
rate({job="node-logs"} [1m])
# VictoriaLogs
_time:15m | stats by (host) count(*) totalFlashduty 负责响应环节
日志引擎仍为 Loki 和 VictoriaLogs,Flashduty 负责后续的响应环节:原生 LogQL 和 VictoriaLogs 规则、私有网络中的边缘部署、恢复逻辑、通知中的日志样本、聚合和抑制、飞书/钉钉/企业微信/Slack/PagerDuty 等 20+ 通知渠道,以及 7x24 值班排班。
如需试用,请免费注册 Flashduty,并创建一条 Loki 或 VictoriaLogs 规则进行验证。