
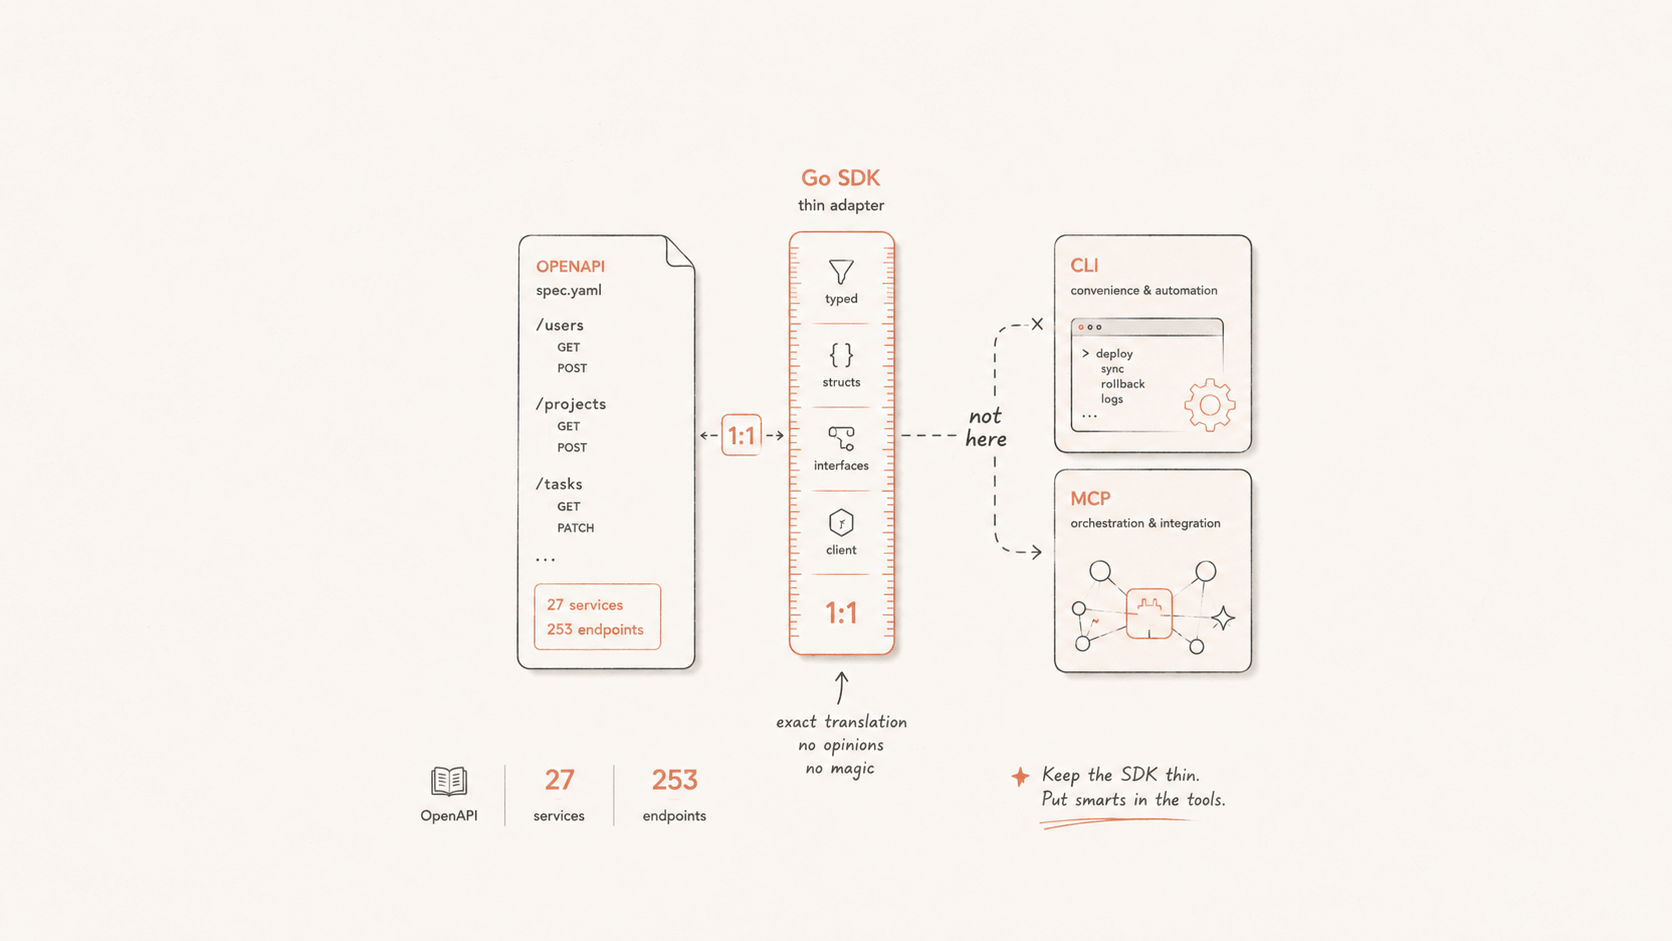
go-flashduty 是 Flashduty Open API 的官方 Go 客户端。v0.5.3 覆盖了 27 个服务下的全部 253 个 REST 接口,每个方法只发送一次 HTTP 请求。
我们为该 SDK 制定了三条规则:
- 代码由 OpenAPI 规范生成,而非手写。
- 每个方法对应一个 API 接口,严格一一对应。
- 便利逻辑放在上层,SDK 只保留接口映射。
我们认为,大型 SDK 能否长期维护,取决于这三条规则。安装命令为 go get github.com/flashcatcloud/go-flashduty。下文逐条说明理由。
253 个接口不宜手写
手写 SDK 看似更精细,每个方法的名称都可以单独推敲,还可以附加便利逻辑。但当接口数量达到几百个、后端仍在持续变更时,手写存在两个主要问题。
第一个问题是不一致。分页参数应命名为 Limit 还是 PageSize?错误如何包装?时间字段如何处理?request_id 位于响应的哪个位置?这些细节会随着作者和时间逐渐偏离。三个月后,代码中会出现三种分页写法和两种错误类型,且无法判断哪一种是正确的。
第二个问题是滞后。后端每新增一个接口或修改一个字段,都需要有人同步修改 SDK,而实际工作中这一步经常被遗忘。结果 SDK 始终落后 API 半个版本,文档与代码不一致,直到用户提交 issue 才发现遗漏。
因此,我们从项目开始就由 OpenAPI 规范生成 SDK。服务分组、方法签名、请求和响应类型都来自同一份规范。一致性由生成器保证,而非依赖人工约束。所有方法的结构相同:
client, err := flashduty.NewClient("YOUR_APP_KEY")
if err != nil {
    log.Fatal(err)
}

list, resp, err := client.Incidents.List(context.Background(), &flashduty.ListIncidentsRequest{
    Progress:    "Triggered",
    ListOptions: flashduty.ListOptions{Limit: 20},
})
if err != nil {
    log.Fatal(err)
}
fmt.Printf("request_id=%s total=%d has_next=%t\n", resp.RequestID, resp.Total, resp.HasNextPage)
for _, inc := range list.Items {
    fmt.Printf("[%s] %s\n", inc.IncidentSeverity, inc.Title)
}
每个服务对应一组方法,例如 client.Incidents 和 client.Alerts。每个方法都返回 (*T, *Response, error)。掌握一个接口的用法,即可使用全部 253 个接口。对大型 SDK 而言,这种统一的结构最有价值。
一个方法,一次请求
代码生成解决了接口的引入问题。更难的问题是:方法中应当包含多少逻辑?
我们的做法很保守:每个方法只发送一次 HTTP 请求,不隐式调用其他接口,也不做额外封装。这条规则看似简单,却是我们执行最严格的一条。
以短 ID 为例。Flashduty 的许多资源有两种 ID:完整 ID 和较短的短 ID。一个追求便利的 SDK 可能这样实现:接收短 ID 后,先调用解析接口获取完整 ID,再调用目标接口。
我们没有在 SDK 中采用这种实现,原因有两个。
第一,调用方的统计会失准。调用 Incidents.Info 应当只发送一次请求。如果 SDK 在后台额外发送一次请求,调用次数、延迟、限流计数和错误归因都会与调用方的预期不符,监控中会出现两倍的请求量。
第二,SDK 会不断膨胀。短 ID 解析只是开端,随后会出现自动翻页、同时获取关联资源等需求。每项需求单独看都合理,叠加之后,SDK 会变成行为难以预测、代码难以删减的胖客户端。
因此我们制定了分层规则:SDK 与 API 严格一一对应。短 ID 解析、自动翻页、跨资源拼装等便利功能,都放在上层的 flashduty-cli 和 MCP Server 中。我们也不会为了便利而让某个接口承担其设计用途之外的工作。
采用这种分层后,SDK 的职责少而固定,因此能够保持精简、可预测、易于测试。频繁变化的便利逻辑放在上层。上层适合快速迭代,即使出错也不会影响 SDK。
精简但不简陋
「精简」是指 SDK 不替调用方做业务决策,而不是把原始 HTTP 细节直接交给调用方。凡是能让单次调用更易用的工作,SDK 都已完成。下面举三个例子。
时间字段。API 传输的是 Unix 时间戳整数,直接暴露整数不便于人工阅读和日志记录。因此,SDK 将响应中的时间字段定义为 Timestamp 类型,默认输出 RFC3339 字符串,在 JSON、日志和大模型输入中都可直接阅读。需要原始时间戳时,调用一个方法即可获取:
inc := list.Items[0]
fmt.Println(inc.StartTime)          // 2026-05-23T13:37:11+08:00
epoch := inc.StartTime.Unix()       // 1779514631  (原始 wire 值)
t := inc.StartTime.Time()           // time.Time
错误处理。调用方无须比较错误字符串,可直接使用类型判断函数。这些函数底层使用 errors.As,能够识别被包装的错误:
if flashduty.IsNotFound(err) { /* ... */ }
if flashduty.IsRateLimited(err) { /* ... */ }
重试。重试逻辑刻意放在主包之外,作为可选的 retry 子包,以 http.RoundTripper 中间件的形式接入:
client, err := flashduty.NewClient("YOUR_APP_KEY",
    flashduty.WithTransport(retry.New(
        retry.WithMaxRetries(3),
    )),
)
这一设计同样遵循一一对应原则:主客户端只负责发送一次请求,重试、缓存和链路追踪都作为可插拔的传输层中间件,按需接入。
规范是唯一的事实来源
最后是维护问题。SDK 在发布当天通常是正确的,难点在于一年后是否依然正确。
我们的做法是:代码由 OpenAPI 规范生成,方向不可反转。后端接口变更时,先修改规范,再重新生成 SDK。整个流程中不存在手动同步 253 个方法的步骤。
在此基础上还有两层校验。每个方法都有单元测试,用于检查生成结果的结构。整个 SDK 还会针对线上 API 运行端到端测试,确认请求和响应与服务端一致。代码生成保证 SDK 内部一致,端到端测试保证 SDK 与实际服务一致。缺少任何一层,SDK 都可能逐渐偏离实际。
开始使用
使用 Go 对接 Flashduty 时,无论是编写自动化脚本、开发集成,还是为 AI Agent 提供可靠的工具集,都可以使用 go-flashduty。代码托管在 GitHub 上的 go-flashduty 仓库。