
想查看 DeepSeek 当前是否正常? 官方状态页是 status.deepseek.com,由 Flashduty Statuspage 提供。下文介绍这次迁移的经过。
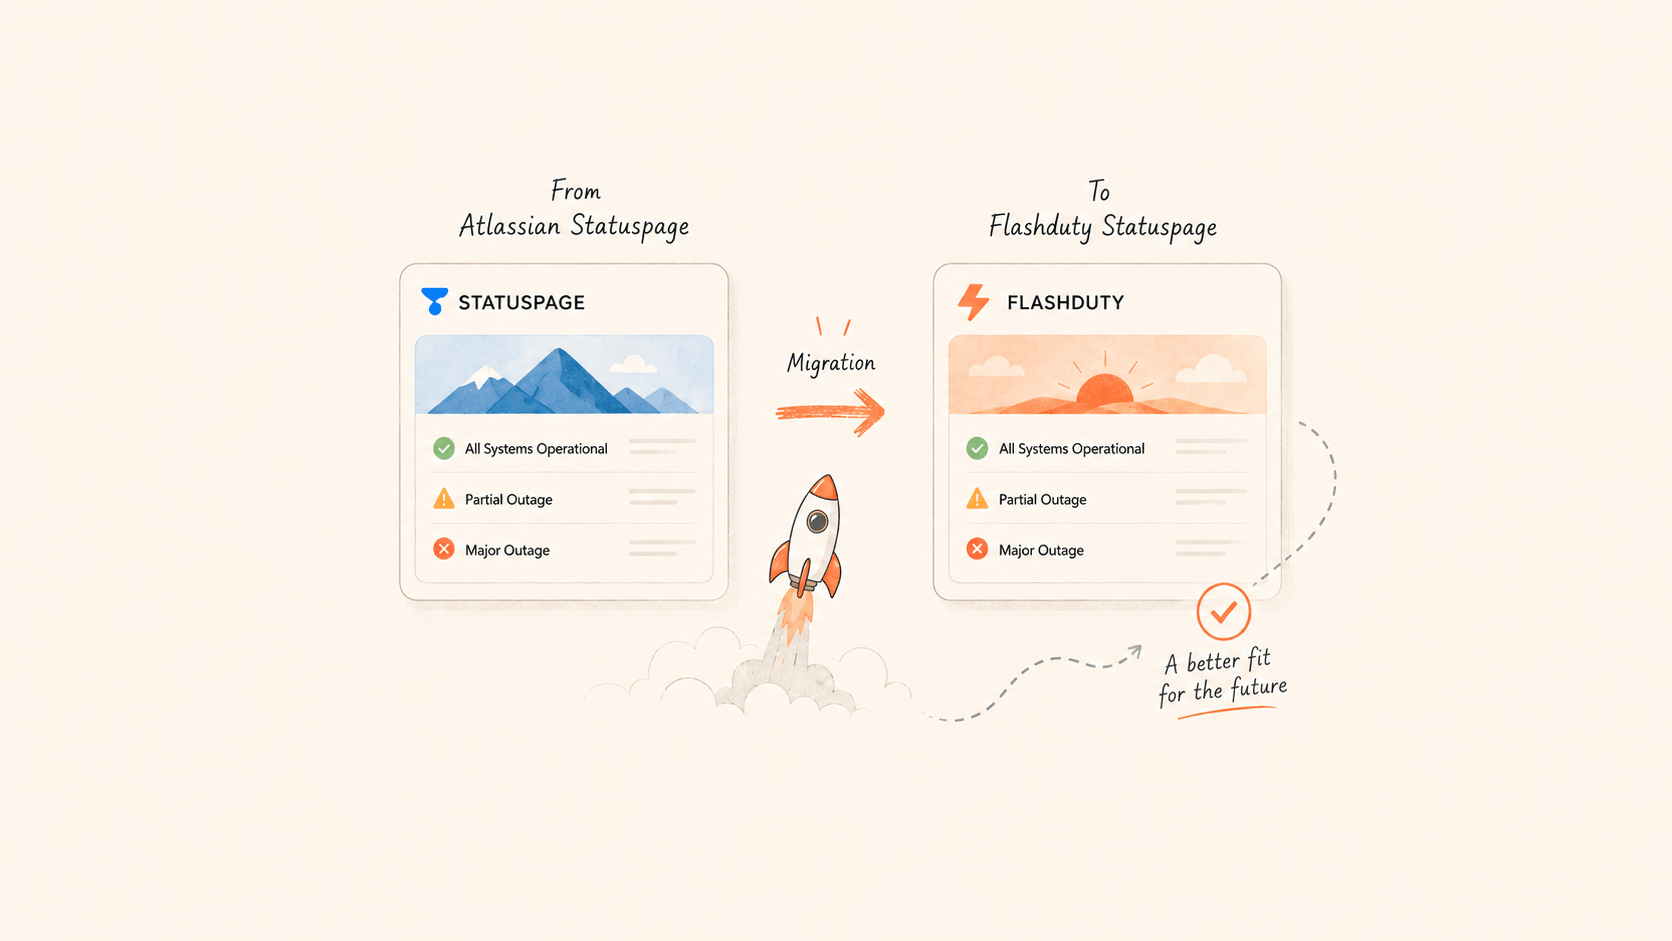
DeepSeek 已把公开状态页从 Atlassian Statuspage 迁到 Flashduty Statuspage。影响选型的主要有三点:原生中文、成本,以及页面体验。迁移分两步,用两条 CLI 命令完成,订阅者无须重新验证邮箱。
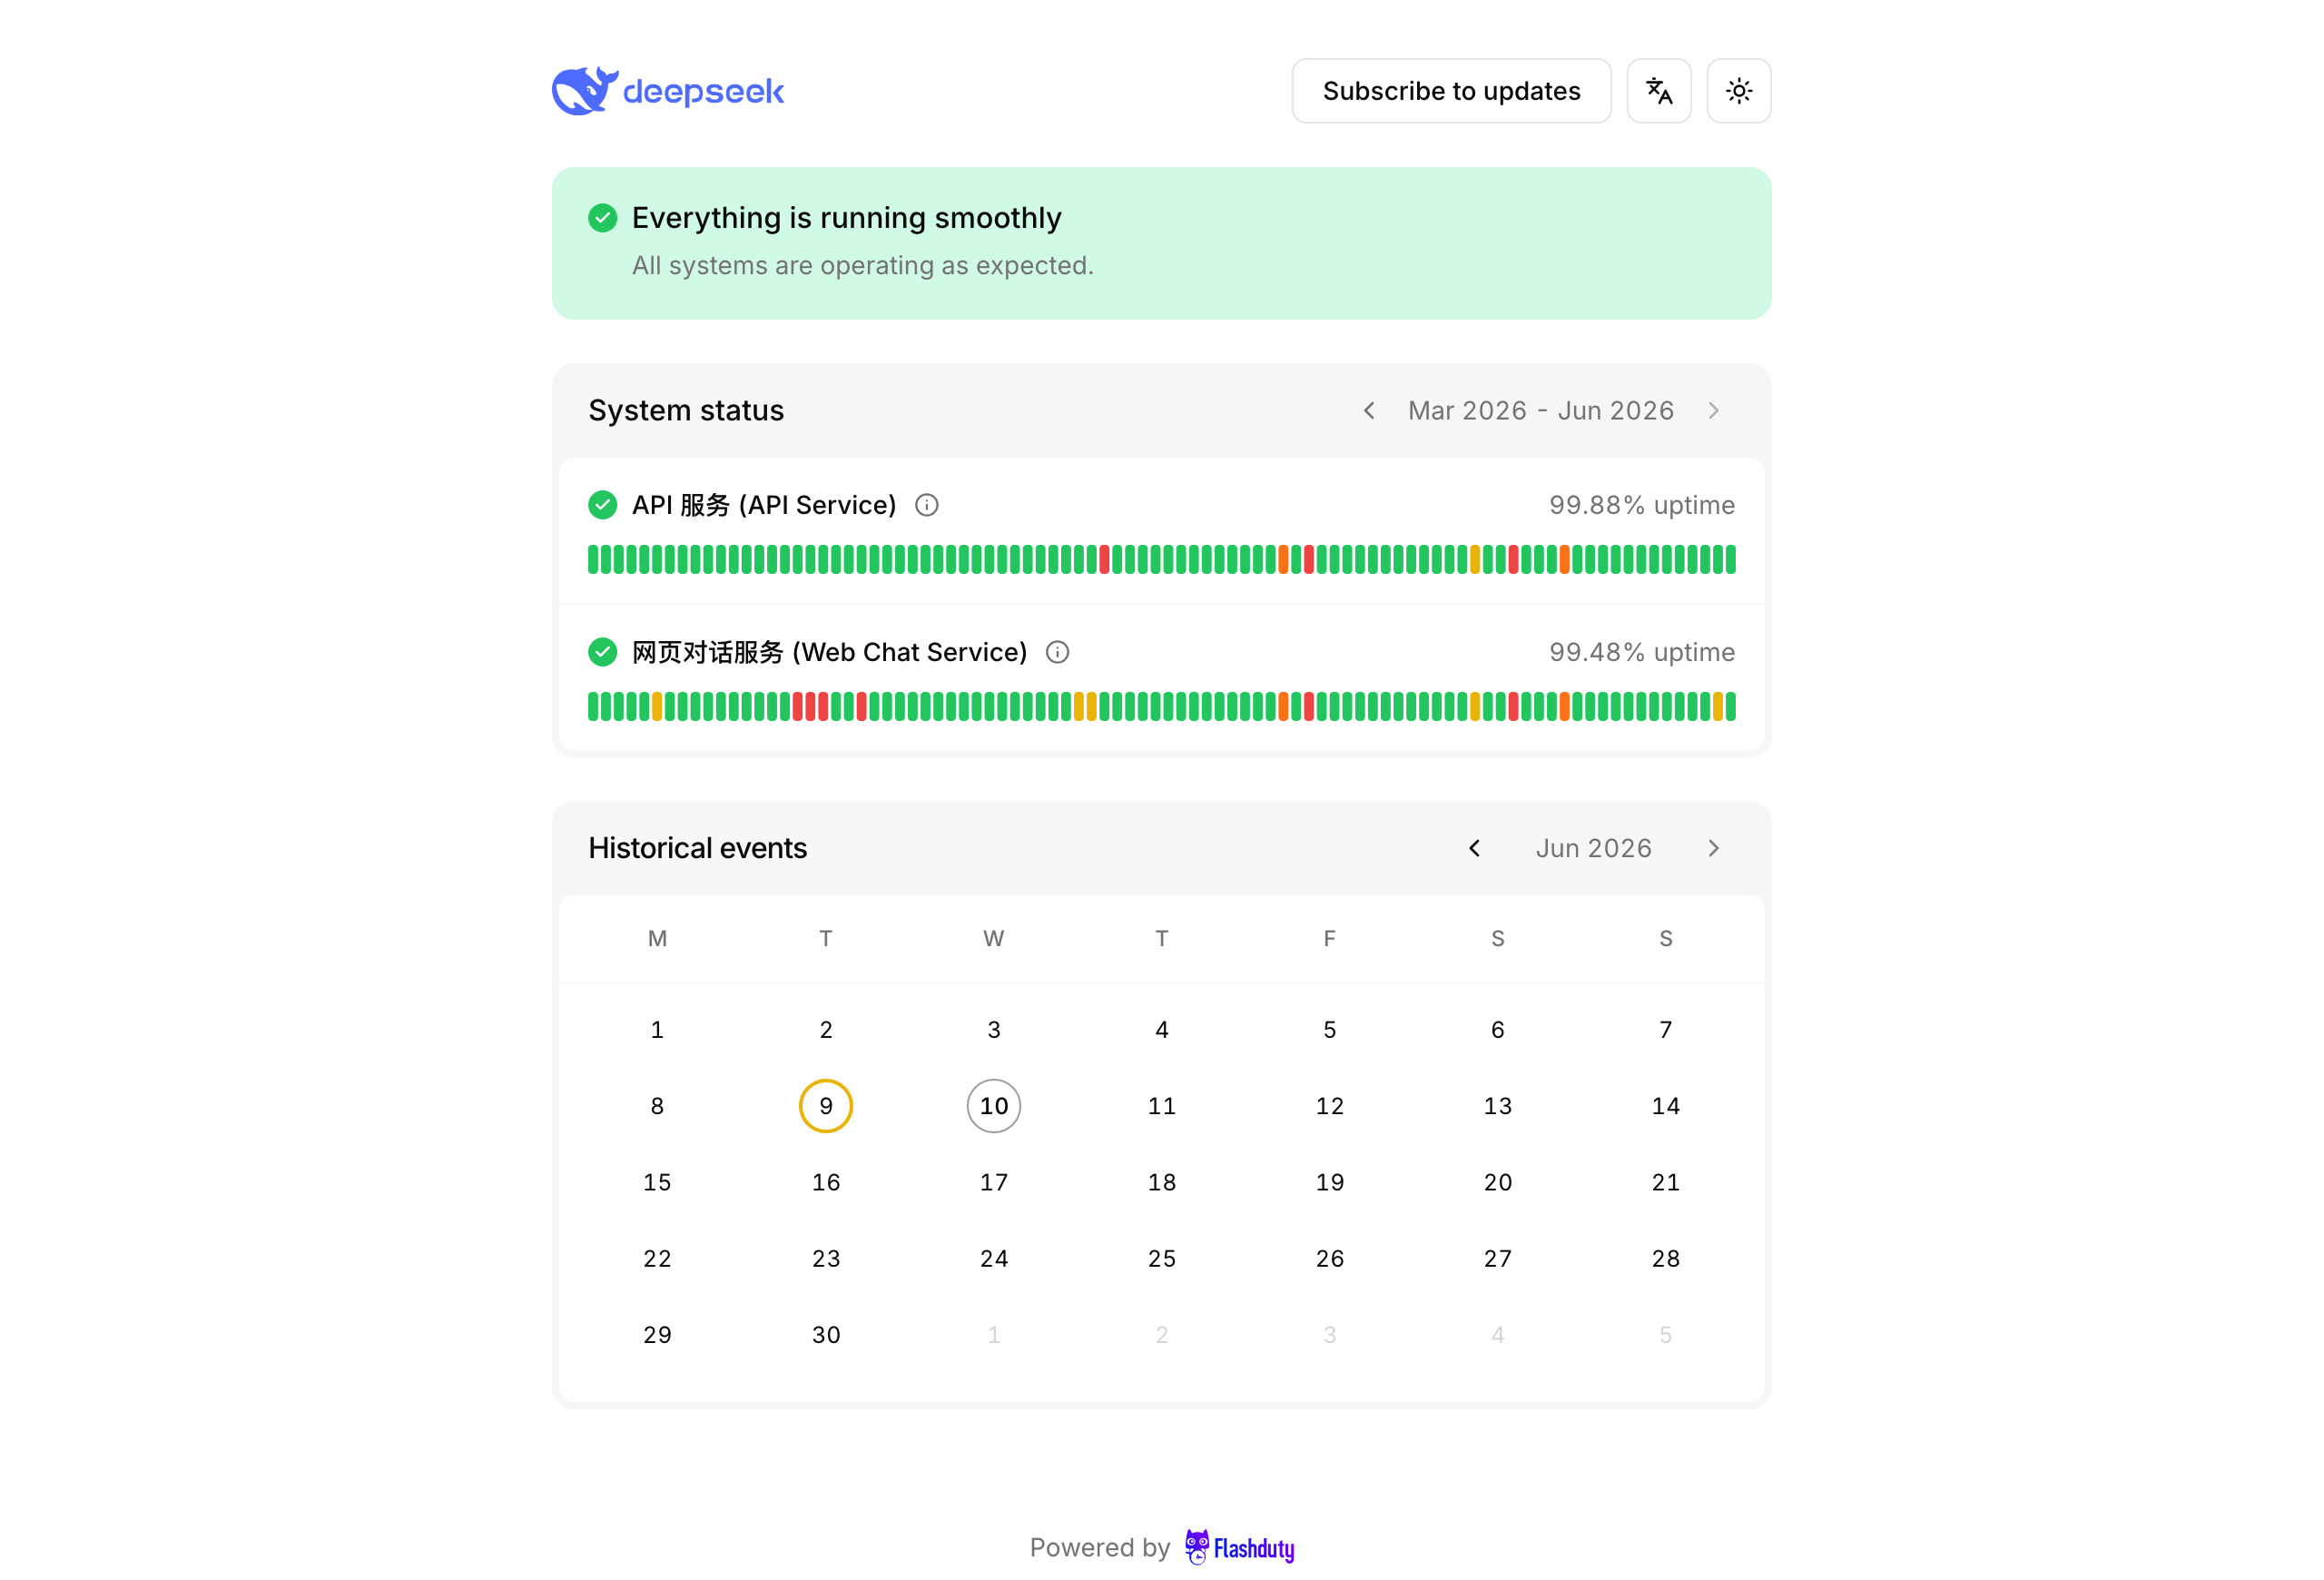
状态页平时很少有人访问。服务一旦出现异常,它就成为外部能看到的少数入口之一。用户会刷新,客户会转发,媒体也会关注。因此,状态页承担的是故障期间的对外沟通,选型时不能只当作展示页。
选择 Flashduty 的三个原因
中文支持
据我们了解,Atlassian Statuspage 的公开页目前没有原生中文。多语言需要借助第三方本地化工具,例如 Localize。DeepSeek 的用户大多阅读中文,故障时只提供英文状态页,体验欠佳。
Flashduty 原生支持中文,页面带语言切换。组件名可以中英并列,例如“API 服务 (API Service)”。一个页面能同时服务国内外用户。
成本
Atlassian Statuspage 是独立产品,按订阅者、组件和团队成员分档收费。公开页加内部页,一年的费用可能达到数千美元。
Flashduty 状态页包含在 On-call 中,不单独收费。已在使用 On-call 的团队,状态页就是同一条故障响应链路的一个出口。剩余的按量费用主要是邮件推送。
页面体验
暗色模式、渲染性能和全球访问加速,如今已是基本要求。DeepSeek 的状态页如果加载慢、显示模糊或海外访问不稳,都会被放大。Flashduty 的状态页按当前公开页面的标准设计,而非老式运维后台换皮。
两者还有一些细节差异,例如维护事件不计入可用率、事件级订阅和组件展示控制。订阅者批量导入导出也有区别。这些差异和价格测算见状态页对比文档。
为什么不自建
工程师看到状态页,第一反应往往是“这个可以自己写”。如果只是展示几个组件、写几条事件时间线,确实不难。难点在页面之外。
可信度
状态页面向外部用户。托管在独立的第三方平台上,比托管在自己的服务器上更可信。服务出问题时,外部用户无须怀疑状态页在自说自话。状态页也不会与业务系统一起宕机。自建方案在结构上无法提供这种独立性。
长期维护
状态页并非静态页面。订阅管理、邮件送达、可用性统计、事件时间线和内部页,都需要有人开发和长期维护。对多数团队,这些都不是主营业务,投入的工程时间很难收回。
短期无法补齐的能力
最典型的是邮件信誉。向上万订阅者可靠送达邮件,依赖长期积累的 IP 和域名信誉、SPF/DKIM/DMARC 配置,以及退信和投诉处理。积累不足,邮件就会进入垃圾箱。
故障时的流量高峰也是如此。状态页平时访问量低,一出事所有人同时涌入,峰值常常高于业务本身。这两项能力取决于时间和规模,无法靠多写几行代码解决。
迁移如何避免惊动订阅者
DeepSeek 这次是迁移,而非重新搭建。Flashduty CLI 把迁移分为两步,降低风险:
- 运行
flashduty status-page migrate-structure,导入组件、分组、历史事件和通知模板。这一步不涉及订阅者。在控制台核对结构和历史记录无误后,再进行下一步。 - 运行
flashduty status-page migrate-email-subscribers,导入订阅者。订阅者导入后直接处于活跃状态,无须重新验证邮箱。
最后,把自定义域名的 CNAME 指向 Flashduty,确认无误后上线。
RSS 订阅者无须任何改动。Flashduty 兼容 Atlassian 的 history.rss 和 history.atom 格式,旧地址照常可用。命令参数和完整步骤见状态页对比文档的迁移一节。
适合参照这条路径的团队
状态页选型不能只看能否展示服务状态。还要考虑中文支持、采购成本、自建的可信度、邮件信誉、故障流量和订阅迁移。
如果团队正在使用 Atlassian Statuspage,用户又以中文为主,可以参照 DeepSeek 的做法迁移。
相关文档: