
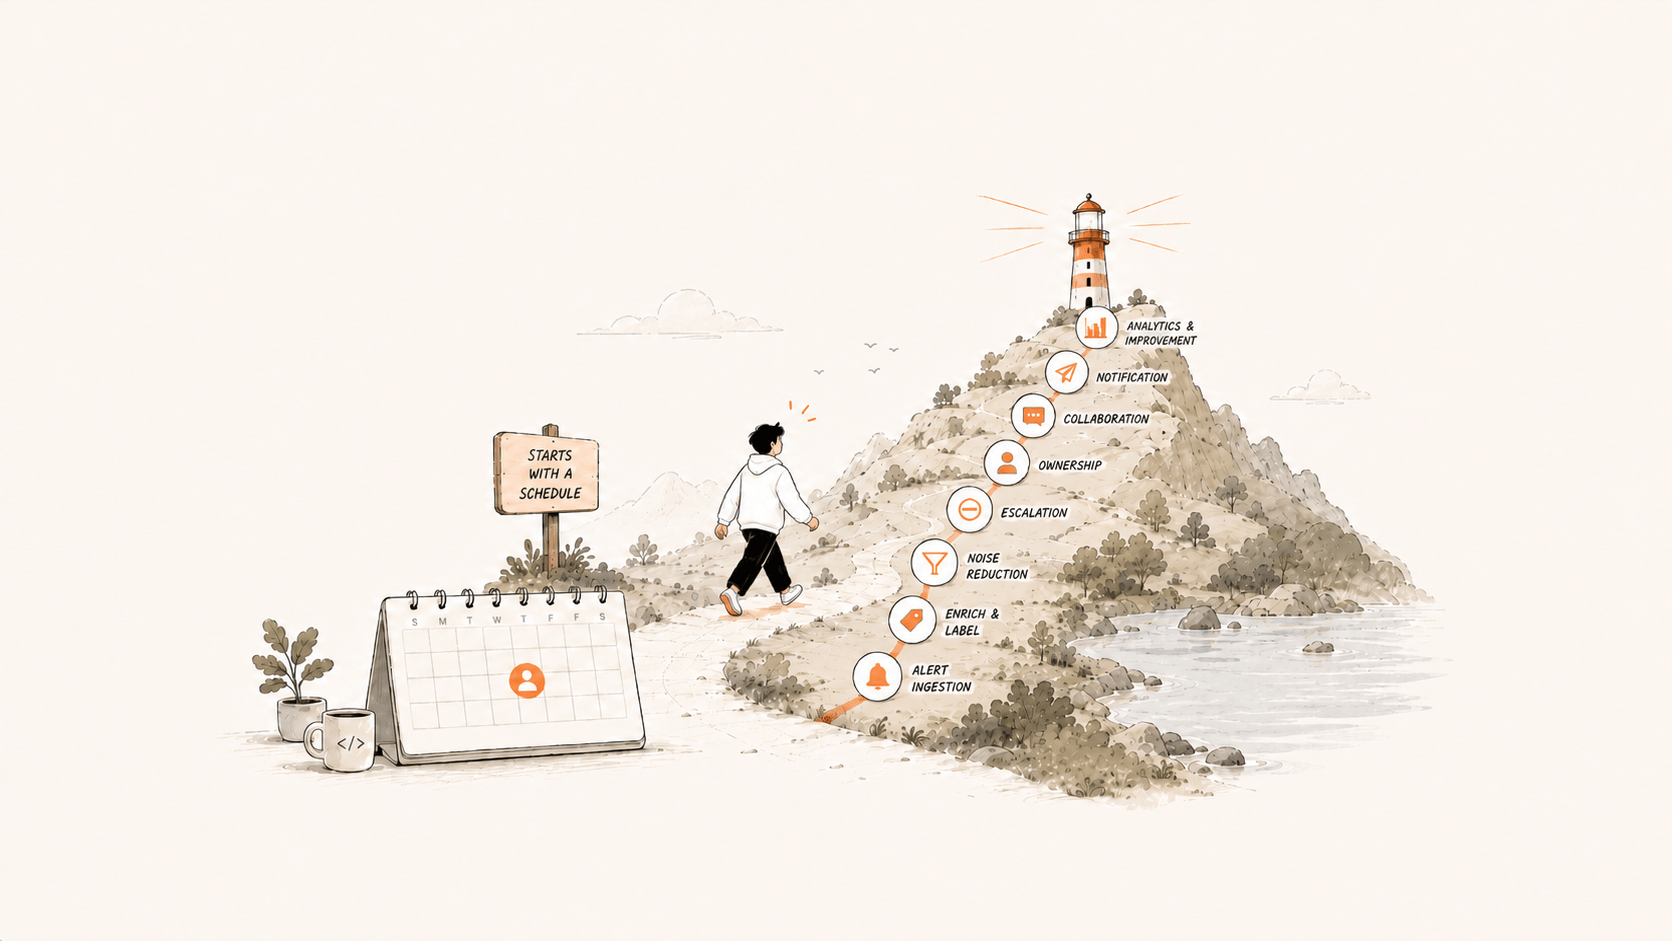
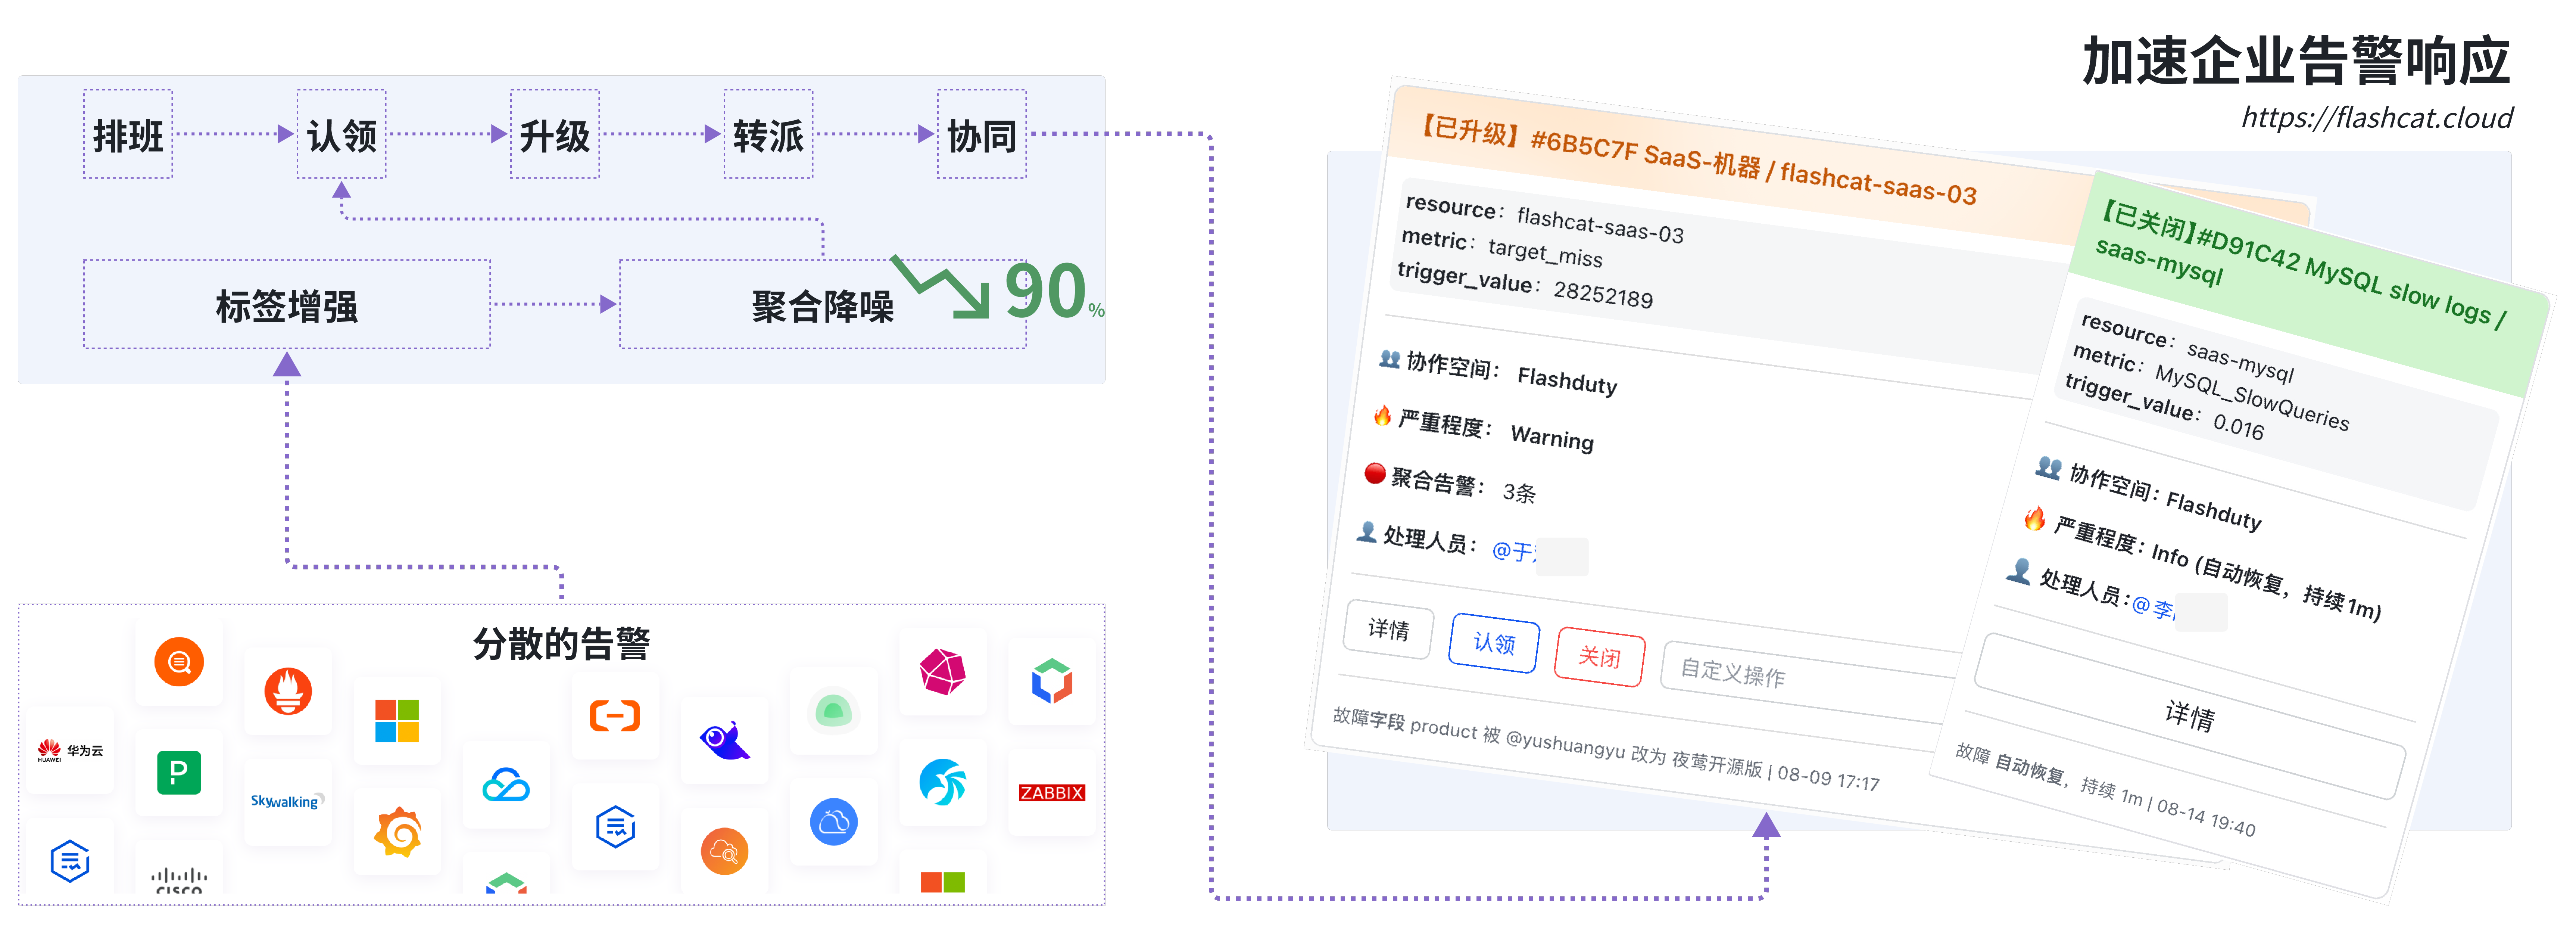
一套 On-call 体系管理的是从告警产生到复盘结束的整条链路。链路的前四个环节是告警接入、标签增强、聚合降噪和告警抑制。后四个是排班、认领与升级、通知和数据统计。任何一个环节做得粗糙,整体体验都会变差。
本文按顺序说明每个环节为什么需要、做到什么程度合适、哪里容易出错。先说结论:最划算的降噪发生在告警产生之前,即从源头治理告警规则。
源头治理:只为需要行动的问题叫醒人
八个环节都在告警产生之后发挥作用。成本最低的降噪,是从源头治理告警规则。两条原则如下:
- 每条告警都应可处理(actionable),即对应一个明确的止损动作或 SOP。只是提醒、无须任何人行动的告警,大多是多余的。担心漏掉大事,可以让它自动创建一张工单,定期查看,而不打电话、发短信。
- 对结果类指标告警,而非原因类指标。对外提供 HTTP 服务时,接口成功率和延迟是结果类指标,最应关注。CPU 利用率是原因类指标,放进监控大盘即可。原因类指标异常、结果类指标正常,说明业务尚未受影响,无须半夜叫醒人。
很多团队的告警越积越多,原因在于复盘时第一个问题总是“告警全不全”。为免被追责,工程师宁可多加规则。久而久之,规则中有用和无用的混在一起。新人难以承受而离开,团队持续受损。
告警接入:先把所有告警收到一处
On-call 的第一步,是把散落在各个监控工具中的告警收敛到一个平台处理。绝大多数监控系统都支持 Webhook。On-call 平台只需为不同来源做好适配并提供对应的 Webhook,用户的接入成本就最低。
有些不够开放的系统只发邮件,没有 Webhook。平台如果能接收这些邮件、解析正文,并转为结构化告警,就多了一种补充手段。
取舍:邮件解析天然脆弱,对方稍改模板就可能失效。它只适合作为补充,不宜作为首选。能用 Webhook,就不用邮件。
标签增强:告警字段越丰富,处理越快
很多监控工具发出的告警字段很少,只有机器名、监控项和阈值。工程师半夜被叫醒,只看这几个字段,无法判断影响范围。
平台如果能对接外部元数据(例如 CMDB),就能在告警进入时补全字段。补全的内容包括机器所属的业务、环境和负责人。补全的标签既能让分发更自动化,也能让工程师一眼判断严重程度。
基线:应当增强的,是直接影响“是否叫醒人、叫谁”的字段。为了美观而添加无人查看的标签,只会增加噪音。
聚合降噪:把大量告警压缩为少数故障
这是 On-call 产品最重要的能力之一。一次大规模故障可能同时触发成百上千条告警。逐条通知会让工程师的手机被打满,反而拖慢处理。聚合降噪把同时触发的相似告警归并为少数几个故障(incident),并只按故障通知。
聚合可以基于规则,也可以基于语义相似度,并且可以跨数据源。来自 Zabbix 和 Prometheus 的告警,只要相似,就能合并到一起。
除大规模实例告警外,抖动告警也是典型场景。这类告警反复触发、恢复、再触发。用相同标签把它们收敛为一个故障,通知频率会大幅降低。
告警抑制:克制使用,避免重度依赖
抑制与降噪不同。降噪合并相似的告警,抑制则引入依赖关系。高级别的告警可以抑制级别较低的告警,底层基础设施告警可以抑制上层模块告警。例如机房断网后,无须再为机房内的每个服务单独告警。
风险:依赖关系维护成本高,也不易解释。一旦某条应该响的告警被抑制规则悄悄吞掉,排查非常困难。因此,抑制只适用于少数边界清晰、依赖稳定的场景,大规模场景不宜重度依赖。能用聚合解决的问题,就不用抑制。
排班:避免整个团队被反复打断
排班的目的,是避免整个团队被告警反复打断,同时保证任何时刻都有合适的人在线。On-call 能让工程师成长,但工作琐碎,还经常需要夜间处理。长期连续值班会损害健康,所以必须轮换。
设计排班时,需要考虑五个维度:
| 维度 | 要求 |
|---|---|
| 公平性 | 每人分配均衡,避免有人总在周末或节假日值班 |
| 灵活性 | 支持提前或临时换班,应对请假和休假 |
| 轮换周期 | 按小时、天、周、月轮换,取决于业务节奏 |
| 角色 | 通常分主值班和备值班;主值班过载或未及时响应时,升级给备值班 |
| 交接通知 | 轮换时有清晰的通知,可以提前 N 分钟通知下一班,也可以每天定时播报 |
认领、升级与协作:让每条告警都有归属
认领:理论上每条告警都应被认领。反过来看,一条告警无人认领也没造成任何后果,它就不该发出。认领效率通常用平均认领时间(MTTA)衡量。
升级与转派:提前为不同级别的告警规划升级路线,能明显降低值班人员的心理压力。升级可以手动,也可以自动。例如,某条告警超过 30 分钟既无人处理也未恢复,就自动升级给主管或备份人员。
很多需要 7×24 支持的团队采用分层响应模式:
| 层级 | 通知对象 | 触发方式 |
|---|---|---|
| L1 | 当班的一线值班人员(按班次轮换) | 告警产生即通知 |
| L2 | 各方向主责(研发、稳定性、运维) | L1 未及时响应或问题升级时触发 |
| L3 | 应急响应代表、业务负责人 | 重大故障未收敛时触发 |
具体做法是为 L1、L2、L3 各建一张值班表。再在分派策略中设置三个环节,每个环节绑定对应的值班表。“先通知谁、无响应再通知谁”就能自动执行,无须有人半夜手动拉人。
协作:处理过程中可以随时拉入相关人员。关键是及时、准确地通知对方,并完整保留处理过程和时间线。后加入的人能快速了解全貌,不必反复询问“现在进展到哪一步”。
通知:触达体验决定效果
告警发不到对的人手上,或对方无法直接操作,再好的告警也没有效果。海外团队大量使用 Slack,它已成为协作领域的基础平台。国内则主要使用企业微信、飞书和钉钉。这些 IM 都支持开发内置应用。在 IM 卡片中直接认领、关闭、转派和处理告警,是提升 On-call 体验的关键。
例如,告警在夜间响起,值班人员一看就知道短期内无须处理。如果能在手机 IM 中点几下完成处理,就不必起床开电脑。这个细节对值班体验的改善非常明显。
数据统计:没有数据,就无法治理
全公司的告警汇总到一个平台后,最大的收益是能按维度统计。告警压缩率、MTTA、平均恢复时间(MTTR)、认领比例和告警数量,是衡量 On-call 效率的关键指标。按业务、团队、个人拆分,就能定位薄弱环节。
更实际的用途是治理告警规则本身。频繁触发的规则往往不合理:既浪费电话和短信费用,又影响员工情绪,稳定性也未见改善。这类规则应该修改或删除。
On-call 的好坏,一半取决于产品,一半取决于认知。一线工程师痛苦而管理层毫无察觉,双方就无法有效沟通。认真对待 On-call,有时比加薪更能提升团队的满意度。
Flashduty 把上述各个环节都做成了产品能力。具体包括多源告警集成、聚合降噪、排班与升级、IM 双向触达和数据看板。如果正在搭建或重建 On-call 体系,可以从 Flashduty On-call 开始。