
Google 内部的 On-call 工具 Outalator 从未开源,但 On-call 的难点在别处。Google SRE 和 Datadog 的投入主要在两件事上:把琐事控制在 50% 以内,以及让排班可持续。工具负责把告警收敛为故障,为协作、交接和复盘提供基础。
对大多数团队,可以从三项动作起步:先建立度量,再让排班可持续,最后选择工具。前两项无须额外预算。
工具只占 On-call 的一小部分
Kubernetes 源自 Google 内部的容器编排系统 Borg,Prometheus 源自内部监控系统 Borgmon。由此很容易追问:Outalator 有没有对应的开源产品?
这个问题的重点放错了。《Site Reliability Engineering》用近三章讨论 On-call。工具在其中只占很小的篇幅。On-call 的质量取决于文化、机制和工具三者的配合。工具最容易复制,也最容易被高估。
Google SRE:琐事不超过 50%
Google SRE 主张用软件工程的方法解决运维问题,减少琐事(toil)。落到执行层面,他们设定了一个公开、可考核的目标:每位 SRE 花在琐事上的时间不超过 50%。其余时间投入工程项目,用来消除未来的琐事,或为服务增加能力。
目标定为 50%,而非“尽量少”,是因为模糊的目标无法考核。写成可度量的上限后,超标会被看到,有人要负责,团队会补人或减负。
Google SRE 列出了琐事失控的三项代价:
- 职业停滞。工程时间被挤占,个人成长变慢甚至停滞。不可避免且影响大的脏活应该做,但重复劳动无助于职业发展。
- 士气与留存。每个人对琐事的容忍都有上限,超过就会倦怠和不满。琐事过载时,最先想离开的往往是团队里最强的工程师。
- 角色被侵蚀。SRE 本是工程组织。陷入琐事后,研发团队会把本应自己承担的运维交过来,其他团队也默认 SRE 应接手。这种趋势很难逆转。
琐事的最大来源是中断性工作,其次是 On-call。前者多是与服务相关的非紧急事务,后者是紧急的应急响应。Google 的经验是,一个 SRE 团队至少需要 6~8 人,才能把 On-call 带来的琐事保持在低位。人手不足时,轮换无法分摊,最终退化成“只有值班、没有轮换”。
Outalator:以故障为单位处理告警
Outalator 是 Google 内部的 On-call 工具。SRE 在这个集中平台上管理告警的完整生命周期。它的功能很克制:
- 告警聚合:把多条相关告警聚合为一个故障。SRE 以故障为单位跟进,而非逐条处理告警。这一步削减了大量重复通知和重复处理,是降噪的基础。
- 打标签:为故障添加描述上下文的标签,便于筛选、统计和复盘。
- 数据分析:按团队、个人、服务、机房等维度,分析告警量趋势、响应效率和处理效率。团队据此找到 On-call 的薄弱环节。
- 交接与报告:选中一组故障,把标题、标签和关键记录通过邮件交给下一班工程师。“报告模式”用于很多团队每周的生产评审。
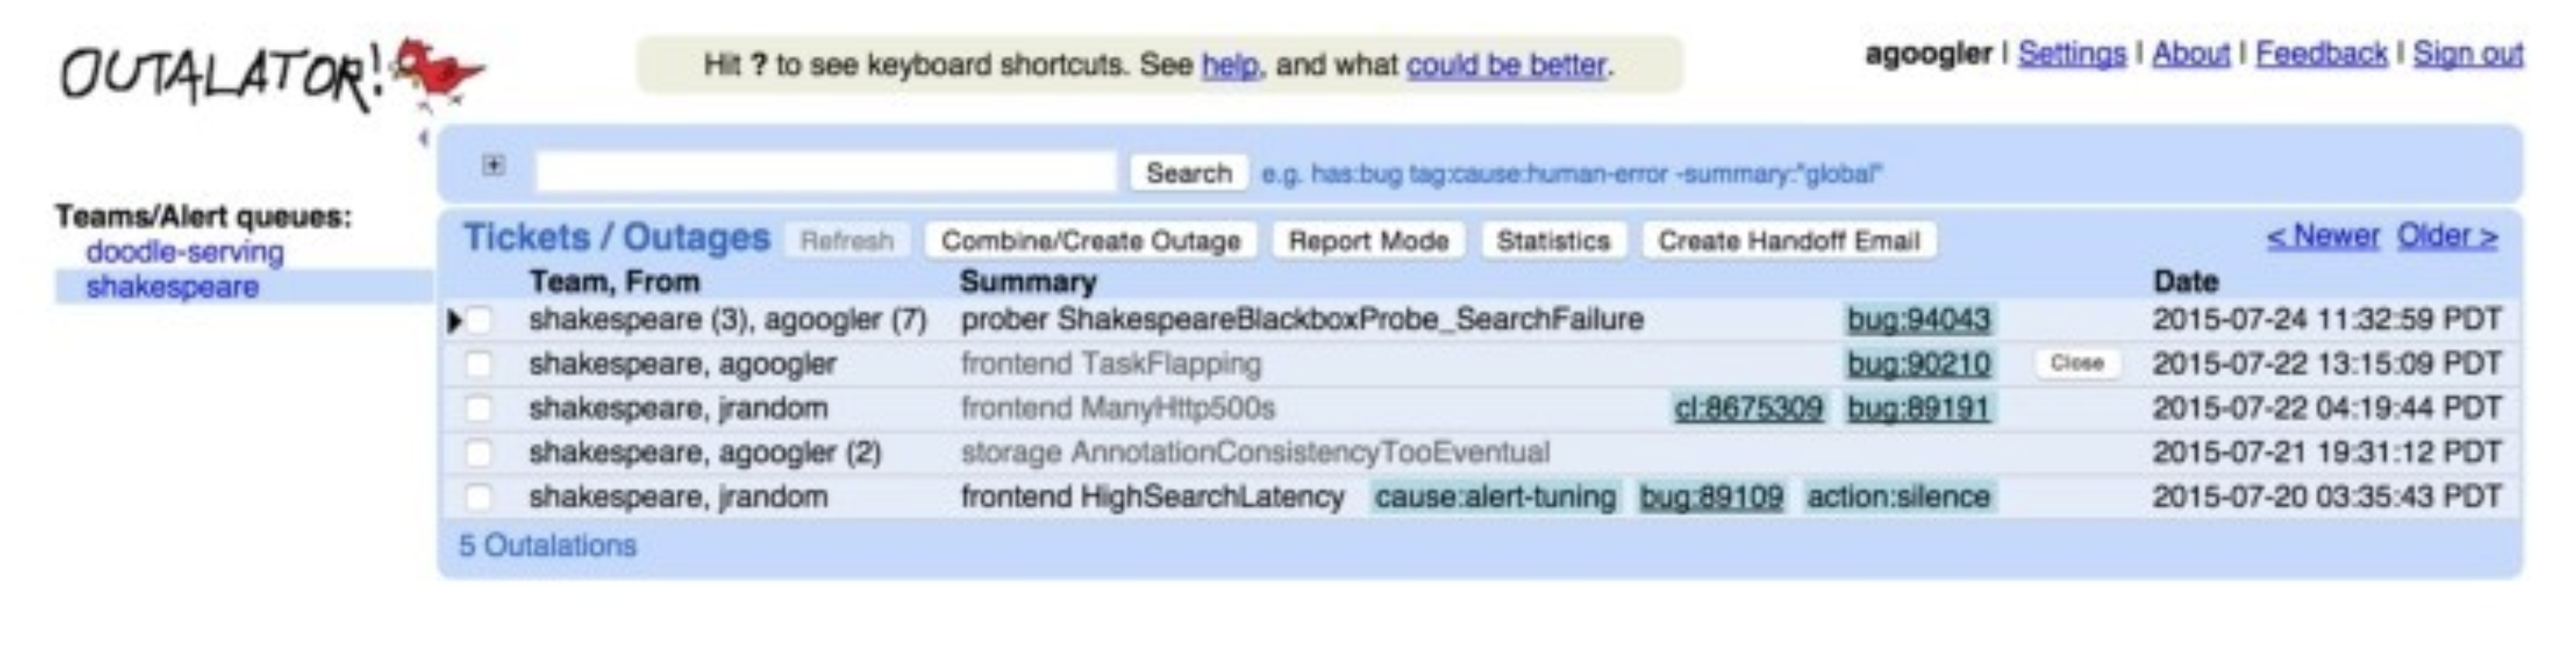
Outalator 做的都是朴素的工作:把告警收敛为故障,让人能够协作和复盘。好的 On-call 工具本身不负责稳定性,它让人有能力去保障稳定性。
Datadog:把可持续写进排班规则
Google SRE 提供了理念框架,Datadog 的做法更接近一份排班操作手册,包括以下几条规则:
- 组的规模有下限。理想情况是 6~8 人一组轮换。人手实在不足时,也要有 3~4 人,才能排出可持续的值班表。这与 Google 的经验相近。
- 单次时长有上限。每班一般 8~12 小时,并把工作量、假期和临时调班一起纳入排班。
- 值班期间只做值班工作。当值工程师负责接告警、巡检、维护告警规则和 SOP,不开发新功能。这条规则在制度上承认值班是一项独立的工作。
- 频率要适中。值班过于频繁会导致倦怠,过于稀少则缺乏改进流程的动力。

排班之外,Datadog 还在两处投入,这两处常被其他团队忽略:
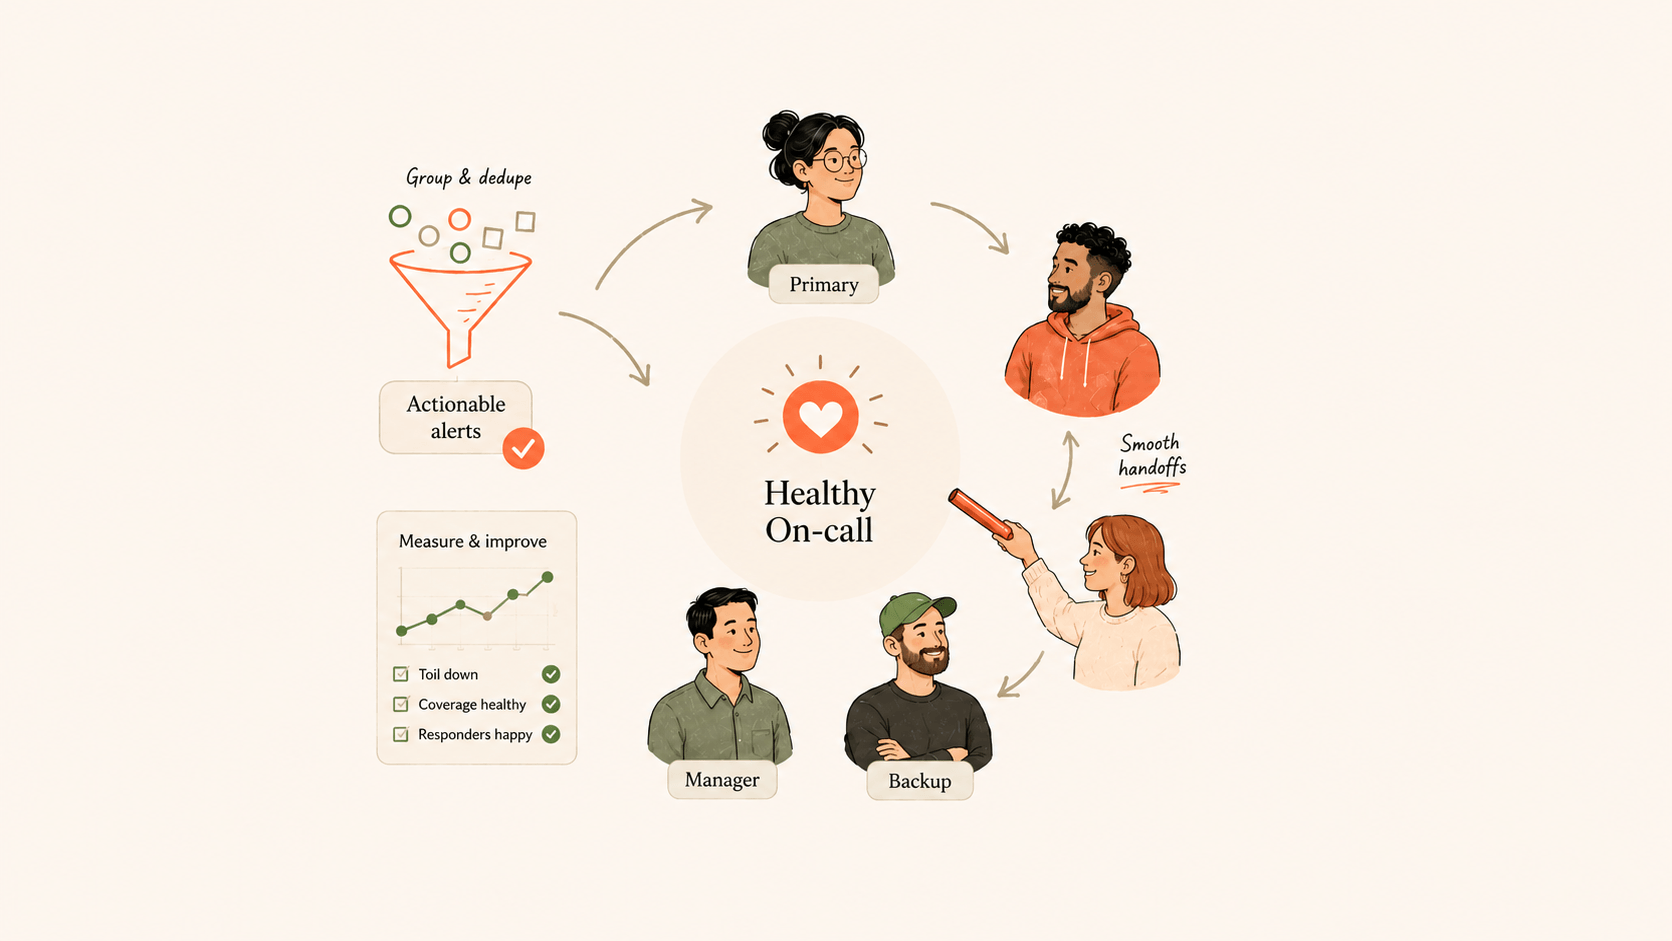
- 给值班人员足够的支持。让人上岗前,应提供培训和资料。Datadog 采用一主一备:主值班没有响应时,系统通知备份;备份也无法处理时,升级到直线经理。这条备份链路避免“半夜无人接听”演变成事故。
- 让经理参与轮值。直接经理参与值班,既为团队做表率,也能亲身体会值班的压力。有了切身体会,经理才有动力优化流程和工具。经理长期脱离一线,会逐渐失去对一线的感知,On-call 流程也会随之变差。
两家的共同结论:把 On-call 当作需要设计的工作
两套实践指向同一个结论。On-call 的好坏与采购的工具关系不大。关键在于是否把它当作一项工作来设计、度量和持续投入。
| 层面 | 做法 |
|---|---|
| 文化 | 以人为本,关注长期结果;承认值班是一种消耗,需要补偿和保护 |
| 机制 | 6~8 人成组,排班可持续,备份和升级链路明确,经理参与值班,琐事不超过 50% |
| 工具 | 以故障为单位聚合告警,服务于协作、交接、度量和复盘 |
三者之中,工具最容易补齐,文化和机制才是门槛。
三项起步动作
完整照搬 Google 的模式,对多数团队并不现实。值班与加班的界限模糊,“只有值班、没有轮换”是常态。规划被短期目标驱动,技术债越积越多。不少公司的 SRE 与研发人数比接近 1:100,组建 6 人 SRE 小组很难。这些结构性阻力确实存在。
不过,团队可以先做成本最低、见效最快的三件事。
第一,建立度量
运维负责人往往只看到“告警太多、团队疲于应付”,却看不清告警处理的真实工作量。这样既无法规划人手,也找不到优化方向。基本的 On-call 度量至少包括五项:
| 指标 | 含义 | 期望方向 |
|---|---|---|
| 降噪比 | 告警聚合后的压缩比 | 越高越好 |
| 响应比 | 被认领的告警占比,反映告警是否有用 | 越高越好 |
| 告警总量 | 时间窗口内的告警数,基于 SLO 的告警能大幅降低该值 | 越低越好 |
| MTTA(平均认领时间) | 反映处理效率和团队压力 | 保持在合理范围 |
| MTTR(平均恢复时间) | 反映可观测能力、基础设施和对业务的理解 | 越短越好 |
能稳定看到这五项指标后,“该补人还是该治理告警”“该删哪条告警”等决策才有依据。
第二,让排班可持续
凑不齐 6 人,就先保住 3~4 人的最小轮换。把单班时长控制在 8~12 小时,明确一主一备以及升级到经理的链路。这些规则无须额外预算,只需写下来并执行。
第三,选择现成的工具
Outalator 没有开源,但市面上已有同类产品。它们在一个平台上接入各类监控系统的告警,并打通 IM 和手机 App。常见功能有聚合降噪、认领、升级、分派和排班调班。
Flashduty On-call 由开源监控工具夜莺背后的团队开发,能接入主流监控系统和 IM。选型时可参考 Flashduty 与 PagerDuty 的对比。
工具只是起点。把告警收敛为故障,把度量摆上桌面,让排班可持续。做到这三步,团队的 On-call 才能持续改进。