
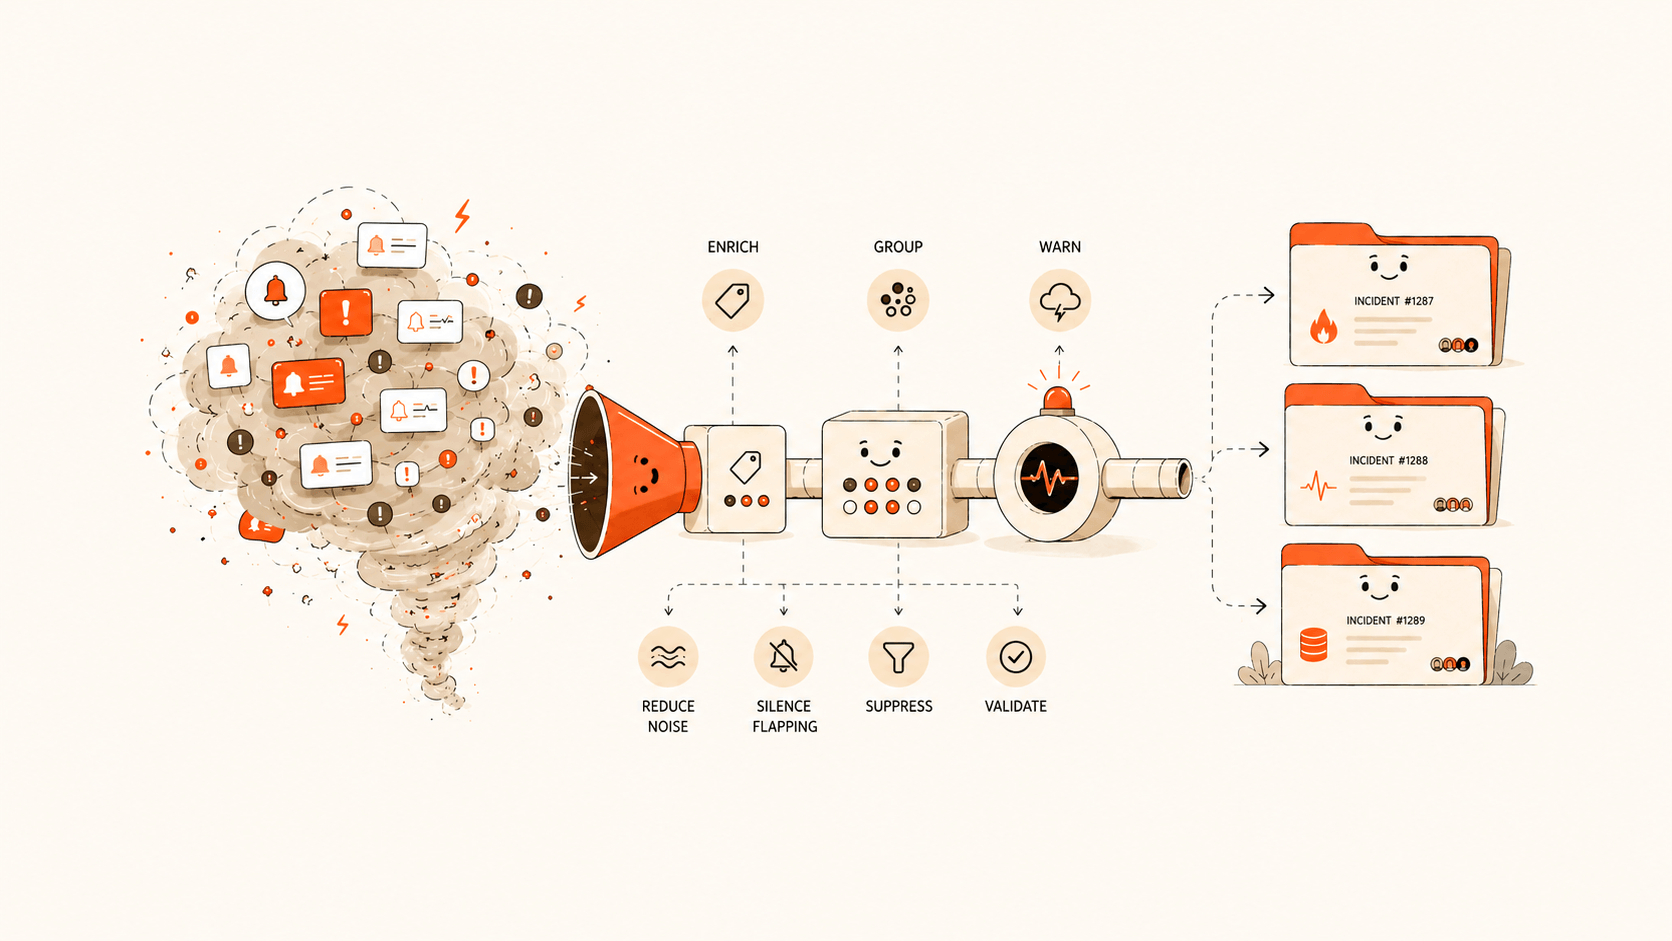
告警降噪的目标,是把海量告警收敛为少量可处理的故障。一台服务器宕机触发 100 条告警,值班人员应只处理 1 次。达到这个目标,无须先删除监控规则。做法是先在响应层补齐标签、开启聚合,再加上静默、抑制和抖动检测。14 天后,用故障数量和夜间中断次数验收。
本文按天给出做法,并附一份可直接套用的配置模板。各项参数的取值范围以 Flashduty 告警降噪文档为准。
14 天路线图
选择一个告警量较大的协作空间,分阶段推进:
| 时间 | 动作 | 观察什么 |
|---|---|---|
| 第 1~2 天 | 接入真实告警,暂不修改规则 | 故障数量、告警 TOP、睡眠时间中断次数、MTTA、MTTR、响应比例 |
| 第 3~5 天 | 补齐标签:service、resource、check、env、team | 标签是否稳定可用 |
| 第 6~8 天 | 对最吵的 5~10 类告警开启聚合 | 重复告警是否合入同一故障 |
| 第 9~10 天 | 配置静默和抖动检测 | 维护窗口和短时自愈告警是否退出强通知 |
| 第 11~12 天 | 配置抑制和风暴预警 | 派生告警是否被压住,大故障是否有二次提醒 |
| 第 13~14 天 | 对比基线数据 | 见文末的验收标准 |
告警风暴的根源在响应层。监控系统把大量事件推给人。响应系统却没有把事件整理成故障,值班人员无从判断、分派、认领和升级。
降噪的第一步不是删规则
很多团队一提降噪,就去监控系统删规则、调高阈值、关闭低等级告警。这些操作有时必要,但不应作为第一步。
直接删规则有风险。删得太多,可能漏掉早期信号。阈值调得太粗,可能等到用户受影响才触发。关掉所有 Warning,短期安静了,长期会失去容量、性能和依赖异常的预警。
更稳妥的做法是先在响应层接住告警,完成收敛、分派和度量。之后再回到监控侧,优化确实有问题的规则。
先分清事件、告警和故障
Flashduty 的模型可以简化为:
监控系统 → 事件 Event → 告警 Alert → 故障 Incident- 事件:监控系统推送的原始通知。一次触发、一次恢复、一次更新,都是事件。
- 告警:由事件触发。同一告警的触发、更新、恢复事件,合入同一条告警。
- 故障:处理的对象。相似告警聚合到同一故障,再统一分派、通知、认领、升级和关闭。
不开启降噪时,一条告警往往对应一个故障,值班人员面对大量独立故障。开启降噪后,相似告警进入同一故障。值班人员处理的是一个问题,而非一串通知。
先记录基线,再调整策略
降噪之前,先查看真实告警数据:
- 最近一周产生了多少故障?
- Critical、Warning、Info 各占多少?
- 哪些告警检查项和告警对象最频繁?
- 哪些通知发生在睡眠时间?
- 哪些告警从未被认领?
- 哪些故障关联了大量告警?
- 哪些服务经常触发后很快恢复?
Flashduty 的分析看板可以按团队、协作空间、个人等维度查看故障数据。指标包括故障数量、MTTA、MTTR、响应比例、响应投入和中断次数。时间维度可拆分为工作时间、休息时间和睡眠时间。全局维度可查看告警检查项和告警对象 TOP 20。
此时不必追求某个压缩率数字。先记录四组基线:
原始告警量:监控系统推送了多少事件和告警
故障数量:Flashduty 创建了多少需要处理的故障
通知打扰:短信、语音、App 推送造成了多少中断
响应效率:MTTA、MTTR、响应比例是否合理
每调整一类策略,都用这四组数据复查。否则,团队容易把“通知少了”误判为“治理好了”。
稳定的标签决定降噪效果
聚合、路由、静默和抑制都依赖标签。告警如果只有标题和描述,这些规则很难可靠生效。团队至少需要以下几类稳定标签:
| 标签 | 含义 | 主要用途 |
|---|---|---|
service | 业务服务或应用 | 路由到对应协作空间 |
resource | 告警对象,例如主机、实例、Pod、数据库 | 聚合同一对象的告警 |
check | 告警检查项,例如 CPU、磁盘、接口错误率 | 分析看板中的检查项 TOP |
env | 环境,例如 production、staging | 区分生产与测试 |
team | 负责团队 | 分派策略和责任归属 |
cluster 或 region | 集群、机房或地域 | 机房级抑制与聚合 |
Flashduty 的标签增强在告警进入时生成或修改标签。可以用正则从标题、描述或已有标签中提取,也可以组合生成新标签。映射表能把 ID 转换为可读值,不需要的标签可以删除。高级场景下,还能通过 API 映射查询外部系统,补充团队、服务等级等信息。
标签不稳定,降噪规则就难以维护。先规范上游告警字段,通常比写十条复杂正则更有效。
在集成层丢弃明显无价值的事件
有些事件不应进入响应链路。例如开发环境频繁重启的告警、已知无害的报错、压测产生的预期异常。这类事件进入协作空间后,会占用路由、聚合和分析资源,也会干扰治理判断。
Flashduty 的告警处理 Pipeline 位于集成层。它在标签增强之后、路由分发之前执行,常见用法有四种:
- 调整严重程度:例如把支付服务的 Warning 提升为 Critical,触发更强的通知。
- 重写标题或描述:把机器生成的标题改为业务语言,或追加 Runbook、Dashboard 链接。
- 丢弃告警:在入库前丢弃明确无价值的事件。
- 集成层抑制:在同一集成范围内处理全局依赖关系。
恢复事件(event_status=Ok)不经过 Pipeline,直接进入告警合并流程。设计流程时,不要假设 Pipeline 能丢弃、重写或抑制恢复事件。
Pipeline 规则作用于该集成接入的所有告警,与后续路由到哪个协作空间无关。因此,集成层只放全局共识明确的规则。只影响某个团队的策略,放到协作空间层处理。
用聚合把多条告警变成一个故障
聚合是处理告警风暴的主要手段。聚合不会隐藏告警。相似告警合入同一故障后,值班人员只处理一个故障。关联告警和原始事件仍可在详情中查看。
Flashduty 支持两种聚合模式:
- 智能聚合:适合快速起步。系统基于标题、描述、
labels.service、labels.resource等字段计算相似度,参与计算的字段可以调整。 - 规则聚合:适合需要精确控制边界的场景。只有指定属性或标签完全相同时才聚合。可以统一配置,也可以按条件为不同类型的告警配置不同维度。
两种模式的字段和分支数量都有上限,详见聚合配置限制。一个实用的起点如下:
基础设施告警:按 labels.resource + labels.check 聚合
应用告警:按 labels.service + labels.check + labels.env 聚合
Kubernetes 告警:按 labels.cluster + labels.namespace + labels.workload 聚合
数据库告警:按 labels.service + labels.resource + labels.check 聚合
标签尚不完整时,先用智能聚合快速降噪。误聚合风险较高时,再切换到规则聚合。
聚合窗口也要认真设置。关闭窗口时,新告警持续合入已有故障,直到故障关闭。开启窗口后,超出窗口的告警会产生新故障。窗口的计时起点可选“故障触发”或“告警合入故障”。后者在每次合入时重新计时,适合告警持续涌入的风暴场景。
聚合后仍然严重的故障,用风暴预警升级
聚合减少了重复通知,但聚合后的故障未必不严重。一个故障持续合入大量告警,往往说明影响范围在扩大。
Flashduty 的风暴预警处理这种情况。合入告警数达到阈值时,系统在故障时间线中记录风暴事件,并发送预警通知。风暴预警适合作为二次升级信号,例如:
- 合入 20 条告警时,提醒当前值班人员确认影响范围。
- 合入 100 条告警时,升级给团队负责人。
- 合入 500 条告警时,进入重大故障响应流程。
这些阈值不宜照搬。基础设施、应用、Kubernetes 和云服务的告警密度各不相同。应先查看过去两周同类故障的关联告警数,再设定阈值。
反复触发和恢复,用抖动检测与延迟窗口
网络短暂波动、接口偶发超时、节点压力临界和采集不稳定,都会造成抖动。同一故障因此反复触发和恢复。每次都像新问题,最消耗值班人员的精力。
Flashduty 的抖动检测会把频繁触发与恢复的故障标记为抖动。新建协作空间默认开启,模式为“仅提醒”。默认在 60 分钟内状态变化 4 次即判定为抖动。“提醒后静默”模式下,默认静默 120 分钟。
建议先使用“仅提醒”,观察哪些告警经常被标记为抖动。确认属于短时波动后,再对这些类型开启“提醒后静默”。一开始就静默所有抖动,可能掩盖故障反复恶化的信号。
分派策略中的延迟窗口可以配合使用。延迟窗口在首次通知前等待一段时间。故障在等待期内关闭,就不再发送通知。对容易自愈的网络超时和瞬时抖动,适当延迟比立即打电话更合理。
维护窗口和已知问题,用静默
静默适用于“已知且暂时无须通知”的告警。典型场景有计划维护、批量发布、压测和数据迁移。硬件更换、定期重启和已知问题的修复窗口也属于此类。
Flashduty 支持单次静默、周期静默和基于服务日历的静默。匹配条件包括严重程度、标题、描述、集成来源和标签,支持 AND/OR 组合。命中后可以直接丢弃,也可以保留并标记为静默。
建议优先选择“保留标记”。直接丢弃更安静,但排查时缺少信息。保留标记后,团队能看到静默规则命中了什么,复盘时也能判断静默范围是否过大。
处理人还可以在故障详情中选择“更多操作 → 快速静默”,创建临时规则。规则默认生效 1 天,到期自动删除。对同一故障重复操作时,系统编辑原规则,而非新建重复规则。
静默必须设置过期时间。临时问题不应变成永久规则。
根因和派生告警,用抑制
机房网络故障时,下游主机、数据库、应用和接口都会告警。需要优先处理的是机房网络,其余是派生告警。把派生告警全部推给人,根因反而更难被发现。
Flashduty 的抑制策略在根因告警存在时,自动抑制相关的次要告警。典型例子是:存在 Critical 故障时,抑制同一检查项的 Warning 和 Info。抑制条件由三部分组成:
- 新告警条件:哪些告警会被抑制,例如 Warning 和 Info。
- 活跃告警条件:哪些告警作为抑制源,例如 Critical。
- 相同项:两者必须相同的属性或标签,例如检查项、主机名。
抑制要求 10 分钟内存在满足条件的活跃告警。活跃告警的判定规则见抑制策略文档。
抑制可以配在协作空间,也可以配在集成层。集成层的 Pipeline 抑制只匹配同一集成内的活跃告警,适合全局逻辑。例如机房断网后,抑制该机房的所有告警。协作空间抑制匹配本空间内的所有活跃告警,适合团队自己的依赖关系。
抑制需要写清楚源告警、目标告警以及二者相同的维度。这比把 Warning 全部静默更安全。
按场景选用手段,丢弃放在最后
协作空间的排除规则和 Pipeline 的丢弃,都会在入库前丢掉事件,不留任何记录。静默和抑制则仍在告警层处理,命中的告警只是不发通知。选择“保留标记”时,事后还能在告警列表中查看。
各手段的适用场景如下:
| 场景 | 手段 |
|---|---|
| 明确无价值且无须审计的事件 | 排除规则或 Pipeline 丢弃 |
| 维护窗口、已知问题 | 静默 |
| 根因存在时的派生告警 | 抑制 |
| 相似告警集中出现 | 聚合 |
| 反复触发和恢复 | 抖动检测和延迟窗口 |
丢弃是最后的手段。安静不等于可靠。
一套可复用的降噪配置模板
可以从下面的最小模板开始:
标签增强:
- 提取 service、resource、check、env、team
- 用映射表补齐 team 或 service_name

Pipeline:
- 丢弃 dev/test 环境中无处理价值的告警
- 重写标题,保留服务、资源、检查项和环境
- 对核心服务的特定 Warning 提升为 Critical

聚合:
- 基础设施:resource + check
- 应用服务:service + check + env
- 数据库:service + resource + check

抖动检测:
- 先使用仅提醒模式
- 对确认自愈的短时波动开启提醒后静默

静默:
- 维护窗口使用单次静默
- 定期任务使用周期静默
- 优先保留标记,避免完全无记录

抑制:
- Critical 存在时,抑制同一 service/resource/check 下的 Warning/Info
- 机房或集群级故障在集成层处理

风暴预警:
- 为高频故障设置 2 到 3 个阈值
- 阈值命中后进入升级或重大故障流程

验证:
- 每周看故障数量、中断次数、MTTA、MTTR、响应比例和告警 TOP
模板只是起点。各团队的监控源、标签质量、服务边界和值班方式都不同。有效的策略必须来自真实告警数据。
用四组数据验收降噪效果
第 13~14 天,对照基线比较以下几项:
- 故障数量是否下降。
- 中断次数是否下降,尤其是睡眠时间。
- Critical 告警的 MTTA 是否稳定或缩短。
- Warning 和 Info 是否退出了强通知。
- 告警检查项 TOP 20 是否集中在少数规则。
- 值班人员是否更容易判断当前要处理的故障。
判断方法如下:
- 通知减少了,但 Critical 的 MTTA 变长:降噪过度。
- 故障数量下降,但告警 TOP 仍集中在少数检查项:需要回到监控侧调整规则。
- 中断次数下降,MTTA 和 MTTR 没有恶化,值班人员定位更快:降噪开始产生价值。
Flashduty 不替代监控系统。它在 Prometheus、Zabbix、Nightingale、Grafana、云监控和自研系统之后建立响应层。监控系统负责发现异常,Flashduty 负责把异常转为可处理的故障,并减少不必要的打扰。
如需开始 14 天实验,可以登录 Flashduty 控制台创建协作空间。